
 语音小管家
题目:《Advances in Speech Separation: Techniques, Challenges, and Future Trends》
01、引言:从“鸡尾酒会问题”说起
02、问题定义:语音分离到底要做什么?
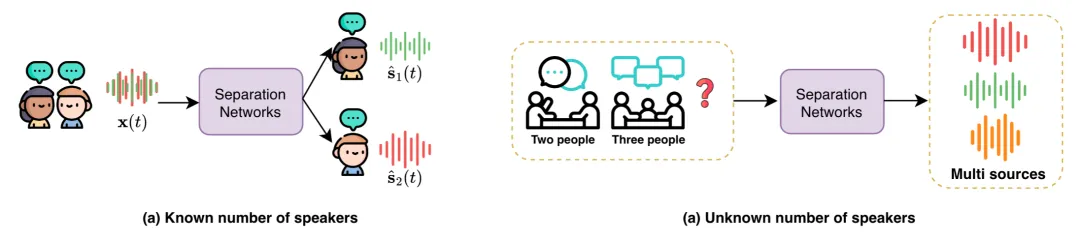
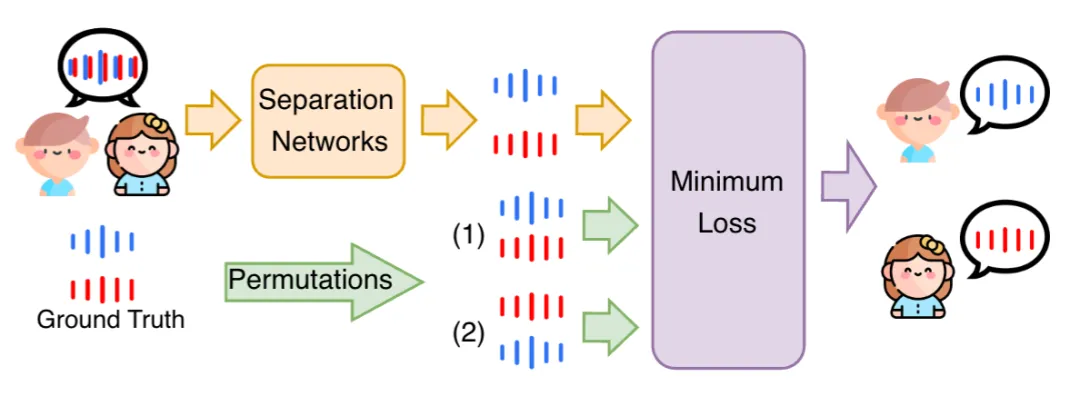
已知说话人数量:比如确定是2个人说话,模型输出固定C个通道。关键要解决“排列歧义”——模型输出的1号通道可能对应真实的2号说话人。常用方法是深度聚类(把时频单元聚到一起)或PIT(训练时试所有排列,选损失最小的)。 未知说话人数量:比如会议里说话人随时进出,难在动态调整输出通道数和判断“什么时候停”。比如OR-PIT用递归方法,每次拆一个说话人,再处理剩下的信号;还有多解码器模型,用分类器选最优输出数量,但容易出现“拆少了”(漏说话人)或“拆多了”(把噪声当说话人)的问题。
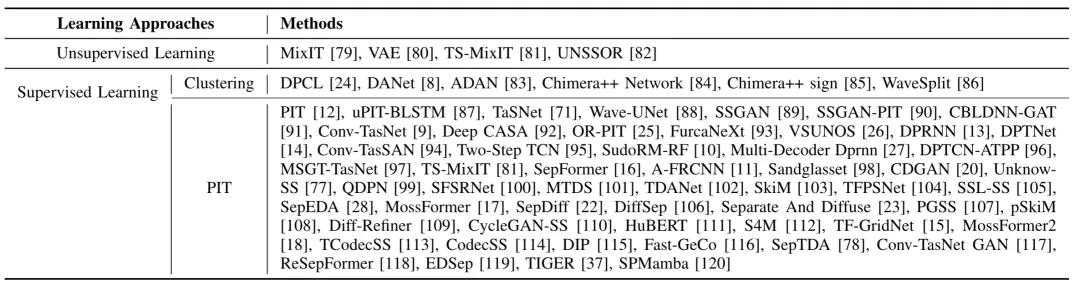
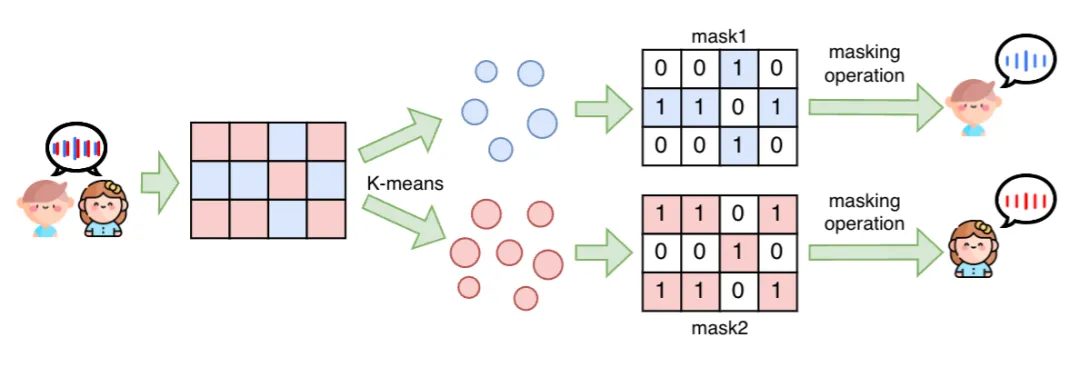
03、学习范式:无监督vs监督,各有什么门道?
04、模型架构:编码器、分离器、解码器的门道
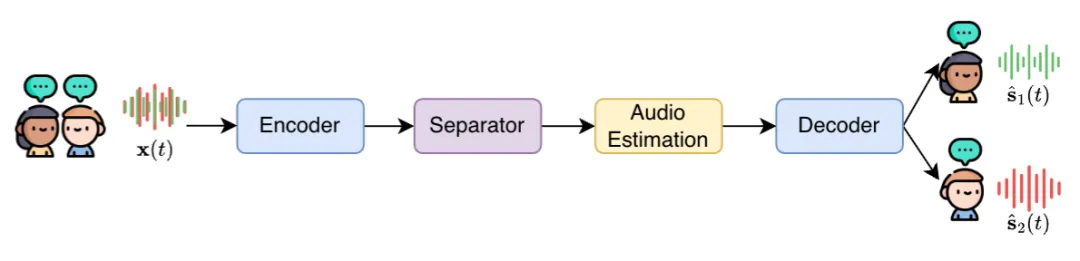
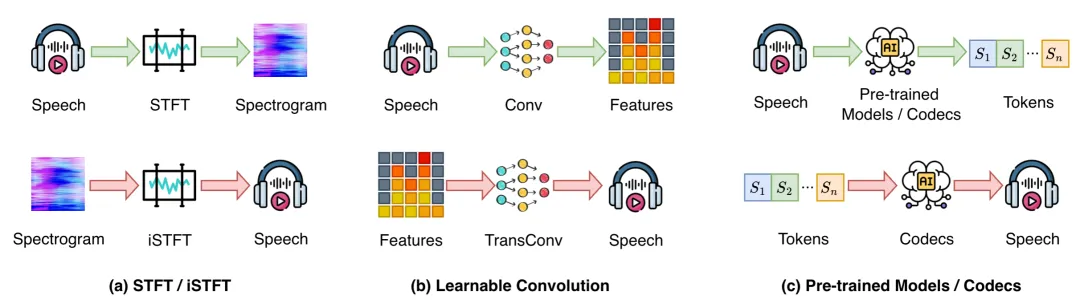
STFT/iSTFT:传统操作,把时域转成时频图(比如STFT),优点是物理意义清楚,能结合传统信号处理,但STFT是固定的,时频分辨率受窗函数限制,而且重构时相位难处理(常用Griffin-Lim算法估相位,会损失质量)。 可学习卷积:比如Conv-TasNet用1D卷积做编码器,直接处理时域波形,解码器用转置卷积还原。好处是端到端优化,能学最适合分离的特征,不用管相位问题,但学的特征没物理意义,解释性差,需要更多数据。 预训练模型/神经编解码器:近年新趋势,比如用Wav2Vec 2.0、HuBERT的编码器提特征(这些模型在大规模无标注数据上预训练过,能抓语音的深层信息);或者用EnCodec、SoundStream这类神经编解码器,把音频压成低比特率的embedding,分离后再解码。优点是鲁棒性强(抗噪声、混响),但预训练模型参数量大,部署难,而且预训练任务和分离任务目标可能不匹配,需要微调。
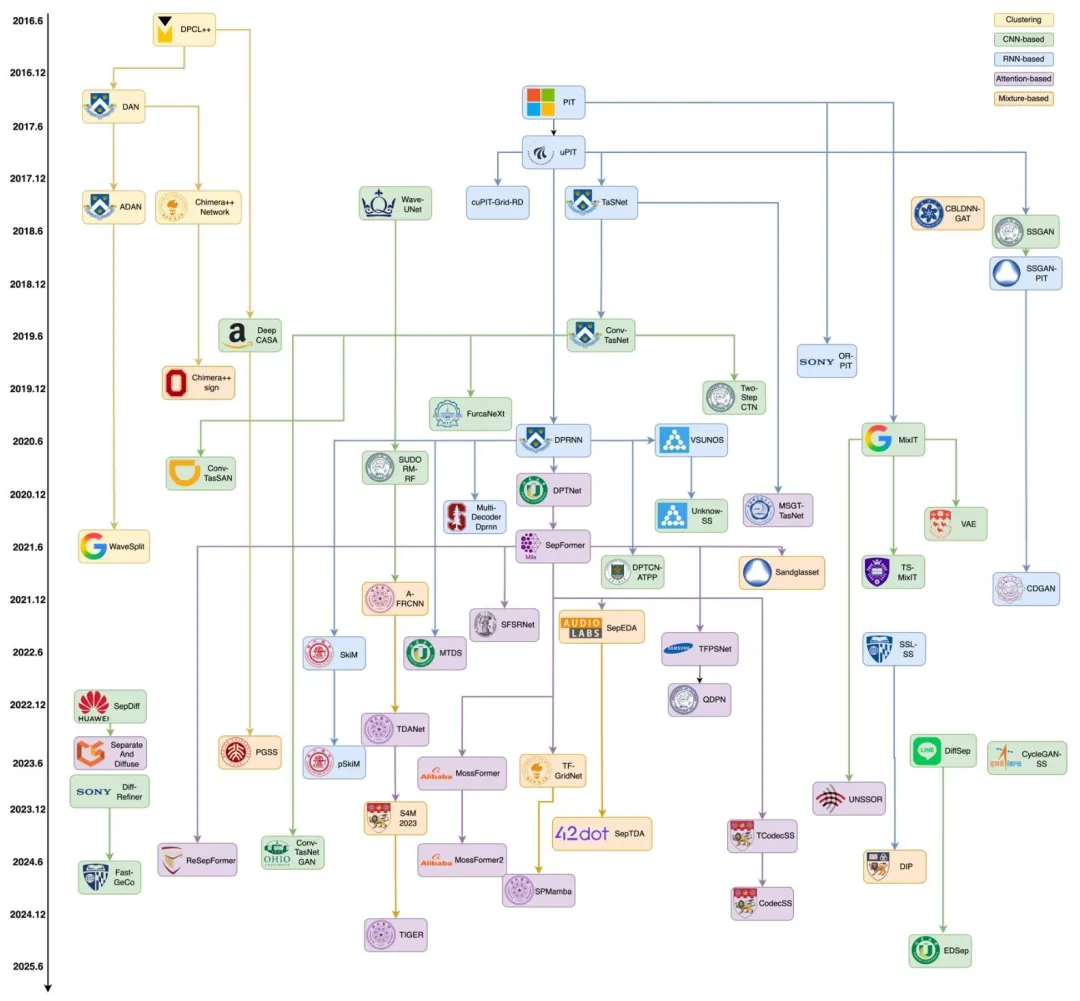
RNN-based:靠RNN(尤其是LSTM、GRU)抓时序依赖,适合语音这种时序数据。但普通RNN有梯度消失问题,长音频处理不了,而且是串行计算,慢。后来改进的DPRNN(双路径RNN)把长序列切成小块,先处理块内(intra-chunk),再处理块间(inter-chunk),解决长依赖;SkiM加了“跳过记忆”机制,减少75%计算量,还不丢性能。 CNN-based:靠卷积抓局部特征,并行计算快,适合时域端到端模型(比如Conv-TasNet)。常用膨胀卷积扩大感受野,抓长时序信息;还有U-Net类模型(比如Wave-U-Net),编码器下采样提特征,解码器上采样还原,加跳跃连接保细节。但CNN的感受野有限,长音频的全局依赖抓不好,而且上采样容易出失真。 Attention-based:Transformer的自注意力机制能抓全局依赖,比如SepFormer用双路径Transformer(块内+块间),处理长音频;MossFormer用“门控单头注意力+卷积增强”,兼顾局部和全局。但自注意力复杂度是O(n²),n是序列长度,长音频直接扛不住,所以现在都用分组注意力、稀疏注意力减计算。 混合架构:把几种结构拼一起,比如TF-GridNet结合“帧内频谱模块”“子带时序模块”“全频注意力模块”,还加了能量守恒损失,保证分离后的声音能量和混合前一致;A-FRCNN用异步更新,结合上下左右的特征,压缩参数量还提性能。但混合架构参数量大,训练复杂,比如GAN类混合模型容易模式崩溃。
05、评估指标:怎么判断分离得好不好?
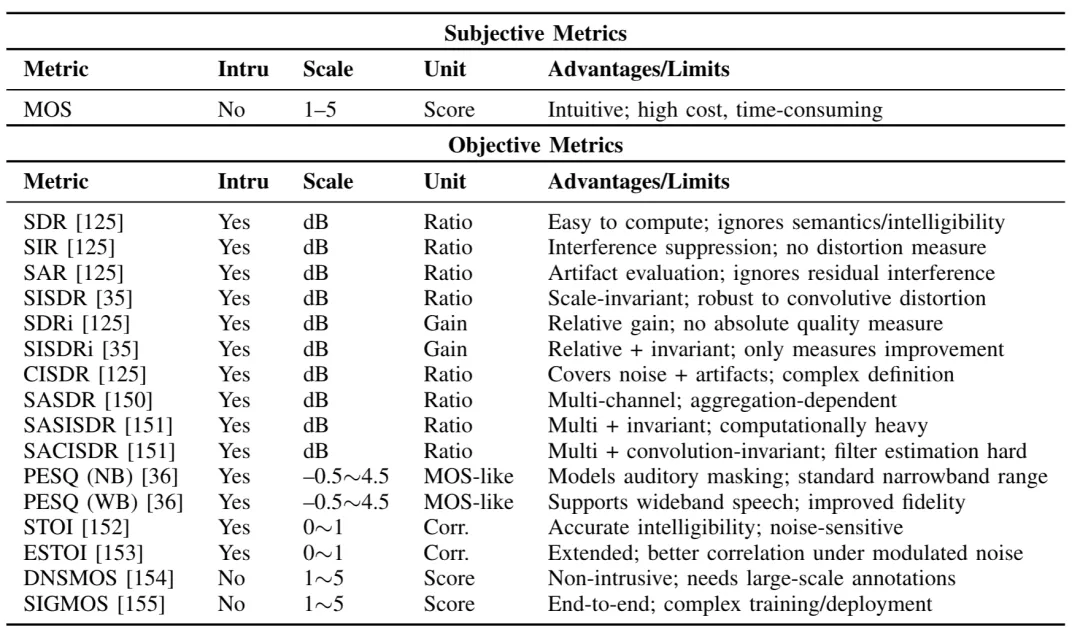
信号级指标:SDR(信号失真比)、SIR(信号干扰比)、SAR(信号 artifact 比),SDR越高说明分离后目标信号越纯,但SDR对信号缩放敏感,所以有SI-SDR(尺度不变SDR),还有SDRi(SDR提升量),看分离前后的改善。 感知级指标:PESQ(语音质量感知评估),模拟人耳听觉,分数-0.5到4.5;STOI(短时客观可懂度),预测语音能不能听懂,0-1之间。还有ESTOI(增强版STOI)、DNSMOS(无参考的MOS,不用干净语音,直接评分离后的声音)。 论文建议:报告结果时最好组合着来——SI-SDR(或SI-SDRi)看分离精度,SDR做兼容,PESQ看音质,STOI看可懂度,这样能全面评价。
06、数据集:训练和测试的“弹药”
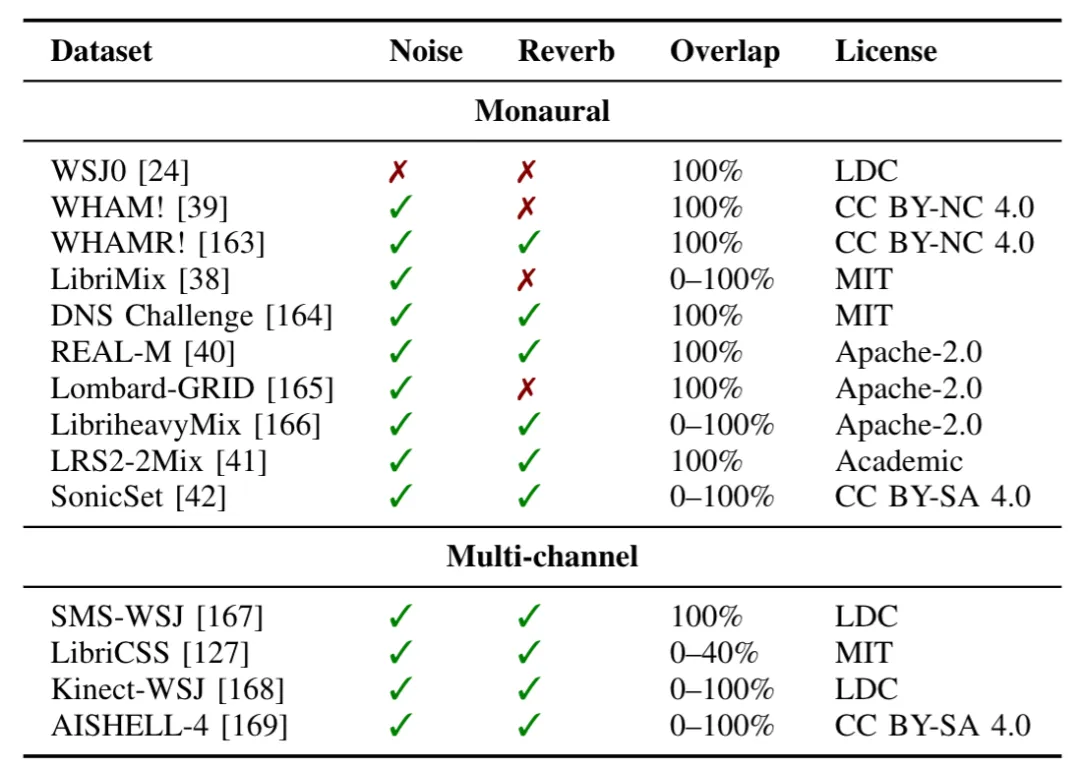
干净场景:WSJ0-2mix(2个说话人混合,干净无噪声),但说话人少(101个)、词汇有限,泛化差;LibriMix用LibriSpeech的1252个说话人,还加了稀疏重叠(模拟真实对话里不是全程重叠),更实用。 复杂场景:WHAM!(WSJ0加真实噪声)、WHAMR!(WHAM!加混响);REAL-M是真实录制的混合语音(50个说话人,用电脑、手机录,有近场远场、噪声混响);LRS2-2mix从BBC节目里切的,有各种口音和环境变化;SonicSet模拟移动声源(3D场景里声音移动,加混响)。
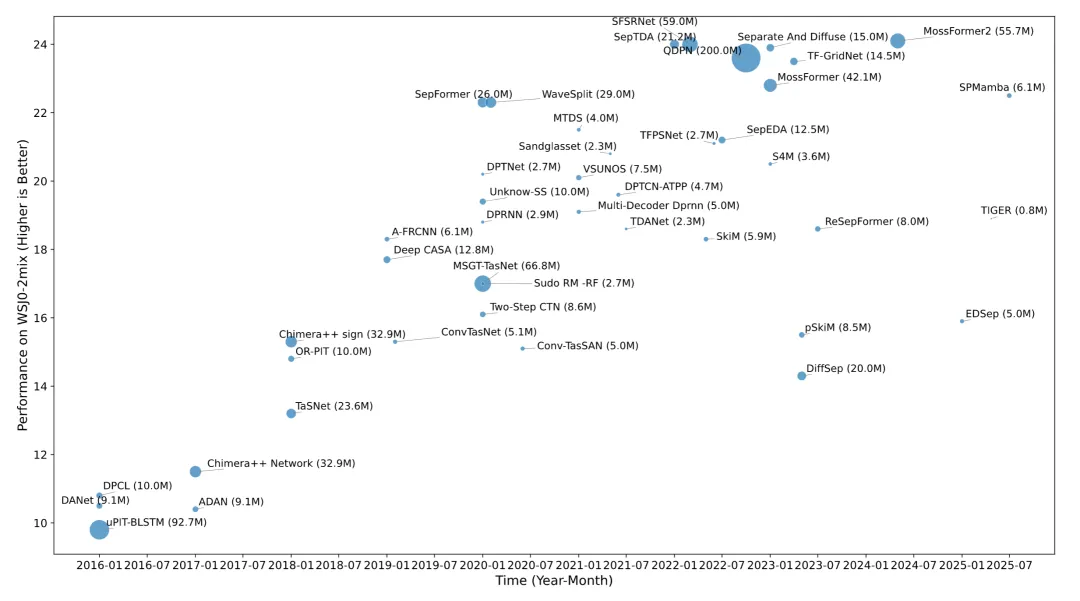
07、实验结果:哪些模型真的能打?
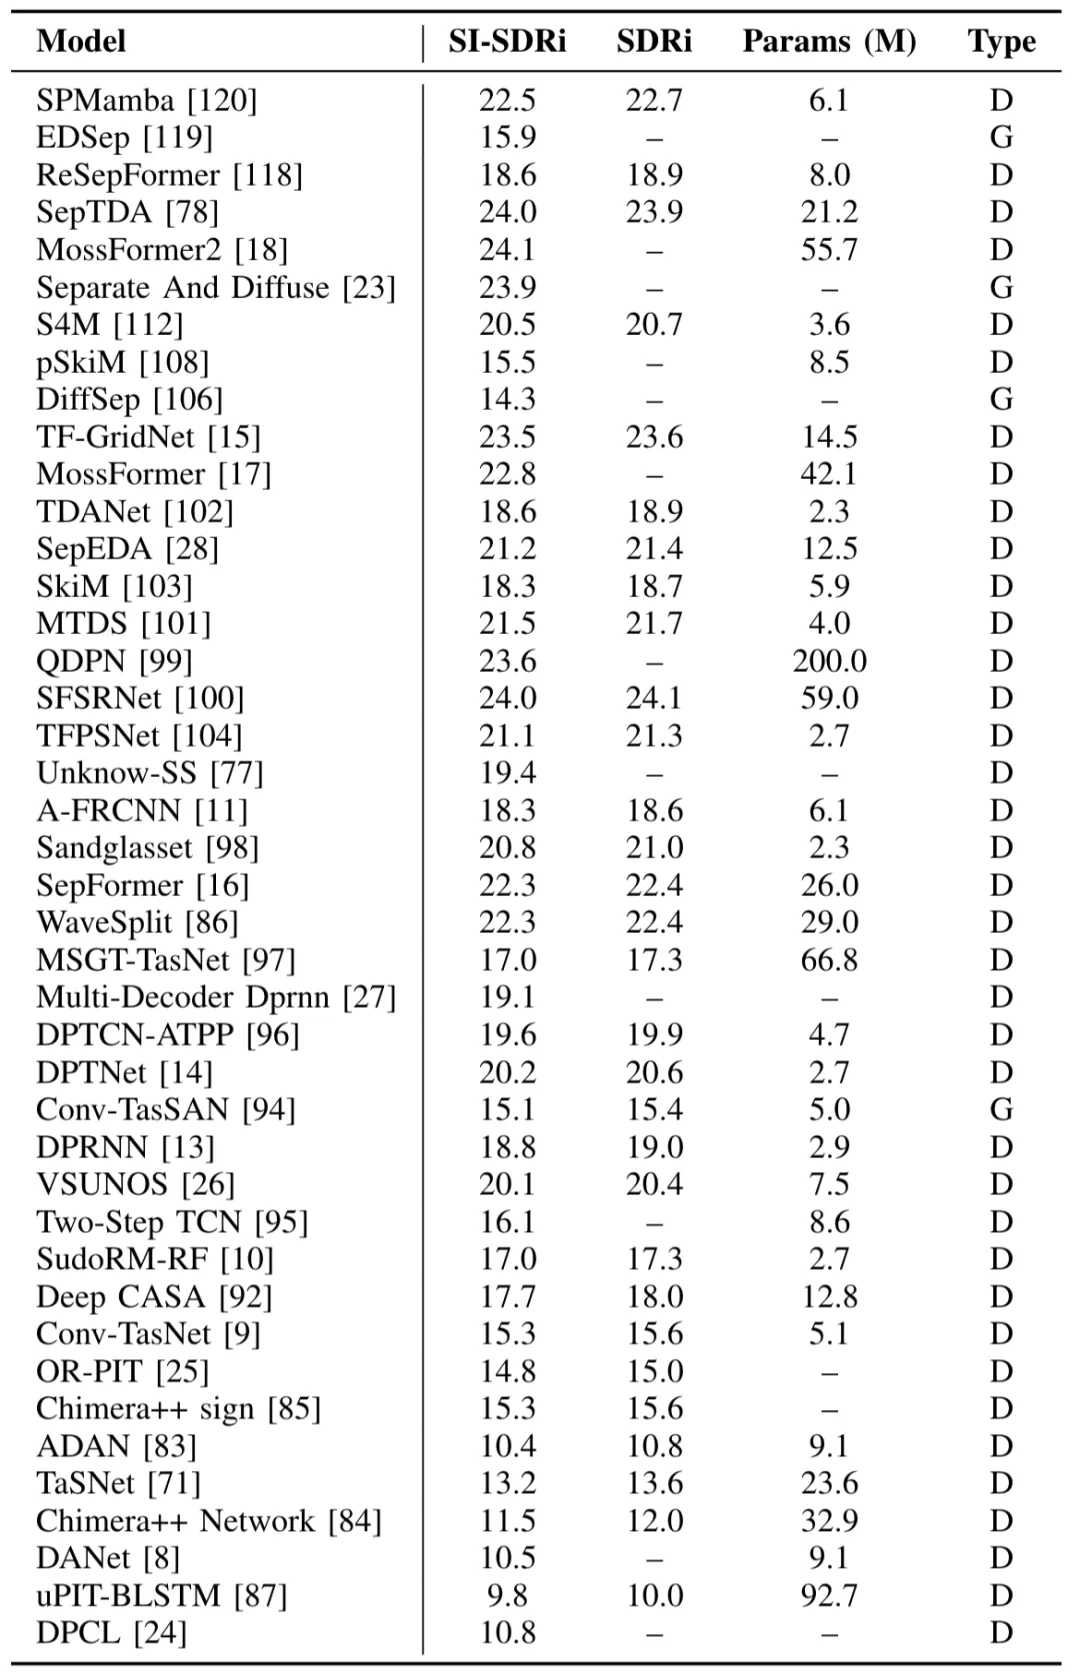
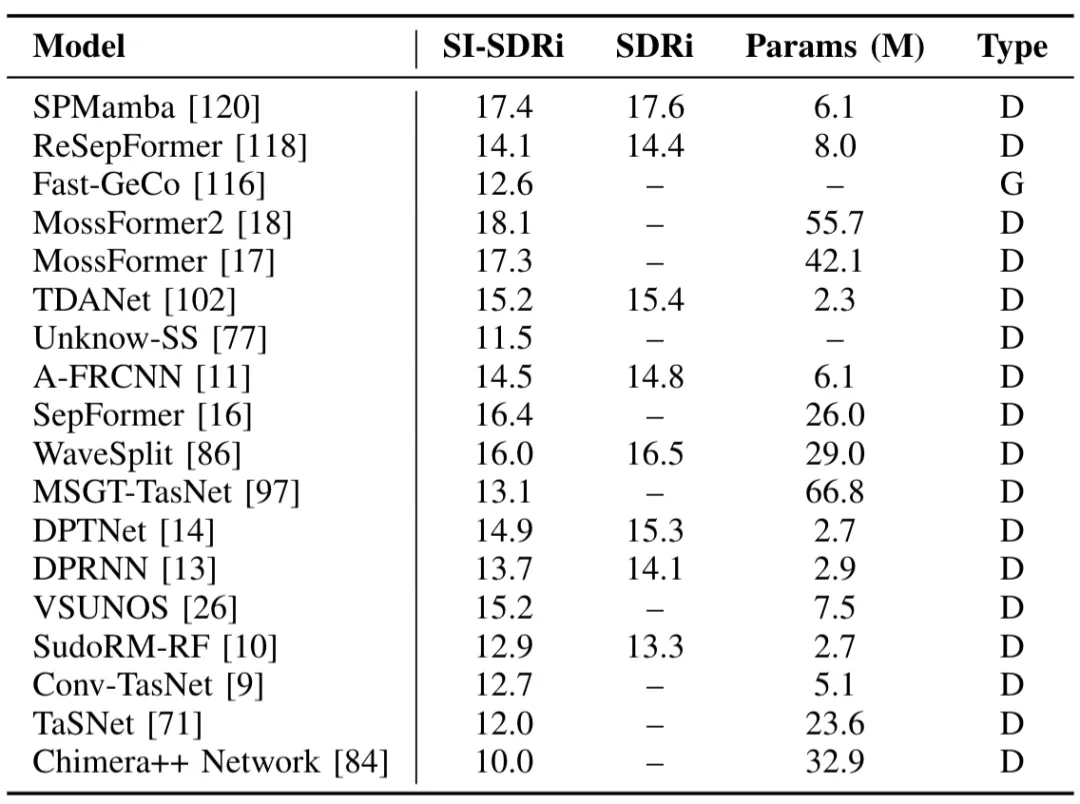
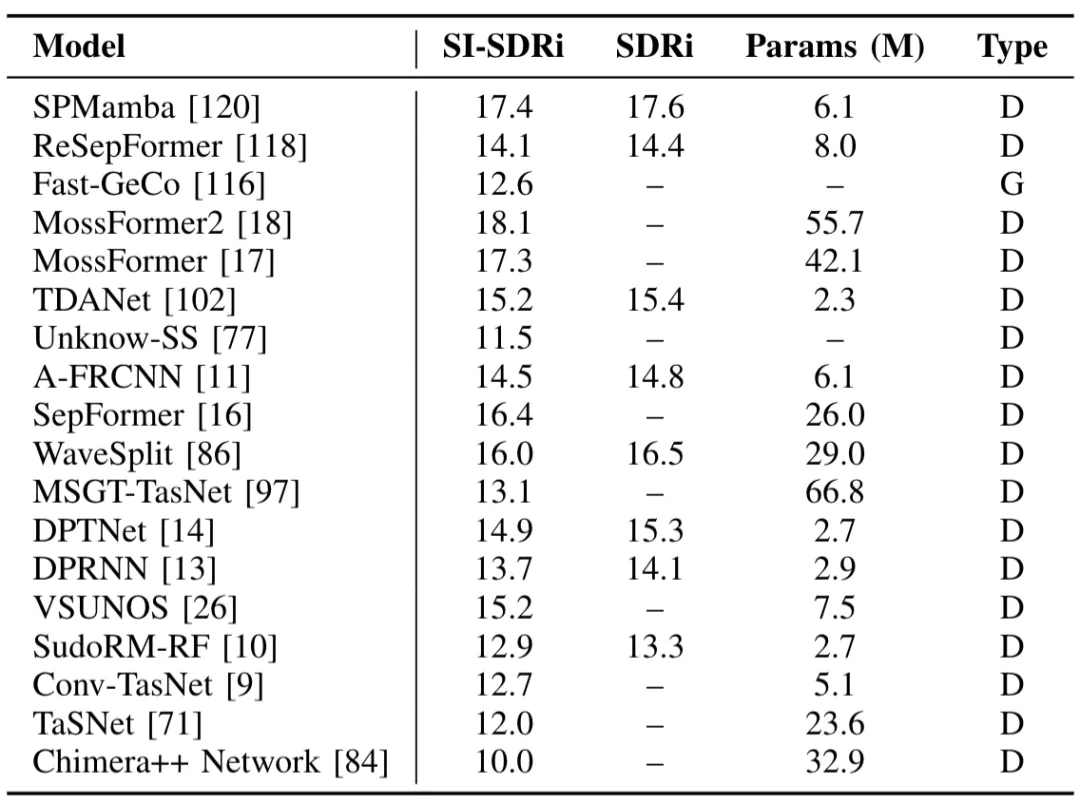
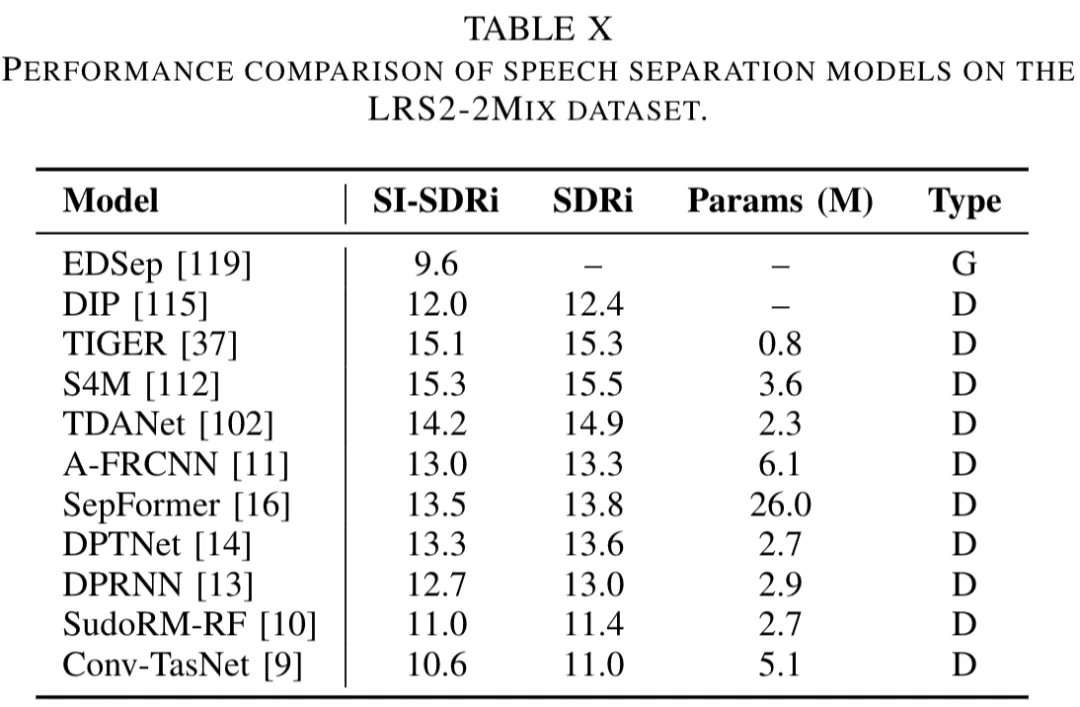
08、工具平台:研究者常用的“脚手架”
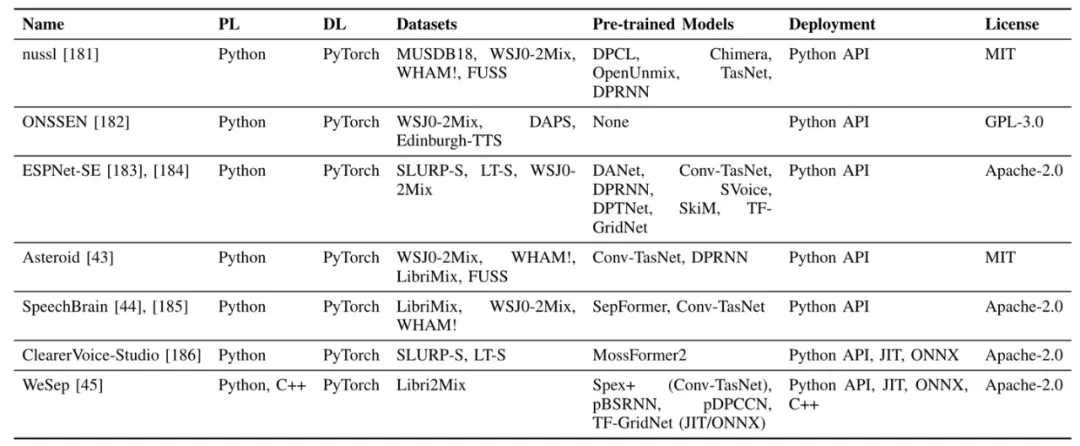
Asteroid:专注单通道语音分离,有Kaldi风格的脚本,能复现经典论文结果,新手友好。 SpeechBrain:通用语音工具,除了分离,还支持ASR、说话人识别,有动态混合训练(训练时实时生成混合语音,不用预生成数据集)。 ESPNet-SE:把分离和ASR结合,支持多任务联合训练,适合做“分离+识别”的端到端系统。 WeSep:专门做目标说话人提取(TSE),能结合说话人embedding,还支持模型导出(JIT/ONNX),方便部署。 nussl:早期工具,覆盖传统方法和DNN方法,侧重评估和数据管理。
09
长音频处理:比如几小时的会议录音,Transformer的自注意力O(n²)复杂度扛不住,现在用双路径、稀疏注意力,但还得优化实时性。 轻量模型:助听器、手机这些设备资源有限,需要小参量模型,比如SPMamba用状态空间模型减计算,TIGER分时频子带处理,但轻量和性能的平衡还得调。 因果分离:实时场景(比如电话通话)不能看未来帧,得用单向RNN、因果卷积,但没了未来信息,性能会降,怎么在低延迟和高性能间找平衡是关键(对应图10,因果架构的示意图)。 生成式方法:GAN、扩散模型能生成更自然的声音,比如SepDiff用扩散模型做分离,比传统判别模型少artifact,但扩散模型采样慢,需要优化推理速度。 预训练与神经编解码器:用Wav2Vec 2.0、EnCodec提特征,能缩小合成数据和真实数据的差距,但预训练模型太大,怎么高效迁移到分离任务还得研究。 目标说话人提取(TSE):不只是拆所有说话人,而是指定某个人(比如用他的锚定语音),现在用音频+视觉(lip动)的多模态方法效果好,但视觉数据不好获取,还得优化。 和下游任务联合建模:比如分离+ASR+说话人分割,一起优化能减少误差累积,但多任务损失怎么平衡、计算量怎么减,都是问题。
10、结 论
