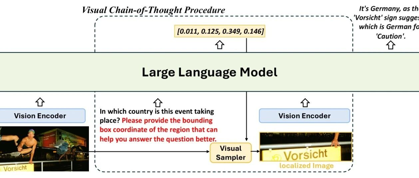
【交我学-43】多模态模型的“思考”方式:视觉、通用音频与语音的 CoT 技术路线

大家好,欢迎来到「AudioCC交我学」专栏! 在文本大模型中,思维链(Chain-of-Thought,CoT)通常意味着模型先写出若干推理步骤,再给出答案。一旦输入变成图像、环境声或连续语音,关键问题就从“是否逐步推理”进一步转向“用什…
1 0 0

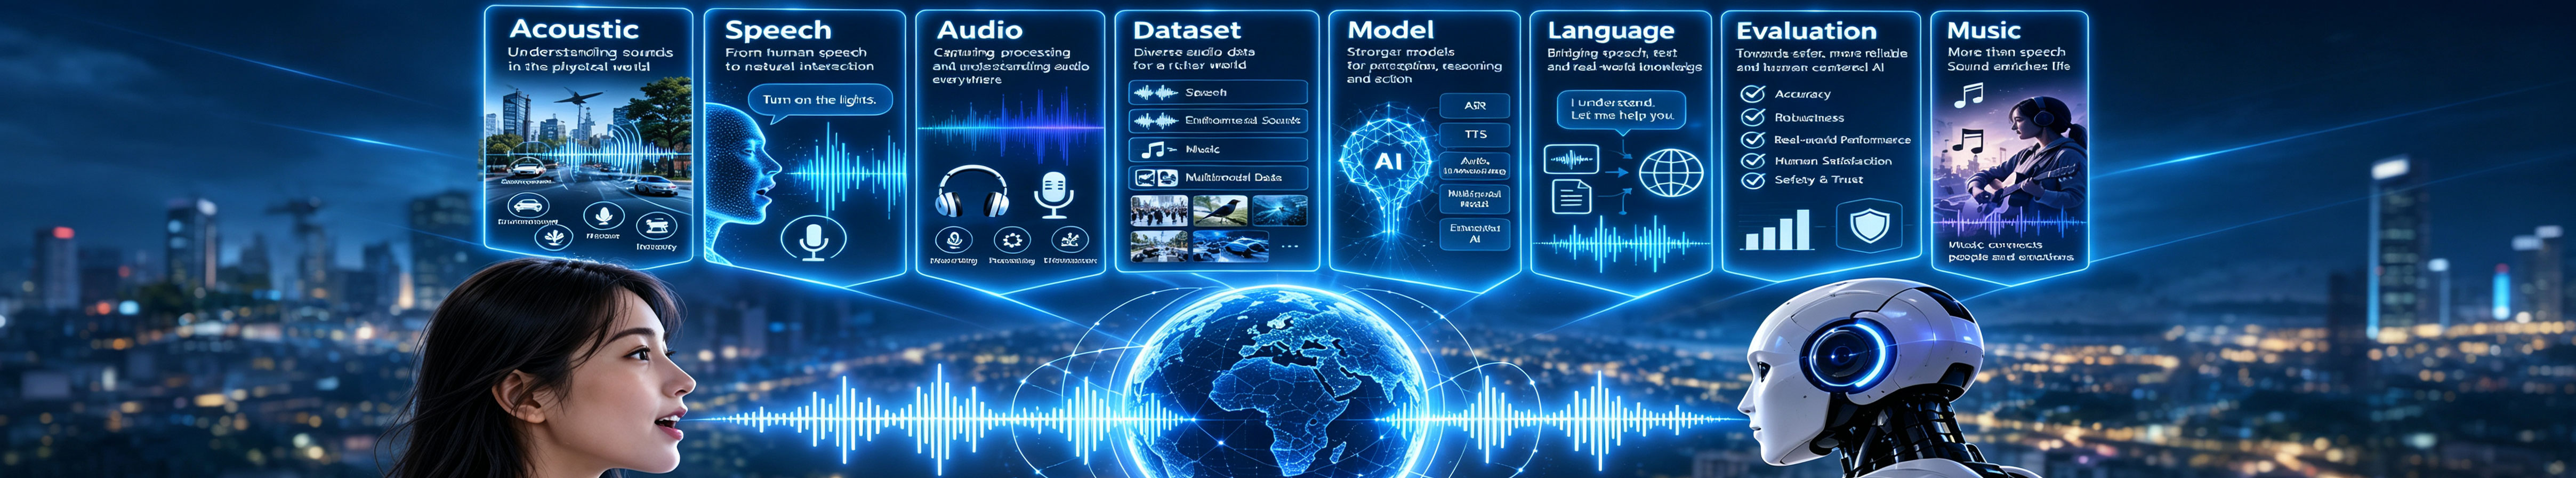
大家好,欢迎来到「AudioCC交我学」专栏! 在文本大模型中,思维链(Chain-of-Thought,CoT)通常意味着模型先写出若干推理步骤,再给出答案。一旦输入变成图像、环境声或连续语音,关键问题就从“是否逐步推理”进一步转向“用什…
Cactus Compute 发布开源语音识别模型 Whistle,面向手机、可穿戴设备、机器人、汽车和微控制器等端侧设备。 模型文件仅 16.9MB,直接在 CPU 上运行,并与其端侧工具调用模型 Needle 共用同一套 C++ 推理引…
今日论文合集:CS.SD语音与音频 共 15 篇,本文展示前 8 篇 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音合成…
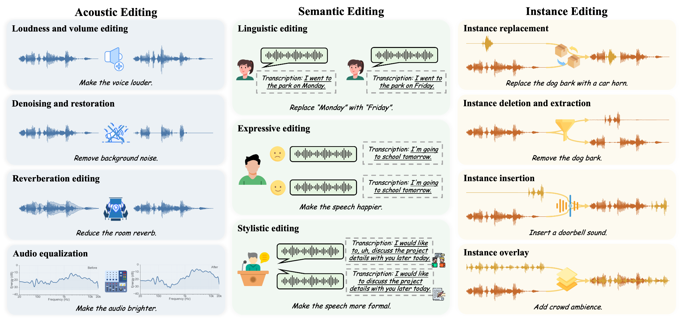
把录音里说错的一个词改过来,让一句话的语气更轻松,或者去掉背景中的狗叫声,同时保留原本的人声和环境声——这些看似简单的要求,正是音频编辑需要解决的问题。 随着音频生成模型的发展,用文字描述一段声音并让模型生成出来,已经有了不少可行方案。但面…
今日论文合集:CS.SD语音与音频 共 14 篇,本文展示前 8 篇 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别…
声学智能的前沿探索与青年力量 当语音技术不再只是“听清楚、说出来”,当声音开始与大模型、多模态智能、医疗健康、脑科学、低资源语言深度交叉,我们正在进入一个更加丰富的声学智能时代。 从低码率语音编解码、语音增强与合成,到音频推理、副语言表达与…
今日论文合集:CS.SD语音与音频 共 18 篇,本文展示前 8 篇 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别…
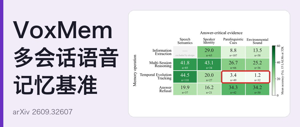
语音助手正在从“一问一答”走向跨越多次会话的长期交互。用户上周提过的计划、某位家庭成员说过的话、某次对话时的语气,都可能在之后被问起。但语音里的信息远不止文字:谁说的、怎么说的、背景里有什么声音,都只存在于音频信号里,一旦转成文字就丢失了。…
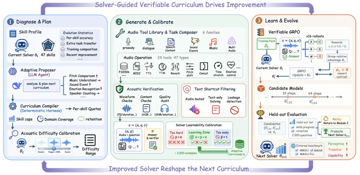
同一句话播放两遍,内容一模一样,只是第二遍音调更高,让它挑出音调更高的那一遍。能把语音转写准确的模型,未必答得好这样的题。类似的问题还有:一段对话里有几位说话人?一段音乐的节奏有没有加快?这些任务都在提醒我们:知道“说了什么”,不等于听懂声…
今日论文合集:CS.SD语音与音频 | 共 12 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音合成与声音生成 1…
