
 语音小管家
Edge0 发布 Audio8-ASR-Infinite 预览版,面向中英文实时语音识别,提供 80、120 和 160ms 三档流式音频时钟,并可将转写延迟配置在 240–560ms。
模型原生上下文为 30 秒,但通过滚动 KV 缓存持续淘汰旧状态,可在内存占用和推理延迟不随音频时长增长的情况下连续运行,用于会议、实时字幕和长期监听等持续转写场景。
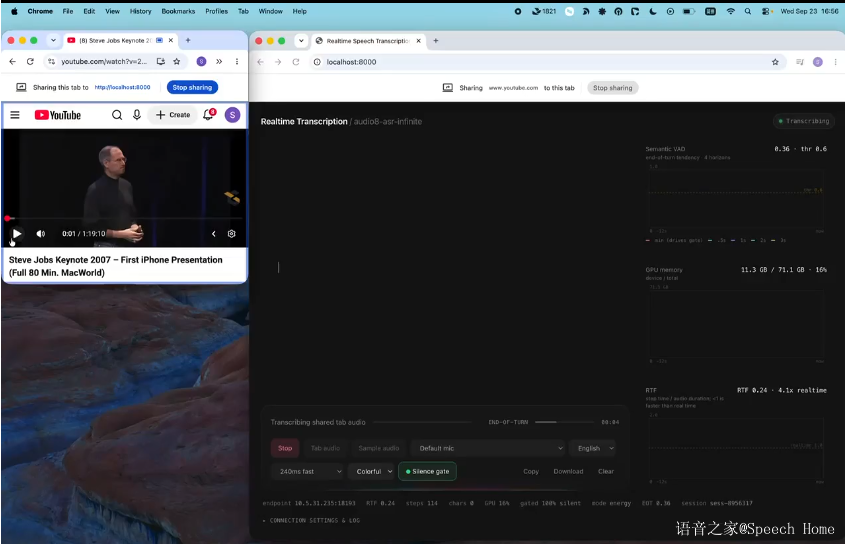
- 流式粒度与延迟可以分别调节: 80ms 模式下模型每秒进行 12.5 次文本决策,120ms 和 160ms 分别为 8.3 和 6.25 次;开发者可以再单独设置目标转写延迟,在响应速度、识别效果和计算开销之间取舍。
- 30 秒滚动 KV 窗口支持不限时长输入: 推理时只保留固定长度的 KV 状态并重新校正位置编码,因此持续运行时缓存不会随对话长度不断增长。官方适配的 vLLM 推理实现支持 24/7 连续转写。
- 同时加入语义 VAD: 模型提供 0.5、1、2 和 3 秒多个预测时间范围的语义 VAD,可区分思考停顿、结巴与真正的对话结束,为实时语音 Agent 判断用户是否说完提供额外信号。
📎相关地址:
