InterSpeech 2026|TF-MoE:面向低算力语音分离的时频专家混合模型

本期将介绍上海交通大学听觉认知与计算声学实验与 Microsoft Research Asia 合作完成的论文 TF-MoE: Time-Frequency Mixture-of-Experts for Efficient Speech S…
37 0 0

本期将介绍上海交通大学听觉认知与计算声学实验与 Microsoft Research Asia 合作完成的论文 TF-MoE: Time-Frequency Mixture-of-Experts for Efficient Speech S…
基于神经网络的方法使语音分离技术取得显著进步,在信号层面的指标上表现更佳。然而,这些方法往往难以在分离信号中保持语音可懂度,这会对语音识别等下游任务的性能产生负面影响。本文提出SLM-SS方法,通过将语音语言模型应用于语音分离,旨在提升分离…
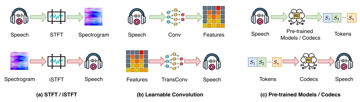
题目:《Advances in Speech Separation: Techniques, Challenges, and Future Trends》 地址:https://arxiv.org/pdf/2508.10830 先从摘要说起…
随着深度学习在语音处理领域的不断突破,多说话人语音分离与识别(Multi-talker Speech Separation & Recognition)已成为推动“鸡尾酒会问题”解决的研究热点。然而,现有方法尽管在性能上取得了一定进展,却仍…
在复杂声学环境中实现多说话人分离是音频信号处理领域的一项重大挑战,尤其是在存在强混响和背景噪声的低信噪比条件下。澳大利亚国立大学与莫拉图瓦大学的研究团队提出了一种基于相对传递矩阵(ReTM)的创新方法,实现了多说话人在混响房间中的有效分离。…
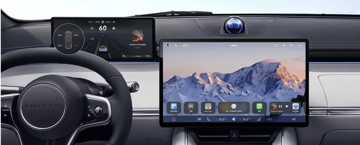
近年来,深度学习的迅猛发展推动了语音识别、语音增强和说话人识别等技术的显著进步,极大改善了人机交互体验。随着声控智能设备的不断演变,对更自然、便捷的交互方式的需求日益增加。在众多应用场景中,人车语音交互作为人机交互的一种形式,尤其受到关注。…
声加科技 北京声加科技有限公司成立于2018年1月,专注于通信声学核心技术,已先后通过中关村高新技术企业认证和北京市高新技术企业认证。为B端客户提供复杂场景下的近场、中场、远场语音交互技术方案,以及从芯片、模组、PCBA到工业设计的一站式产…
声加科技 北京声加科技有限公司成立于2018年1月,专注于通信声学核心技术,已先后通过中关村高新技术企业认证和北京市高新技术企业认证。为B端客户提供复杂场景下的近场、中场、远场语音交互技术方案,以及从芯片、模组、PCBA到工业设计的一站式产…
链接:https://github.com/pyannote/pyannote-audio pip install pyannote.audio
