
 语音小管家
近日,蚂蚁集团-大安全机器智能-AI身份智能团队,推出基于混合专家机制(MoE)的声纹识别模型 MECT(Mixture of Experts CNN-Transformer),首次将 MoE 机制引入全监督训练说话人识别领域。在权威基准 VoxCeleb 上,MECT 以仅 9.57M 参数的轻量级架构,全面超越 ECAPA-TDNN、ResNet及其变种、CAM++、ReDimNet2 等经典模型,甚至优于基于大规模预训练模型 W2V-BERT 2.0方案,在 Vox1-O/E/H 三个测试集上取得 minDCF 0.012/0.026/0.048 的 SOTA 性能。
同时,MECT 首次实现低延时声纹流式推理能力——在 100ms 的低延迟下仍保持高精度声纹特征提取,赋能高实时交互场景下的身份核验。
目前,MECT 已深度应用于蚂蚁集团 AI 声纹核身支付业务,支持智能眼镜、车机、耳机及手机等泛终端设备的身份核验。论文中算法代码和模型权重已开源,相关论文已投稿ICASSP2027:
GitHub:https://github.com/ant-research/AntSpeaker
HuggingFace: https://huggingface.co/AntResearch/AntSpeaker
论文:https://arxiv.org/abs/2609.24061
模型方案
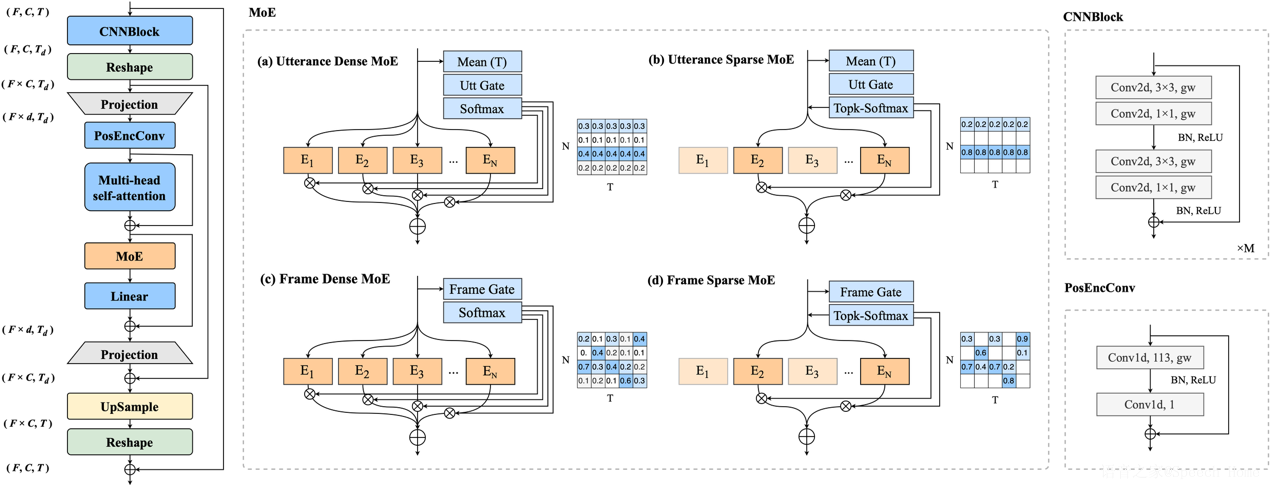
图 1 MECT Block 结构
⏩做了哪些结构优化来构建MECT的基础模块?
如图1所示,MECT 的基础模块由 CNN 和带有 MoE 的 Transformer 组成,二者通过 ReDimNet2 中的 Reshape 和时域池化方式连接。除此之外,与 ReDimNet2 相比,团队的模块设计还有以下重要的改进以提升模型性能:
1.残差连接方式:CNN 采用 ResNet block,但不同于经典做法的是,团队将 Shortcut 放在 BatchNorm 和 ReLU 之后,在实验中这一改变带来了稳定的性能提升;
2.位置编码:使用两层 1D 卷积(kernel_size分别为113和1)作为位置编码,更好地捕捉局部时序模式;
3.下采样与通道扩展:时域下采样和特征维扩展均在 ResNet block 内部的卷积中完成,而非 ReDimNet 中由独立卷积层实现。这一设计简化了模块结构,同时使得训练更加稳定;
4.模块间连接:模块之间采用简单的 Shortcut 连接,而非 ReDimNet 中的加权 Dense connection。在实验中,加权Dense connection 并未带来性能提升(略降),却增加了计算开销。
⏩核心结构MoE机制如何加入网络?
本文的核心是引入MoE机制,团队探索了四种 MoE 变体,按聚合粒度分为帧级和语句级,按路由策略分为稠密(Dense)和稀疏(Sparse)。团队将每一个专家设计为一个Linear层。如图1所示团队将MoE替换在Transformer结构中的MHA后面的第一个Linear层。
1.帧级 MoE:对每一帧独立计算路由权重。稠密模式下,每帧经过门控网络计算所有专家的权重,输出为全部专家输出的加权和;稀疏模式下,仅激活门控值最高的 Top-K 个专家,对选中的专家子集计算加权和。
2. 语句级 MoE:门控决策是基于整条语音的均值池化,并生成一组所有帧共享的路由权重,而非逐帧路由。稠密和稀疏的区别同理:稠密模式使用全部专家,稀疏模式仅使用 Top-K 个。
⏩如何堆叠和扩展MECT系列模型?
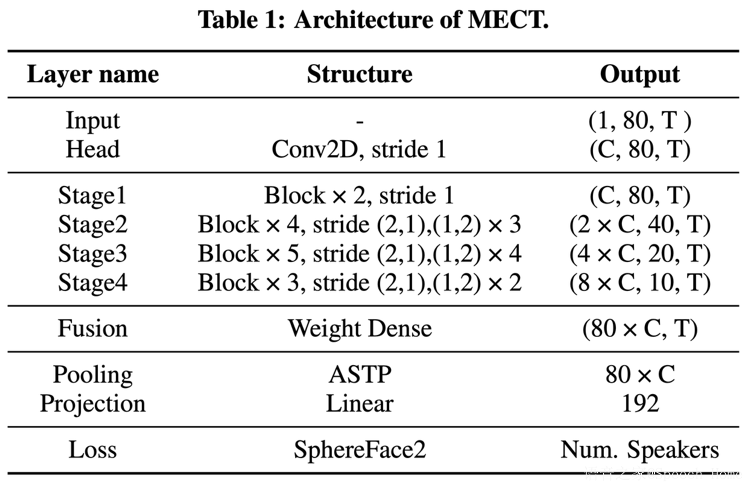
模型架构:如下表所示,MECT 采用多Stage结构,每个Stage堆叠若干MECT基础模块,其中首个模块通过卷积步长实现频率下采样,其余模块进行时域下采样,各阶段输出经加权Dense层融合后送入池化层。
多尺度模型:本文设计了 A1、A2、B1、B2 四种规模的模型,由输入通道数 C(A1/A2 为 16,B1/B2 为 32)和每个模块 ResBlock 数 M(A1/B1 为 2,A2/B2 为 3)控制,Transformer 隐层维度固定为 d=64。
其他配置:80 维 Fbank 特征输入(经过均值归一化),采用Attentive Statistics Pooling (ASTP) 池化和SphereFace2 损失函数。
⏩如何保障低延时的流式声纹提取精度?
流式声纹推理是随着音频chunk流的进入,持续输出声纹embedding,目标是在任何时刻输出的embeding的比对结果尽可能接近已有音频的非流式(offline)的输出结果。团队对比了三种流式策略:
- M1(embedding 均值)对所有历史 chunk 的 embedding 取平均(基线);
- M2(帧级特征拼接)累积帧级别的特征(Pooling前的特征)在时域拼接后送入池化层;
- M3(因果网络重训练)将网络设计为因果架构后重新训练,并在推理过程中做轻量的缓存机制对齐offline结果。
团队提出的M3模型因果改造具体包括:(1)所有的卷积层仅在时域左侧 padding;(2)MHA 使用因果 mask 限制每帧只关注历史帧;(3)输入的Fbank不做均值归一化。
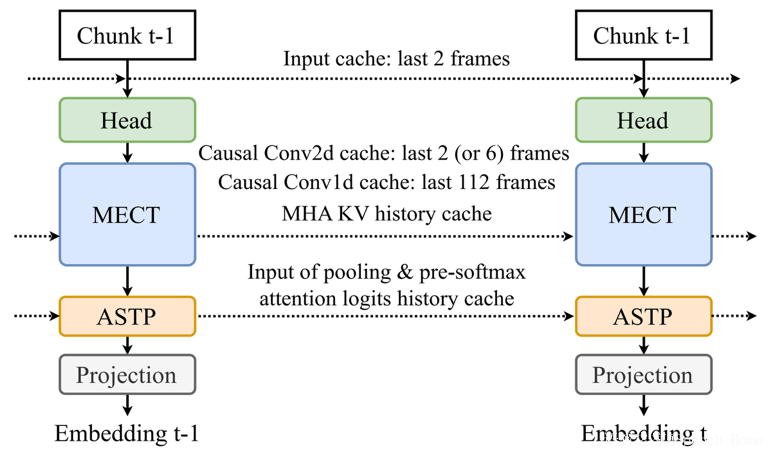
图 2 MECT流式推理
得到重新训练的模型后,流式推理时的缓存机制如图2所示以对齐offline推理的结果:
- 卷积层补齐感受野:Conv2d 缓存 2 帧(时域 stride 为 2 时 6 帧),Conv1d 缓存 112 帧(未够112帧pad 0),缓存特征与当前的输入特征在时域拼接,而后进入卷积计算;
- MHA融合历史状态:历史 KV 状态与当前步拼接后计算 attention;
- ASTP全局特征池化:缓存历史帧级特征(ASTP前的特征)和ASTP中softmax前的attention logits与当前 chunk 的帧级特征和attention logits拼接后计算全局 mean 和 std。
由于仅有 KV cache 和 ASTP 依赖完整历史,且这两部分计算量很小,因此缓存带来的额外计算开销较小。在工程应用上,两种 cache 均可设帧长上限以控制显存。
实验结果
⏩MECT在VoxCeleb 和 CnCeleb 的性能指标
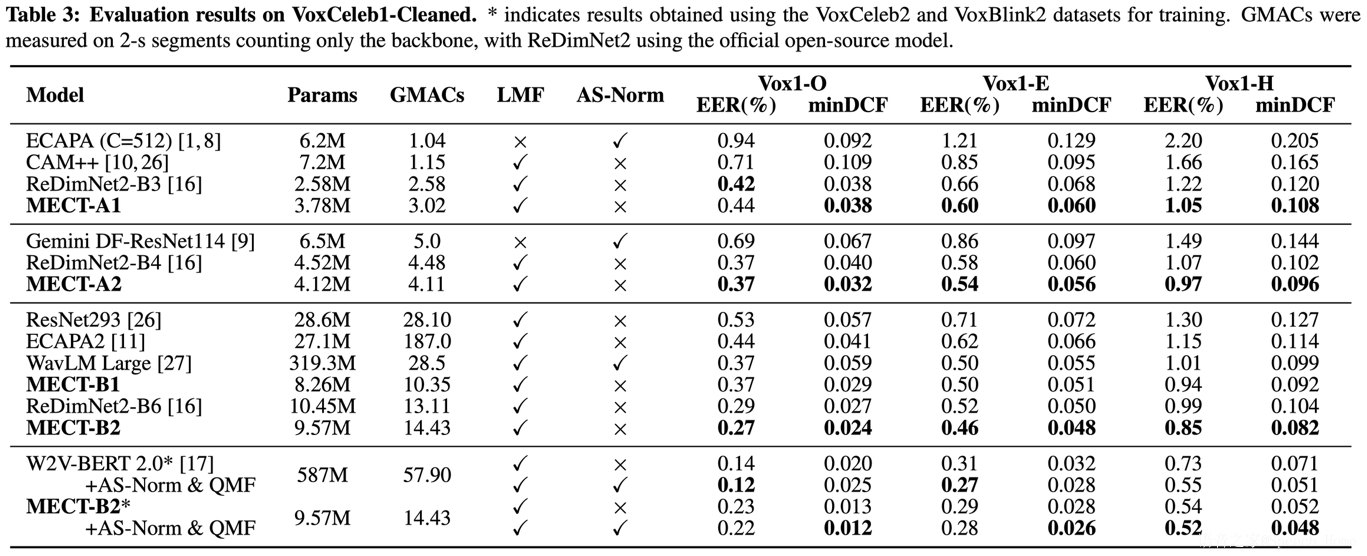
上表对比了 MECT 与公开模型在 VoxCeleb1 上的表现(MECT 使用帧级 Dense MoE,4 个专家),其中为了比对公平,团队获取ReDimNet2原文开源的模型,在同规则下进行参数量和计算量的统计:
- MECT-A2:在VoxCeleb2数据上训练,以更少参数和计算量在三个测试集上的效果均超越 ReDimNet2-B4,在Vox1-H 上 EER 和 minDCF 性能相对提升 9.3% 和 5.9%;
- MECT-B2:在VoxCeleb2数据上训练,以更少参数量,在三个测试集上性能超越 ReDimNet2-B6,在Vox1-H 上,minDCF 和EER性能相对提升 21.2%和14.1%;
- VoxBlink数据参与训练:使用 VoxBlink2 训练后,MECT-B2 以远少于 w2v-BERT2.0 的资源取得更优结果,三个测试集的平均EER 和 minDCF 性能相对提升 10.3% 和 24.4%,实现了全监督轻量模型性能超越预训练大模型;经 AS-Norm 和 QMF 后,MECT-B2 进一步达到 SOTA结果,minDCF 分别达到 0.012、0.026、0.048。
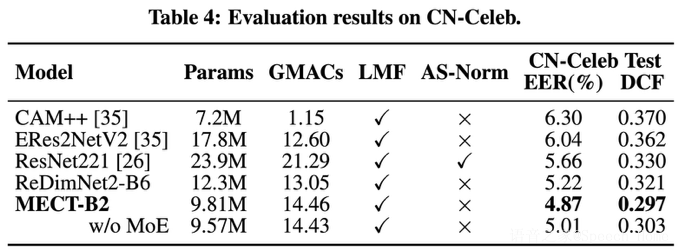
团队进一步在其他数据进行验证,上图为 CN-Celeb数据训练,CN-Celeb Test测试的结果,MECT-B2 采用帧级 Sparse Top-4 MoE,8 个专家,相比同样训练配置下的 ReDimNet2-B6,EER 和 minDCF 性能相对提升 6.7% 和 7.5%。
⏩MoE的消融实验
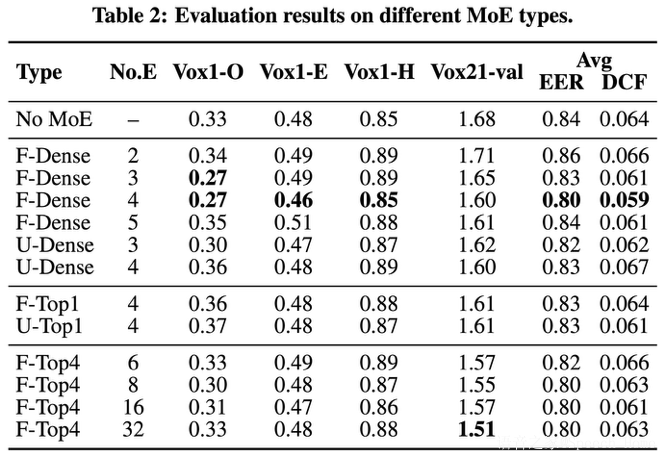
团队在VoxCeleb数据上对MoE进行了消融实验,上表展示了不同 MoE 类型和专家数量的消融实验结果。在所有配置中,帧级 Dense MoE(4 专家)最优,相比无 MoE结构的基线,平均 EER 和 minDCF 性能相对提升 4.7% 和 7.8%,而参数量仅从 9.40M 增至 9.57M。同时,其他的MoE配置相比于baseline也有不同程度的提升。
⏩流式推理的性能评估
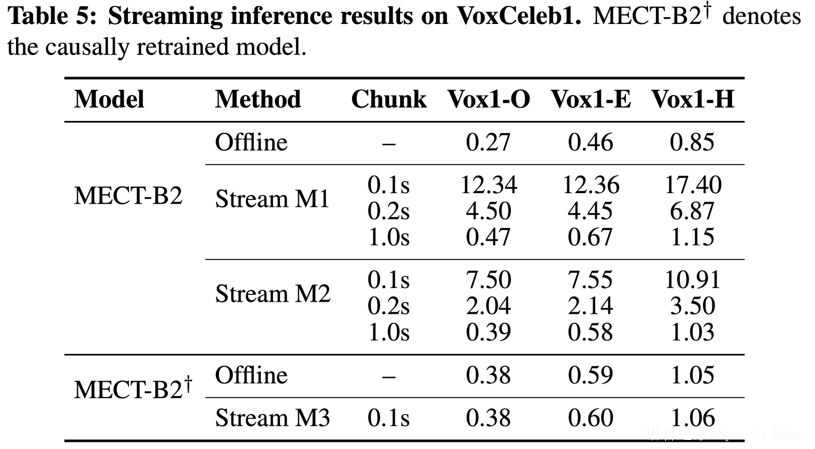
测试方法:团队将测试音频按照chunk流的方式进行输入,按照最后一个chunk输入后模型得到embedding作为最终比对的embeding。其中M1和M2方案输入的chunk流有1/2 chunk的overlap以得到更优的结果,而M3方案无需overlap。
测试结果:上表中,chunk 为 1.0s 时 M2 最优。但降至 0.1s 时,M1 和 M2 有极大的性能下降,EER分别退化至 12.34% 和 7.50%(Vox1-O),相比之下 M3 仍保持 0.38%、0.60%、1.06%(Vox1-O/E/H)的高性能,接近其offline基线,此结果验证了本文提出的M3方案在短 chunk 流式场景下的有效性。
可视化分析
⏩多专家是否真的实现“各有侧重”?
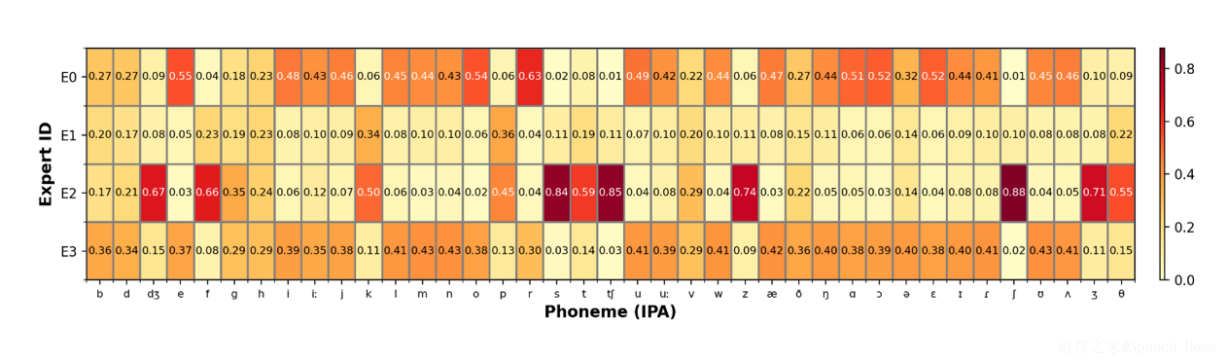
图 3 专家权重与音素类别关联
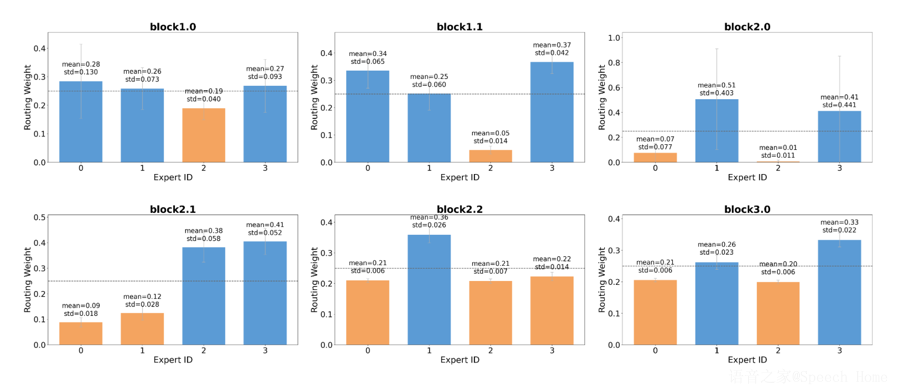
图 4 专家权重分布
团队使用 Allosaurus 音素识别器识别音素,统计不同专家权重和音素的映射关系。团队发现不同专家对不同因素各有侧重。如图 3 所示,专家 2 对辅音的擦音和塞擦音(如 /s, z, ʃ, f, θ, tʃ, dʒ/)表现出显著偏好(权重 0.65–0.88),而元音(如 /e, o, u, æ/)则主要路由至专家 0(0.40–0.55)。这种音素级别的专业化无需任何监督即可形成,表明 MoE 机制能够自动捕捉语音的底层声学结构,自主划分不同的发音特征。上述的不同专家的音素偏好发生在浅层的MoE中,深层的专家权重未体现在音素的区分上,但仍然有不同的分布(图4所示),团队也将继续探究是否在其他语音特征维度上有关注度的偏好,这也将推动声纹识别可解释性的研究。
团队和展望
蚂蚁集团 AI 身份智能团队致力于构建“以人为中心的 AI 时代身份与信任基础设施”。其中,泛终端 AI 核身团队以语音信号为切入点,推动这一目标落地。目前,团队已成功将声纹核身技术应用于智能眼镜、车机、耳机等多类终端,实现金融级安全认证。未来,MECT 模型 + 流式声纹推理技术 将推动声纹识别向更广泛的人机交互场景延伸,打造持续、无感、安全的身份验证体验。
