
 语音小管家
本文来源丨21db声学人
视觉—语言—动作模型已经让机器人越来越会“看着做事”,但现实操作中的很多关键状态并不写在画面里:微波炉“叮”的一声、电话铃响、咖啡壶沸腾时的喷溅声,往往只出现几百毫秒。上海交通大学与剑桥大学团队提出 HEAR 框架,把视觉—语言—动作扩展为视觉—声音—语言—动作(VSLA),重点解决机器人在动作执行间隙错过短促声学线索的问题。论文于 2026 年 9 月 16 日在《The International Journal of Robotics Research》OnlineFirst 发表。
编辑说明:SAGE 正式全文当前为受限访问。本文技术细节、实验数字与配图依据作者公开版 arXiv:2603.16086v2(2026 年 9 月 18 日修订);正式发表日期、作者单位与 DOI 依据 IJRR/SAGE 期刊页面核验。
01|机器人已经能“看着做”,为什么还要“边做边听”?
对许多机器人任务来说,视觉信息具有持续性:杯子放在桌上、抽屉已经打开,这些状态在连续多帧画面中都能看见。但声音恰恰相反。一个碰撞声、提示音或沸腾状态的转变,可能只存在很短时间。
现代大模型机器人为了保证动作平滑,常一次生成一段动作并连续执行。在这段时间里,策略不会持续重新决策。研究团队把由推理延迟和开放式动作块执行造成的这一段感知空档称为“盲执行区间”(Blind Execution Interval,BEI)。如果关键声音正好发生在这段时间,等机器人下一次“思考”时,声音可能已经消失。
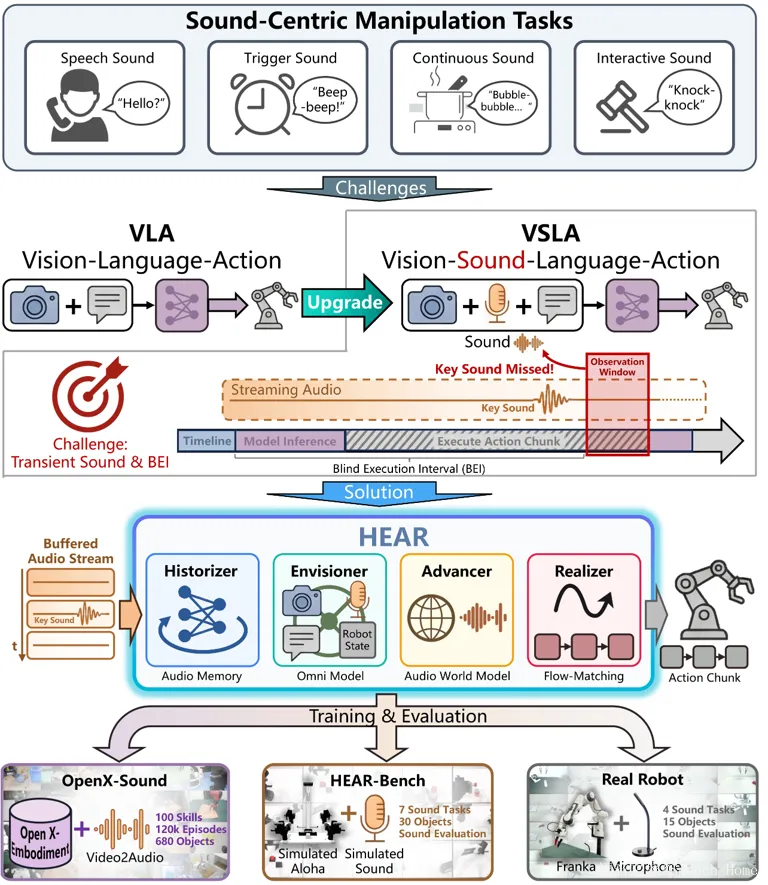
图 1|从 VLA 到 VSLA:短促声音可能落在“盲执行区间”中。HEAR 通过持续声音记忆、多模态推理、音频时间预测和动作生成,把声音从一次性提示变成操作过程中的因果线索。图片来源:Nie et al., 2026,作者公开版原论文 Fig. 1。
02|HEAR 的关键不是让机器人立刻停下,而是先把声音“留住”
HEAR 并不是把麦克风简单接到 VLA 模型上。它增加了一个持续运行的声音记忆链路:Historizer 不断接收音频包,并把短时声音压缩为可持续保留的因果记忆;Envisioner 再把视觉、语言、机器人状态、当前音频和声音记忆融合起来进行多模态推理;Advancer 通过预测接下来可能出现的声音,帮助模型理解任务的时间进程;Realizer 则生成平滑动作块,尽量降低机器人自身运动噪声对听觉的干扰。
这里需要特别区分两个概念:HEAR 并不意味着“听到声音后立即打断正在执行的动作块”。论文解决的是关键声音在两次决策之间发生后,不至于被彻底遗忘;等下一次策略更新时,机器人仍能知道“刚才发生了什么声音”,并据此调整后续动作。
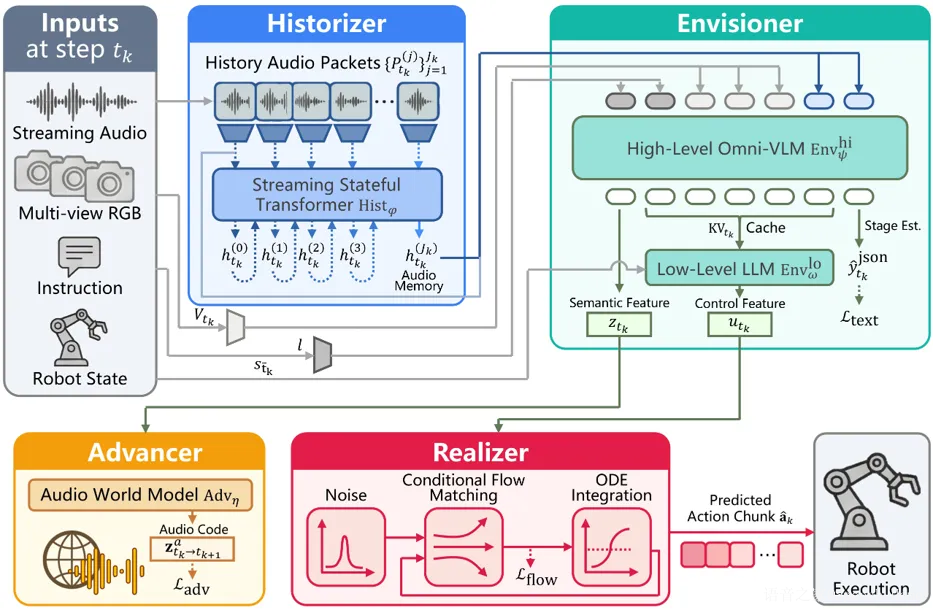
图 2|HEAR 系统结构。Historizer 负责持续声音记忆,Envisioner 融合多模态信息,Advancer 学习近未来声音变化,Realizer 输出平滑动作块。图片来源:Nie et al., 2026,作者公开版原论文 Fig. 2。
03|实验看什么?不是“识别对了声音”,而是“在正确时机才行动”
团队构建了 HEAR-Bench,包含闹钟、微波炉、语音确认、打断指令、材料敲击、倒水和烧水等 7 类任务。评测规则强调“声因果”:如果机器人在目标声音出现之前就提前完成动作,即使最终画面看起来正确,也会被判定失败。
在这一严格条件下,HEAR 平均成功率达到 81%。去掉 OpenX-Sound 预训练后降至 69%,去掉负责持续声音记忆的 Historizer 后进一步降至 57%。这说明性能提升并不只是来自“多加了一个音频输入”,持续保留瞬时声学证据是核心环节。
04|真机测试:咖啡壶、电话、摇瓶和闹钟
研究团队随后把系统部署到 Franka Panda 机械臂上,只使用两个 RGB 相机和一个普通工作区麦克风。四项任务分别要求机器人听咖啡壶沸腾过程、等待电话铃并判断通话结束、摇动不透明瓶子判断内部是否有物体,以及听到真实闹钟响后再按下按钮。
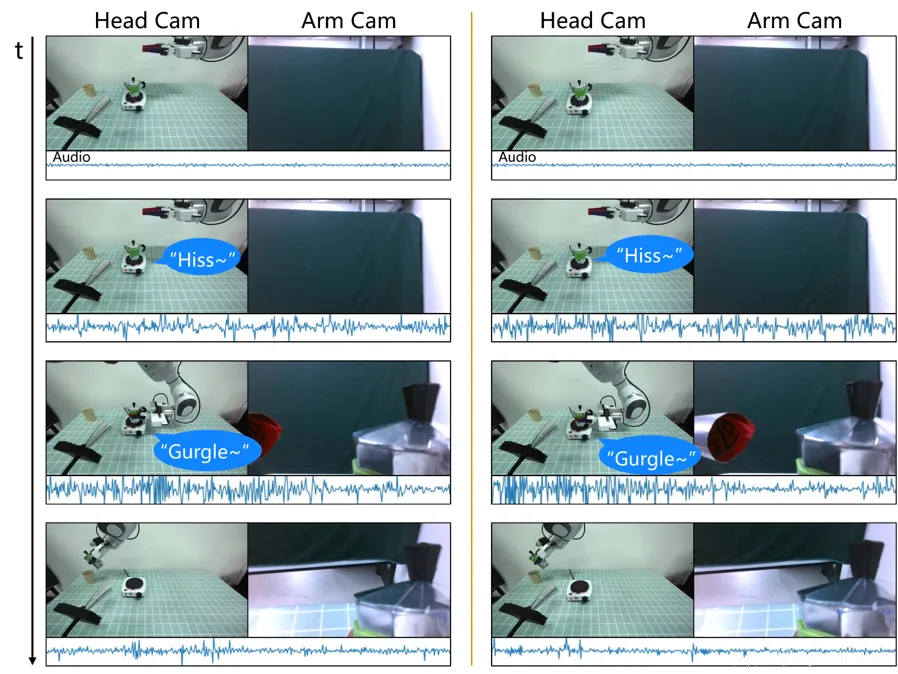
图 3|Moka Coffee 真机任务:机械臂需要持续监听咖啡壶的声学变化,并在特征性喷溅/沸腾阶段出现后再执行倒咖啡动作。图片来源:Nie et al., 2026,作者公开版原论文 Fig. 14。
在统一声学设置下,HEAR 四项任务平均成功率为 54%。论文随后对最困难的咖啡壶和接电话任务改进麦克风位置、增益和任务数据配置,并让所有对比方法在相同条件下重新评测;此时 HEAR 平均成功率达到 70%,高于最强 VLA 音频适配基线的 45%。四项任务分别达到 51%、43%、88% 和 96%。
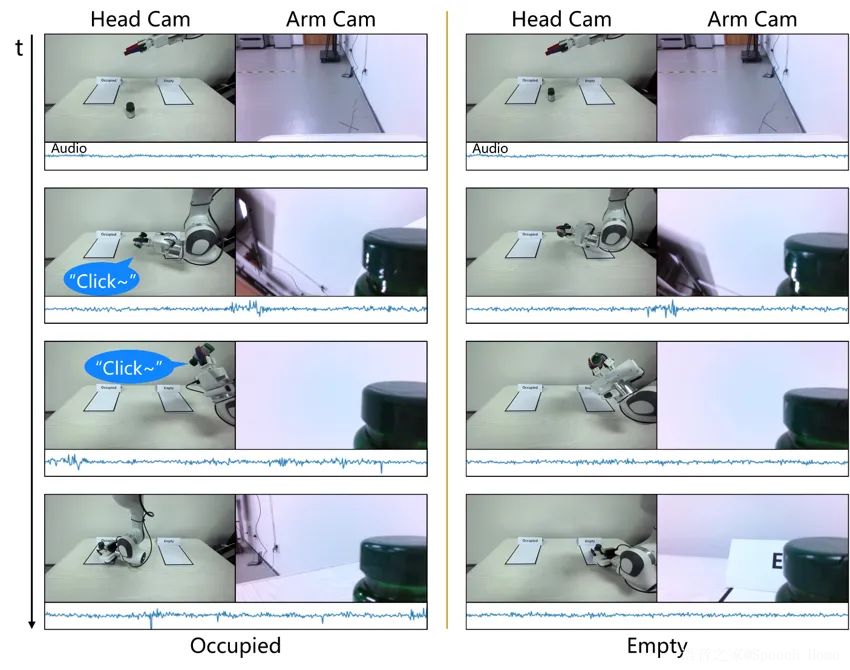
图 4|Shake Bottle 真机任务:机械臂主动摇动不透明瓶子,通过自己制造的碰撞/晃动声判断瓶内是否有物体,属于“主动声学感知”。图片来源:Nie et al., 2026,作者公开版原论文 Fig. 16。
05|从“会听声音”到“用声音理解正在发生什么”
这项工作的意义并不只是给机器人增加听觉。它把声音从一次性的输入提示,变成机器人在连续动作中判断事件是否发生、过程进行到哪一步以及何时应该行动的时间线索。
但论文也明确给出边界:当前真机只使用单个工作区麦克风,无法可靠完成声源定位或复杂多声源分离;训练仍以离线模仿学习为主,对机械自噪声、混响和环境变化的适应能力有限;音频与视觉目前仍先分开处理再融合,距离真正原生的视听联合感知还有空间。
因此,HEAR 更像是在具身智能中补上了一块长期被视觉主导方案忽略的拼图:机器人不只要“看见并行动”,还需要在行动过程中持续聆听,并把短促声音转化成可用于下一步决策的状态证据。
论文信息:Nie, C., Deng, T., Wang, G., Liu, Z., & Wang, H. (2026). Towards the Vision-Sound-Language-Action paradigm: The HEAR framework for sound-centric manipulation. The International Journal of Robotics Research. Advance online publication. https://doi.org/10.1177/02783649261477778
https://arxiv.org/abs/2603.16086
