
 THUsatlab
CVPR 2024
基于运动解耦扩散模型的语音驱动共语手势视频生成
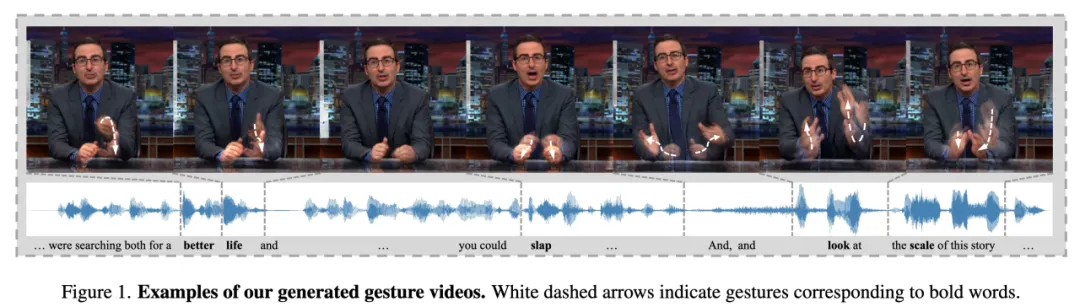
生成样例试听及开源代码获取:https://thuhcsi.github.io/S2G-MDDiffusion
1 背景介绍
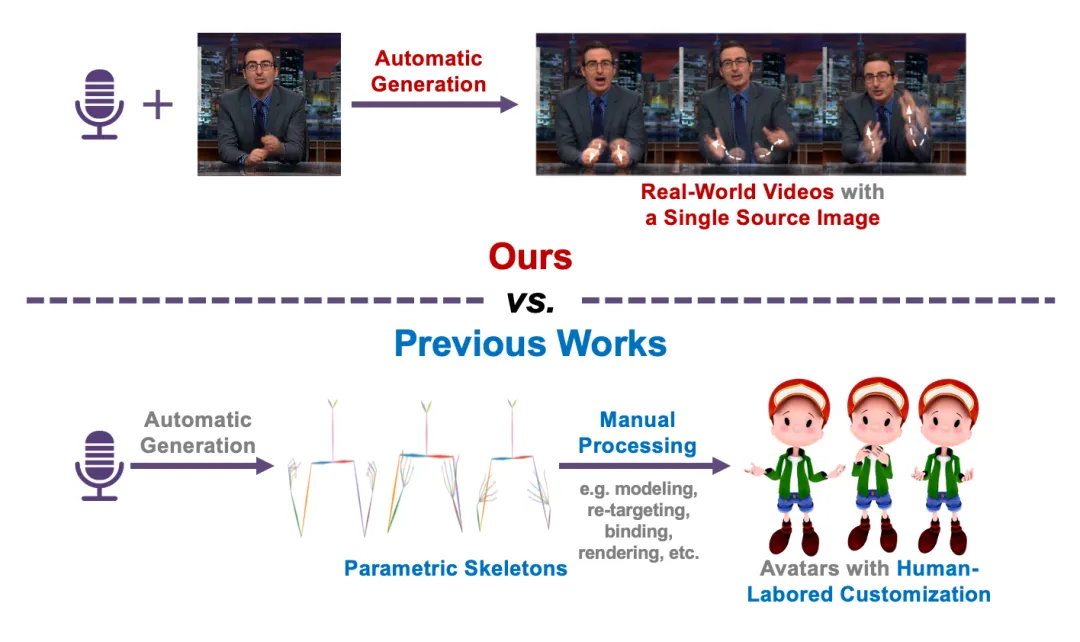
共语手势作为一种典型的非语言行为能够传递丰富的信息,在人类交流中发挥着重要作用。合适的手势与人类语言相辅相成,有利于增强语言内容的可信度和说服力。因此,在人机交互领域,赋予智能体拟人且与语音匹配的手势具有很高的研究价值。
针对此目标,许多工作已经实现了共语手势的自动生成。然而这些方法大多将虚拟数字人手势表示为参数化的人体骨架。这种表示虽然简化了生成目标,降低了共语手势的实现难度,但因其完全丢弃了外观信息,无法直接应用于人机交互。为了获得更好的视觉效果,绝大多数工作手动将生成的骨架与定制数字人形象绑定,使用Blender或Maya等工具进行渲染,此流程中建模、重定向、绑定、渲染等操作都需要耗费大量的人力。一些工作也尝试训练独立的后处理图像合成器,使用骨架驱动图像,但这仍然依赖于人工骨架标注,也会引入额外的帧间抖动。
不同于这些工作,本文致力于在没有人工先验标注的条件下生成语音驱动的共语手势视频,即给定一张说话人参考图(source image)和一段驱动语音,直接生成和语音匹配的真实世界形式的手势视频。
2 主要挑战
首先,需要一种合适的运动表征,在描述复杂的肢体运动轨迹的同时,保留关键的人体外观,从而实现信息的有效解耦。一种直接的方式是利用人工标注的预定义参数化骨架作为运动表征,但是其只包含稀疏的关节坐标,会导致肢体形状丢失和标注的误差累计,不适用于该任务;另一种方式是参考视频生成工作,将视频编码到潜在空间,使用基于UNet的扩散模型(Diffusion Model)在潜在空间进行内容生成。但这些方法致力于通用视频生成,其中变分自编码器(Variational Autoencoder,VAE)提取的潜在特征缺乏明确含义,难以实现运动信息的有效解耦,直接应用于人体运动视频生成会导致完全不合理的动作以及细节的缺失。
其次,视频中的手势需要与语音实现时序上的对齐,尤其是在输入任意长语音的情况下,捕获手势和语音的内在联系尤为困难。另外,受到算力资源和推理时长的限制,现有视频生成工作往往只能生成固定几秒长度的视频。
3 贡献
为了解决以上挑战,本文提出了一种新颖的运动解耦框架来生成共语手势视频。
首先,为了从手势视频解耦运动信息的同时保留关键外观信息,本文精心设计了一种薄板样条(Thin-Plate Spline,TPS)变换来建模一阶运动。这种变换是非线性的,能够适应运动中多变的肢体形态。具体来说,通过预测关键点对(paired keypoints)构建TPS变换,并将其用于光流估计和图像形变(warping),从而生成相应的手势视频帧。中间产物关键点被视为潜在运动表征,实现对视频运动信息的高效解耦压缩,减轻生成模型的负担。
在此基础上,本文引入了一个Transformer结构的扩散模型,在潜在运动空间内生成共语手势。注意力机制捕捉语音和运动之间的内在联系。为了进一步实现长时生成,我们提出了一个运动优选模块,基于连贯性和一致性生成稳定的任意时长手势视频。
最后,为了提升可视化质量,我们提出了一个UNet与残差块结合的细化网络,以捕捉视频帧内空间上的局部和全局信息,重点关注特定区域,修复纹理细节的缺失。
4 研究方案
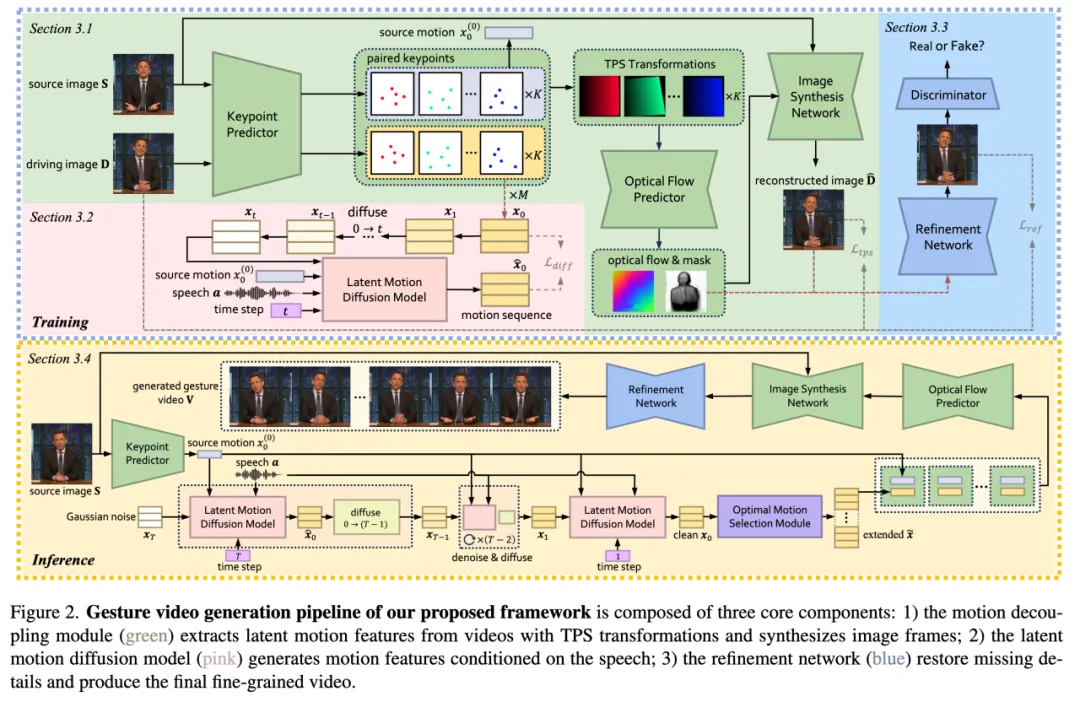
本文提出的模型整体框架如上图所示。给定一段语音和一张说话人参考图,模型致力于生成一段合适的手势视频(即一段图像序列)。本文的整体思路是解耦并生成运动表征作为视频生成的桥梁,因此,整体流程为:首先利用运动解耦模块编码参考图像得到初始运动表征,与语音一起作为潜在运动扩散模型的条件实现“语音-运动”的转换,最终由运动解耦模块的图像合成器及细化网络共同解码实现“运动-视频”的生成。
基于TPS变换的运动解耦模块
使用有效的运动表征进行运动信息解耦对于生成高质量手势视频极其重要。因此,本文设计了一个运动解耦模块,利用非线性的TPS变换进行运动表征的提取和转换,从而建模复杂多变的肢体形态。该模块主要包括关键点预测网络(Keypoint Predictor)、TPS变换(TPS Transformation)、光流估计网络(Optical Flow Predictor)和图像合成网络(Image Synthesis Network),在整体合成框架中扮演一个具有运动特定含义的自编码器角色。

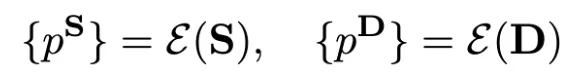
接下来,TPS变换将稀疏的关键点对转换为稠密的像素映射:
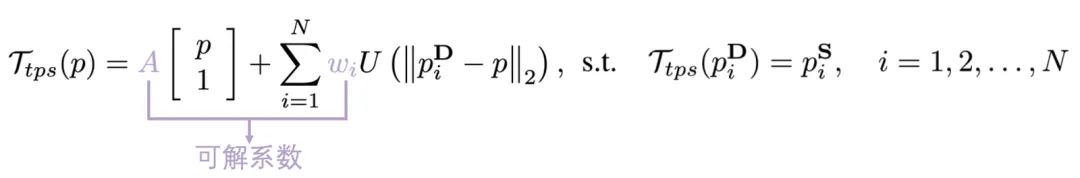

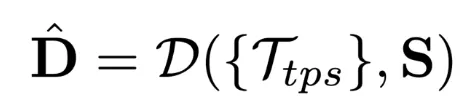
潜在运动扩散模型
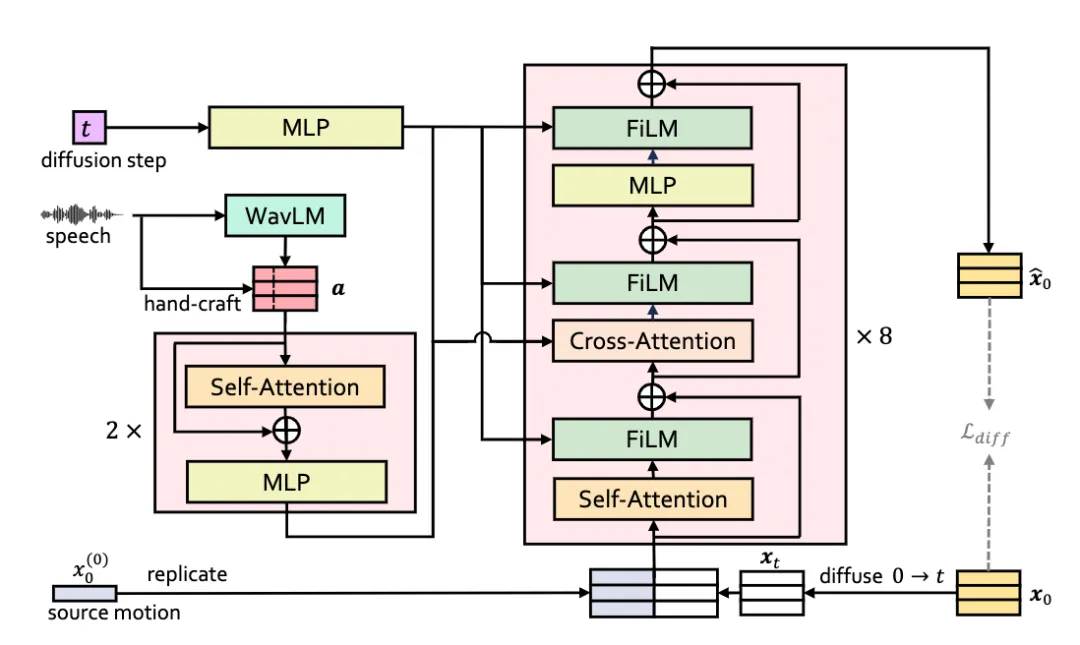
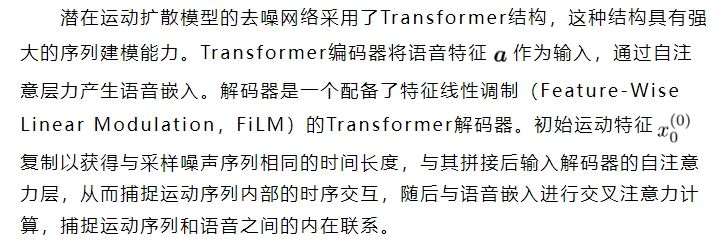
在运动解耦的基础上,本文的关键思想是使用一个扩散模型在潜在运动空间进行去噪,实现运动表征的生成。

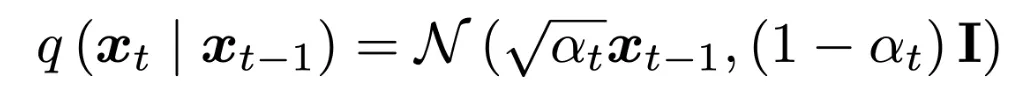
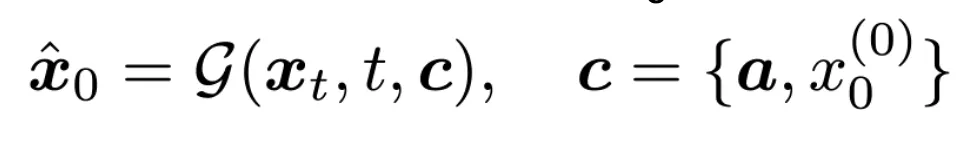
细化网络
在运动表征的引导下,运动解耦模块的图像合成网络可以根据光流生成与语音匹配的图像帧。然而,合成的图像会出现一些细节缺失导致的模糊现象,尤其是在脸部、手部和图像填补的区域。由于图像合成网络在运动解耦模块中联合训练,为了不破坏运动建模,本文提出了一个独立的细化网络。
细化网络使用类似 Unet 的架构,并结合残差块来捕捉全局和局部信息。为了增加对特定区域的注意力,我们利用MobileSAM对手部和面部进行分割,并在重建损失中为手部、面部和填补区域分配更大的权重。
5 实验验证
实验设置
实验数据:
我们在PATS(Pose, Audio, Transcript, Style)数据集上进行训练和测试。根据PATS提供的原始视频URL,下载并预处理了4个说话人的音视频数据进行实验。预处理步骤包括:1)去除低质量片段(如:包含过多观众掌声、相机视角转换过大、完全侧面视角等的片段);2)考虑到手势有效性,裁剪视频长度为4~14秒;3)裁剪说话人边框及居中处理,视频被重采样为25fps,256×256分辨率;4)使用WavLM音频特征扩展数据集。最终对每个说话人获得1200条有效音视频片段。
评估指标:
客观评估中:对运动相关评估,我们先使用现有姿态估计器MMPose提取视频中的2D姿态,在此基础上,我们评估手势质量(Frechet Gesture Distance,FGD)、手势多样性(Diversity,Div.)和节奏对齐程度(Beat Alignment Score,BAS)。对视频相关评估,我们评估视频整体质量(Frechet Video Distance,FVD)。
主观评估中:我们引导实验参与者从手势的真实性(Realness)、多样性(Diversity)、和语音的同步性(Synchrony)及整体质量(Overall quality)进行0~5分的评估。
和基线模型的对比实验
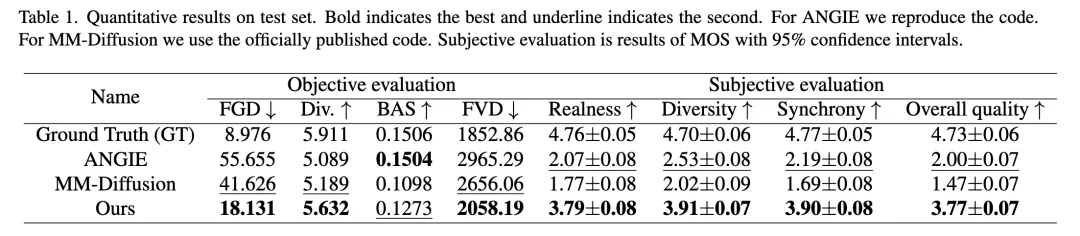
我们和手势视频生成的SOTA工作ANGIE和音频驱动视频生成的SOTA工作MM-Diffusion进行对比,实验结果如上表1所示。
根据客观评估结果,我们提出的方法在运动相关的指标FGD和Div.上显著优于现有方法(提升56.44%和8.54%),这表明我们基于运动解耦和扩散模型的生成框架能够在运动空间中生成逼真且多样化的手势。此外,我们的FVD表现优于最佳基线模型MM-Diffusion,这表明在手势特定的视频生成场景下,我们的方法能够取得比通用视频生成方法更好的整体质量。
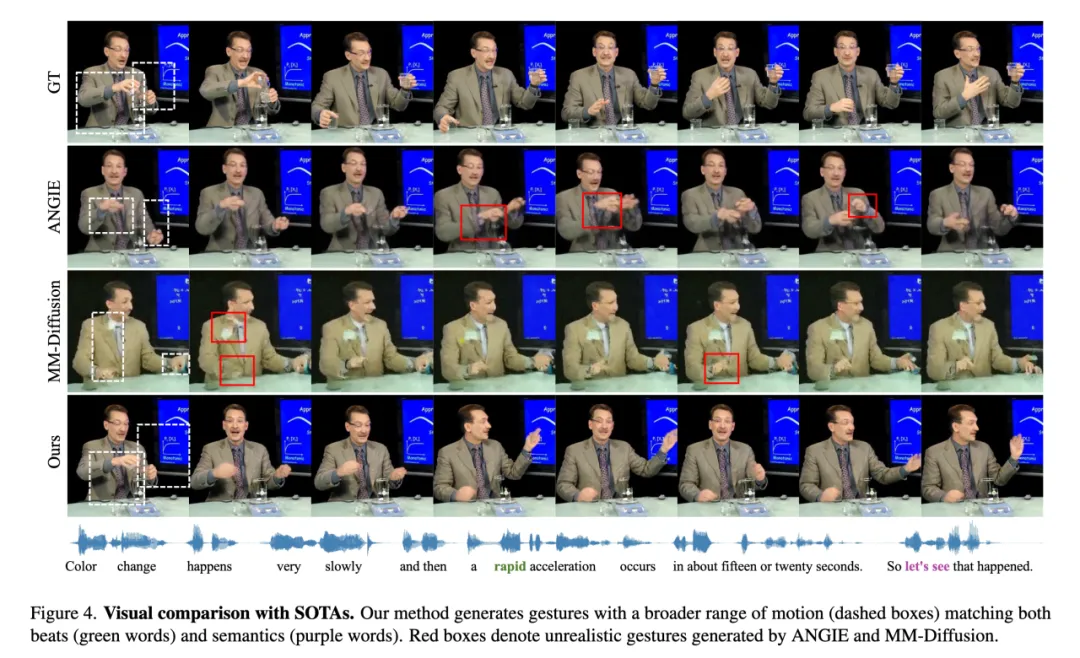
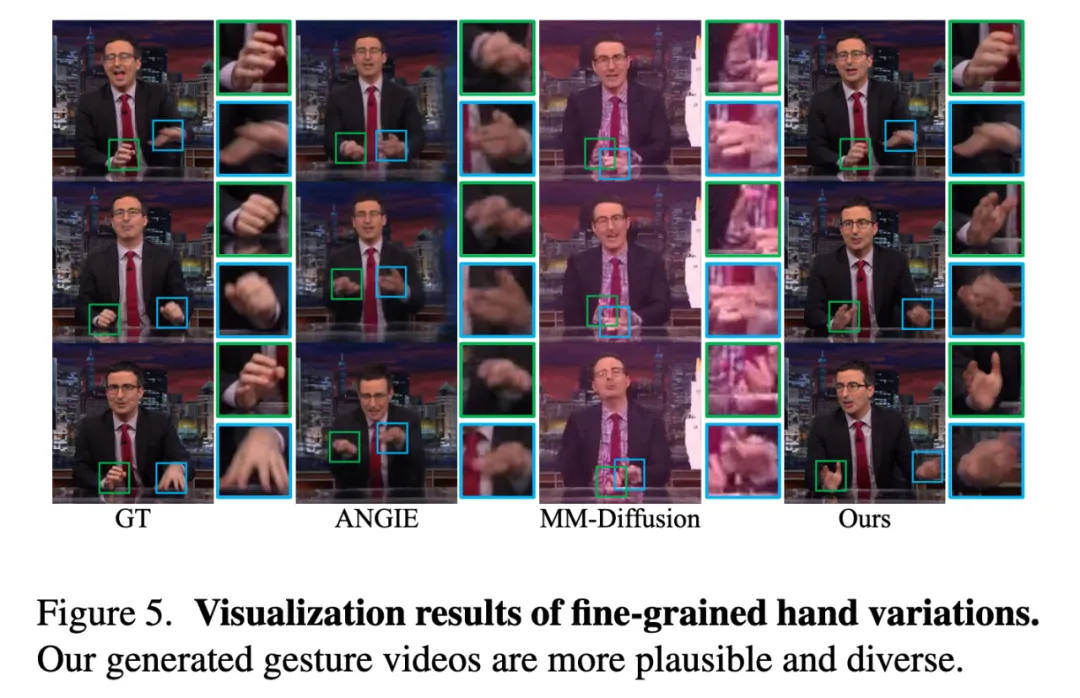
根据主观评估结果,我们的方法在所有维度上均优于基线模型,表明我们的框架兼顾了动作质量和整体视觉效果,能够生成更好的手势视频。图4表明我们的框架生成更加丰富、真实的手势的同时,兼顾了节奏级别和语义级别的匹配。图5表明我们的方法能够生成更合理、多样的手部形态。
消融实验
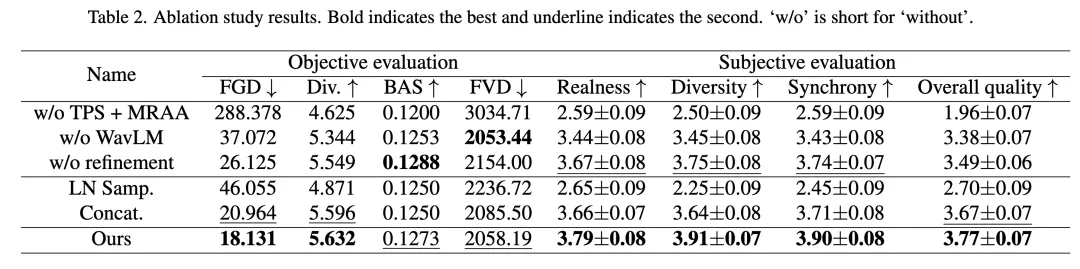
为了验证框架中不同组件的作用,我们进行消融实验并讨论以下组件的有效性:1)基于TPS的运动解耦模块;2)WavLM特征;3)细化网络;4)运动优选模块。
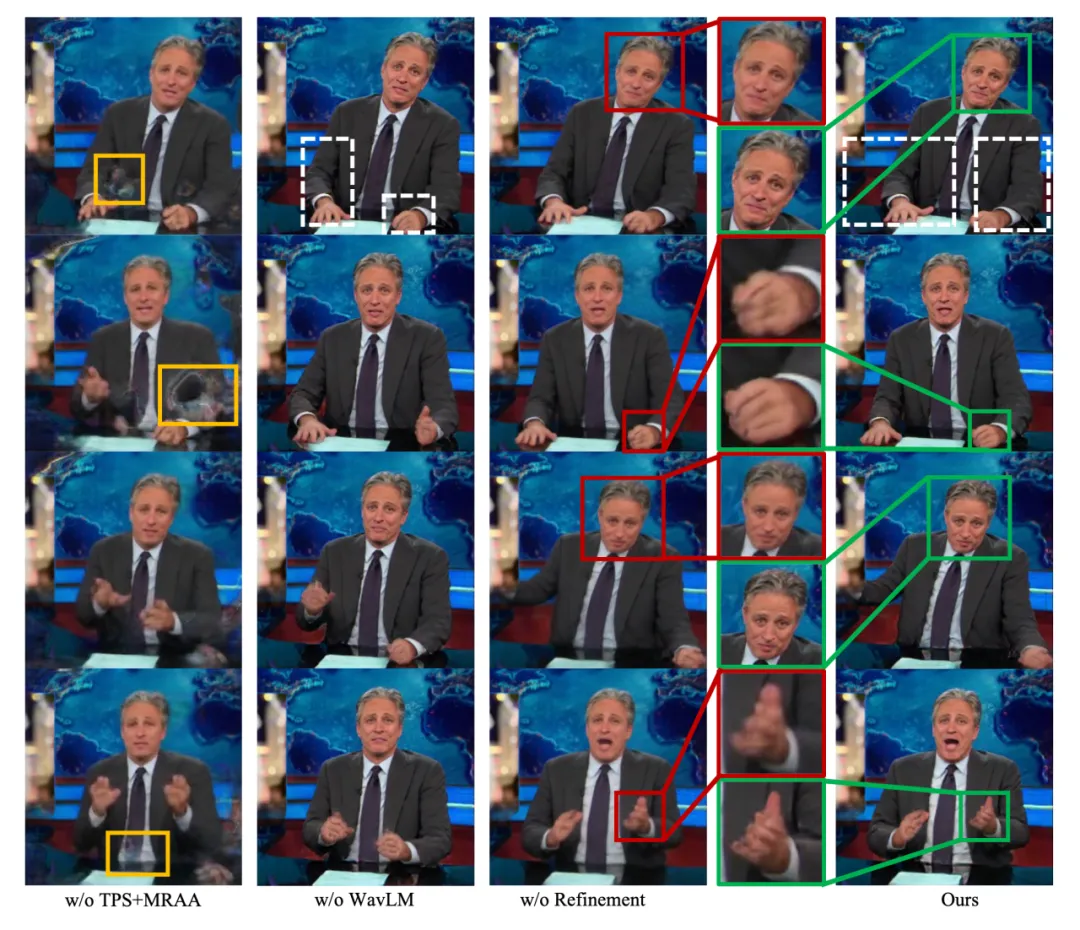
从上表2的实验结果可以看出,使用ANGIE中的MRAA表征替换基于TPS的运动表征后,FGD和FVD指标严重恶化,强调了使用合适运动表征解耦运动在手势视频生成框架中的重要性。移除WavLM特征后,FGD、Div.和BAS都有所恶化,下图中也可以发现加入WavLM获得了更大的运动范围(白色虚线框),这是因为WavLM包含诸如语义和情感等高级信息,对于驱动手势极为重要。细化网络主要改善了FVD,即视频的整体质量。而将运动优选模块替换为简单的长噪声采样(LN Samp.)和拼接(Concat.)导致所有指标都有所恶化。
6 结论
本文提出了一种新颖的运动解耦结合扩散模型的框架,在不借助人类结构先验的条件下生成真实世界形势的共语手势视频。实验证明,该框架能生成任意长的与给定语音相匹配的真实、多样的手势视频,性能显著优于现有方法。
