 THUsatlab
本文介绍清华大学语音与音频技术实验室(SATLab) ICASSP 2024录用论文Whisper-Based Transfer Learning for Alzheimer Disease Classification: Leveraging Speech Segments with Full Transcripts as Prompts。这篇文章的研究基于大规模语音识别模型Whisper,利用自发语音进行迁移学习来做阿尔兹海默症(AD)检测任务,并通过将语音的完整转录本作为prompt,显著提升了模型性能。
阿尔兹海默症检测
阿尔茨海默症(AD)是一种起病隐匿的神经退行性疾病。随着老年人口的大幅增长,阿尔茨海默病患者的人数也在迅速增加,全球患者人数已达到约5500万。临床研究表明,早期治疗可以延缓阿尔茨海默症恶化。因此,利用成本低廉、操作便捷的方式进行大规模阿尔兹海默症筛查至关重要。
最近,人们对基于语音的阿尔茨海默症检测方法进行了广泛研究,为其大规模筛查奠定了基础。在本文中,我们尝试使用语音识别模型 Whisper和迁移学习来进行阿尔茨海默症分类,并将整个转录本作为提示(FTP),使模型能够获得全局语义信息。实验结果证明了基于 Whisper 的迁移学习方法的可行性和FTP的有效性。
实验方法
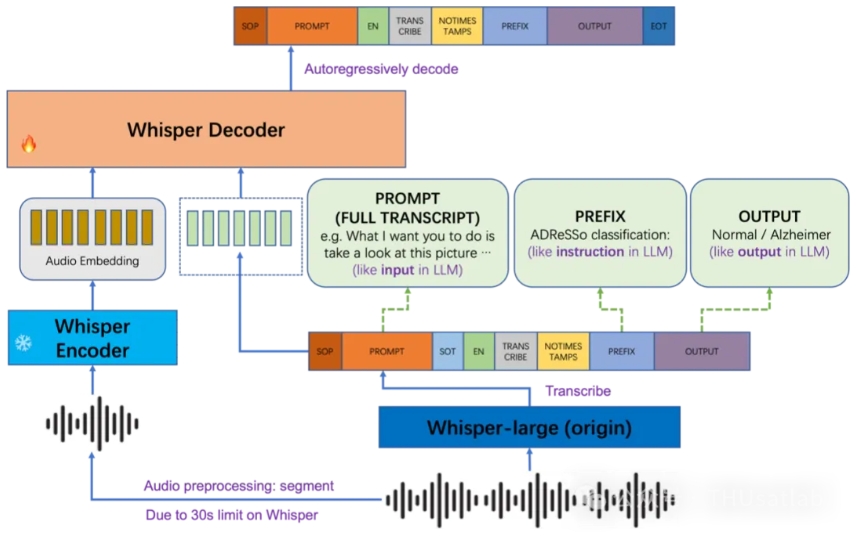
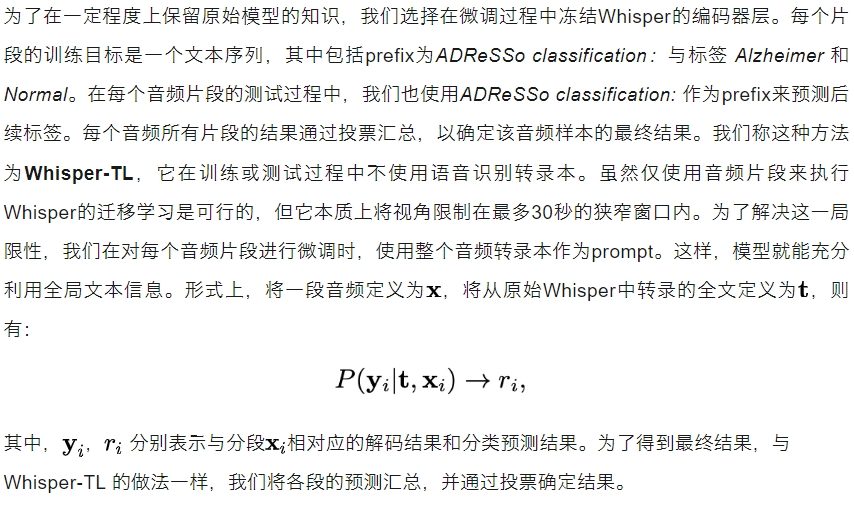
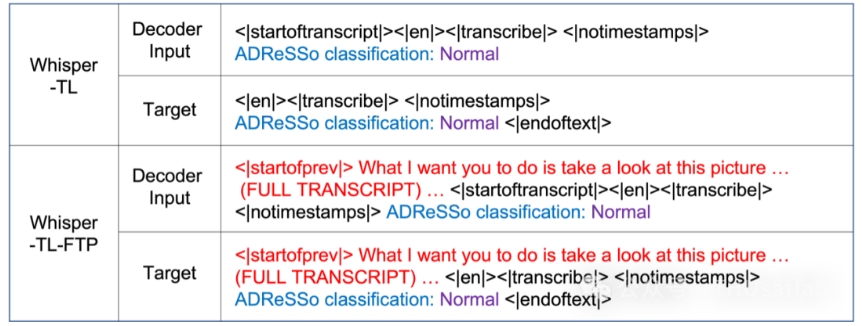
在训练过程中,提示部分应作为预测的参考信息而非目标。因此,在解码器输入和目标中,从<|startofprev|>开始的提示信息部分是保持不变。模型可以根据输入直接输出相同的内容,直到遇到<|startoftranscript|>,这时才开始预测后续内容。在本实验中,音频转录自Whisper-large原始模型的长音频转录接口。在对测试样本进行解码时,不仅需要提供prefix,还需要提供全文作为prompt。这样可以确保模型在生成输出时参考完整的文本信息。本文将这种使用整个转录本作为提示的方法称为Whisper-TL-FTP。通过这种迁移学习的方式,Whisper被改装成类似指令输入的大模型形式,prefix类似于instruction,表明需要做的任务;这里的prompt类似于文本input,提供全局文本信息;output展示分类结果。
实验结果
本研究使用的数据集来自 ADReSSo 挑战赛,包括参与者描述波士顿失语症诊断考试 Cookie Theft 图片的语音记录。考虑到数据集规模有限,使用不同的随机种子可能会导致不同的结果。为了提高可靠性,我们使用不同的随机种子进行了10次实验。对于每个测试样本,我们将所有投票汇总,得出最终预测结果。实际上,在选择合适的随机数种子的情况下,我们的方法单个模型的准确率比我们报告的投票结果还会高1%以上。
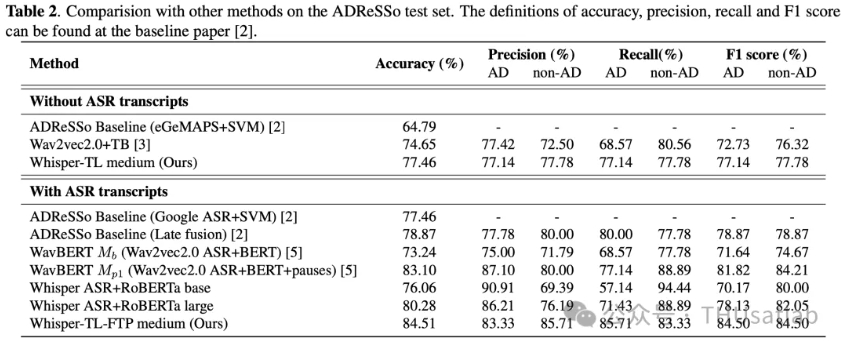
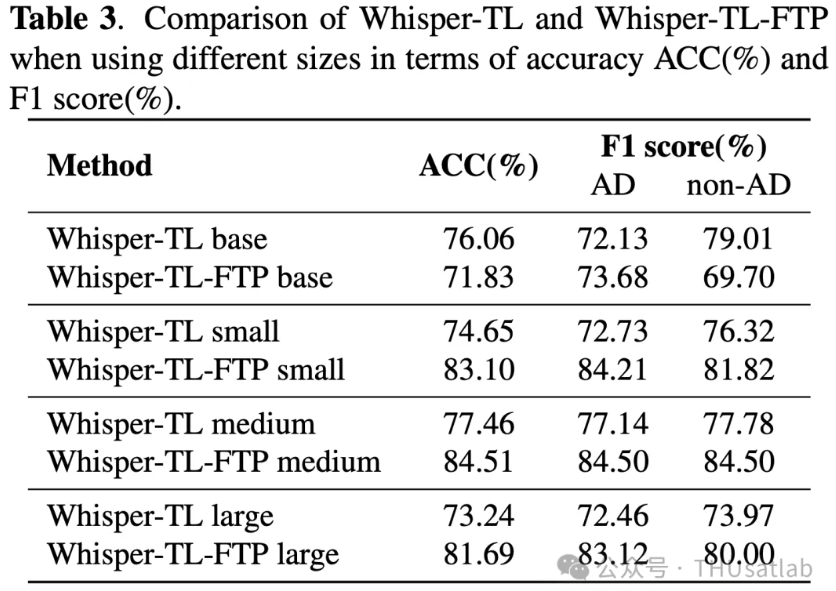
上表列出了在 ADReSSo 测试集上使用迁移学习和不同大小的 Whisper 模型(base,small,medium,large)得出的汇总结果。从表中可以看出,在使用base模型时,采用FTP的性能略有下降。但是,对于small及更大规模的模型,使用FTP会显著提高性能,相对提高幅度约为9%到12%。这表明,在具有更多参数的Whisper模型的迁移学习中,使用 FTP 可以让模型有效地从提示文本中学习,从而帮助阿尔茨海默症的检测。另一方面,当模型参数较少时,可能无法有效利用提示文本信息,从而导致性能下降。在比较不同规模模型的整体迁移学习效果时,medium规模的模型在准确率和F1分数方面取得了最好的结果。这表明,在数据量有限的情况下,适当的参数量能使模型更好地利用音频信息和提示文本,而不会导致明显的过拟合。
总结
作者简介