
 THUsatlab
论文链接:https://ieeexplore.ieee.org/document/10447183
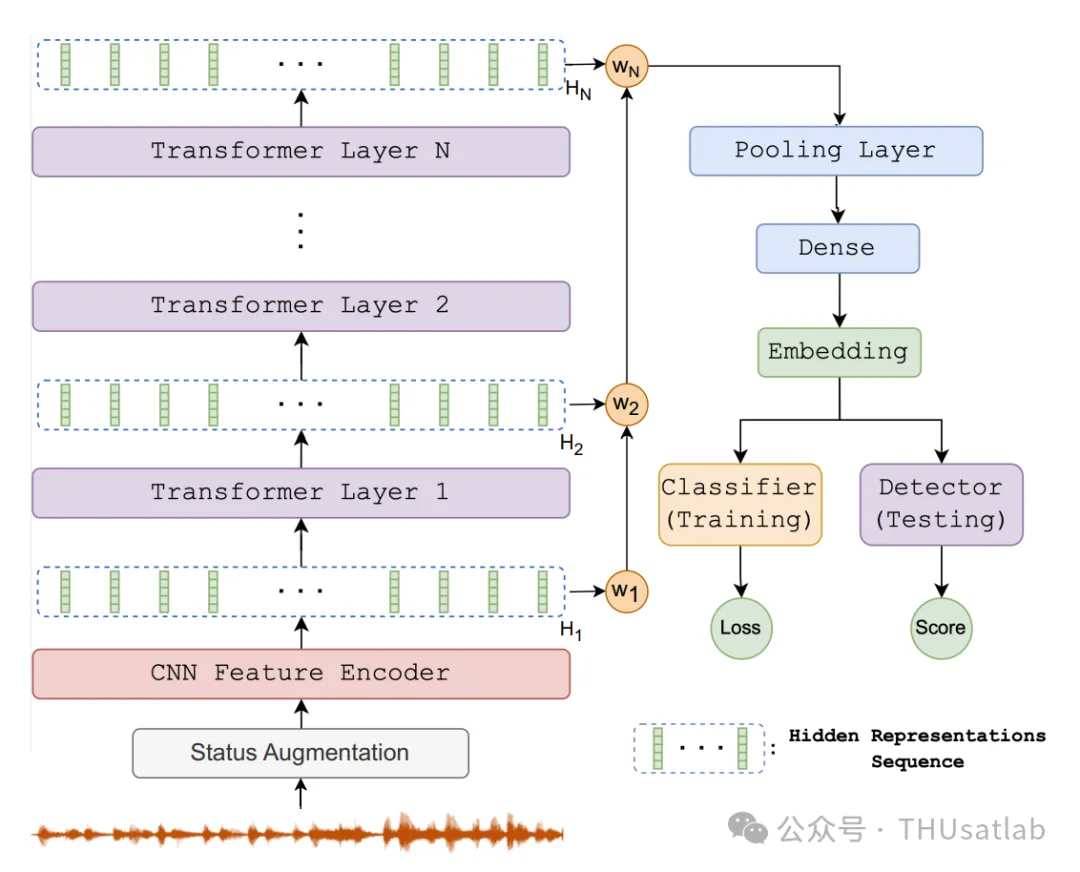
针对异常声音检测任务的特点,设计了一种新的数据增强方法——“状态增强”,通过改变音频信号的速度模拟不同机器运行状态,以增加训练数据的多样性。 在预训练模型的基础上,不是简单地使用最后一层的输出,而是采用加权求和方式融合来自不同层的隐藏状态,从而整合不同尺度下的声学特征,实验证明这种方法显著提高了检测性能,增强了模型的鲁棒性。
引入了Transformer池化方法,用于聚集同一录制片段的有效信息,进一步提升了系统的稳定性。
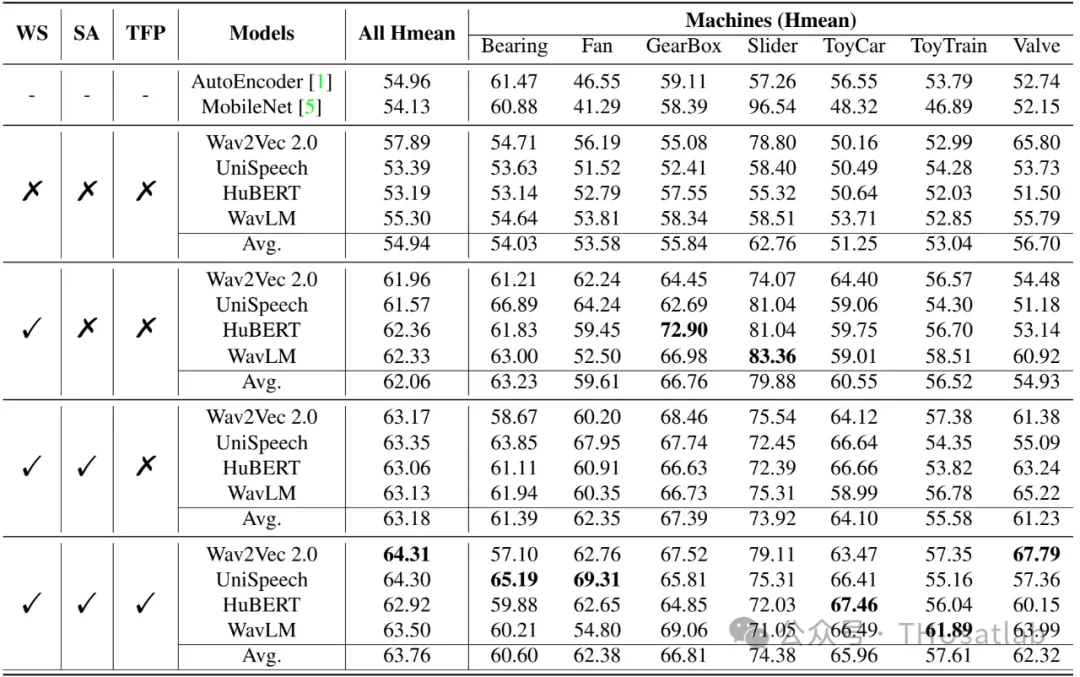
实验结果表明,在DCASE2023数据集上的测试中,所提出的模型超越了常见的基于重构的自编码器和基于分类的卷积网络方法,取得较大优势。在DCASE2023挑战赛的Task2中,团队凭借这些策略获得了第二名的成绩,充分证明了大规模预训练对于提高机器异常声音检测的泛化性和鲁棒性的有效作用。此外,论文还展示了预训练模型各层权重分配的可视化结果,揭示了异常信息可能存在于不同层次,多层融合机制有助于捕捉这些信息并优化检测效果。
