
 阿里语音AI
在使用语音识别服务进行语音转文字的过程中,大多数情况下模型能正确地预测高频词汇,但是对诸如人名地名、命名实体等词频较低或与用户强相关的词汇,模型往往会识别为一个发音相近的其他结果,这使得语音识别模型在日常生活中、垂直领域落地时并不完美。
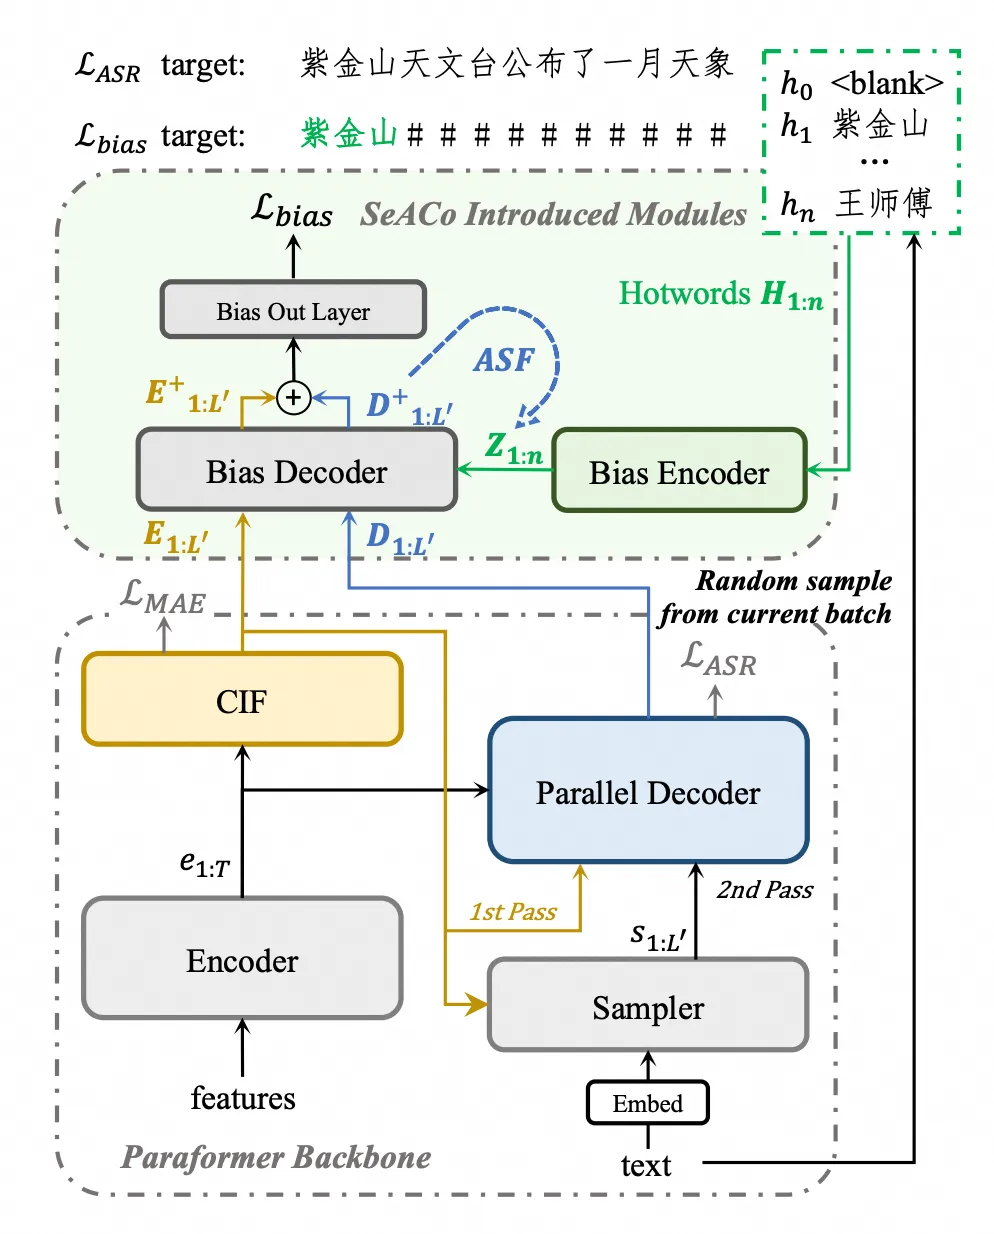
本文介绍阿里巴巴通义实验室语音团队自研的新一代基于神经网络的热词定制化模型SeACo-Paraformer(Semantic-Augmented Contextual-Paraformer),较前一代基于CLAS的Contextual-Paraformer有着生效稳定,训练灵活,召回率更高等优势。
WFST热词定制化
WFST热词激励方案从解码过程入手,召回稳定,但是需要在ASR模型推理之外进行基于N-gram的解码,并且对于一些训练数据中出现较少的词,ASR模型提供的后验概率过低,导致候选路径中没有包含待激励的词,此时基于WFST的热词增强大概率失效。
NN热词定制化--CLAS
在2018年,Google提出了Contextual Listen, Attend and Spell (CLAS)框架,在LAS这一经典的E2E ASR模型中进行了基于神经网络的热词定制化。CLAS主要通过两个核心思想进行热词建模:
在训练阶段从label中随机采样文本片段模拟热词; 在decoder的建模中引入额外的attention以建立文本隐状态与热词embedding的注意力连接。
在对通义实验室自研的非自回归端到端语音识别模型Paraformer进行NN热词定制化支持时,我们首先采用了结合CLAS算法的方案,开源了工业级Contextual-Paraformer模型,有很强的热词召回能力,受到开发者的关注与欢迎,Modelscope下载量490万余次。
SeACo-Paraformer
在Contextual-Paraformer开源一年之后,我们进一步开源新一代的NN热词定制化模型SeACo-Paraformer,旨在解决随机初始化CLAS模型生效不稳定的问题,同时进一步提升热词召回率。
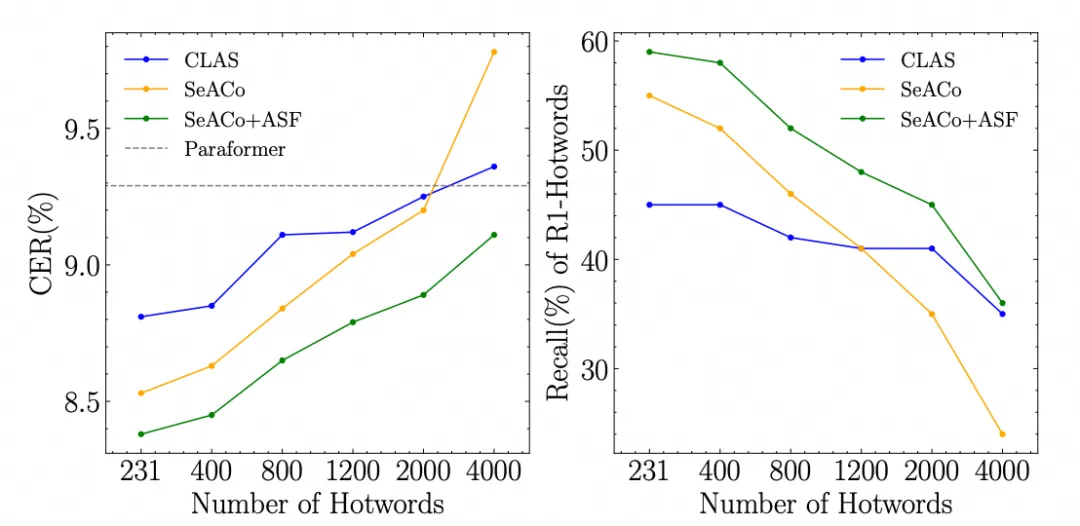
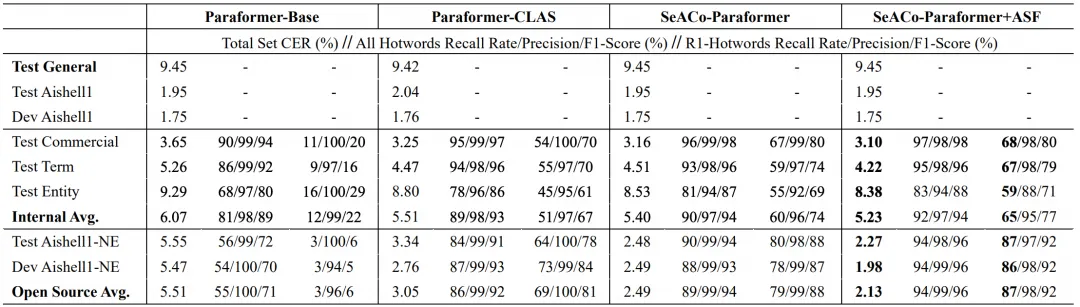
上表展示了在内部测试集与开源测试集上Paraformer基础模型以及三种热词模型的热词激励效果。以开源测试集为例,Paraformer-CLAS模型将低档位(在通用ASR识别中召回率低于40%)热词召回率从3%提升至69%,SeACo-Paraformer将这一指标进一步提升至79%,最后在ASF的加持下,召回率提升至87%(较Paraformer-CLAS相对提升26%)。
极速体验
from funasr import AutoModel

model = AutoModel(model="paraformer-zh", # seaco-paraformer的绑定名
                  vad_model="fsmn-vad", # 支持长音频输入
                  punc_model="ct-punc", # 进行标点恢复
                  spk_model="cam++" # 支持说话人识别
                  )

res = model.generate(input="your_speech.wav",
                     hotword='通义实验室 魔搭') # 配置热词
print(res) 参考文献:
