
 阿里语音AI
在语音技术领域,准确理解用户的语音指令和意图是构建高效人机交互系统的基础。一个高品质的语音交互系统不仅需要理解字面上的语言内容,更应捕捉到说话者语音中蕴含的情感信息。这正是语音情感识别(SER)技术要解决的问题:通过分析语音的声调、节奏、强度等副语言学信息,来判断说话者的情感状态,从而实现对人类意图的更真实和自然的理解。
https://github.com/ddlBoJack/emotion2vec
▎研究问题
为了应对这一挑战,我们提出了emotion2vec,这是一种通用的情感表示模型。它通过在262小时的开源情感数据上进行自监督预训练,并使用在线蒸馏范式来获得。鉴于音频中全局信息和局部细节都能表达情感,我们提出了一种结合句子级损失和帧级损失的预训练策略,来更好地捕捉情感信息。这种策略能够帮助模型学习到更为丰富和准确的情感特征,从而提高在各种情感任务上的表现。
▎提出方法
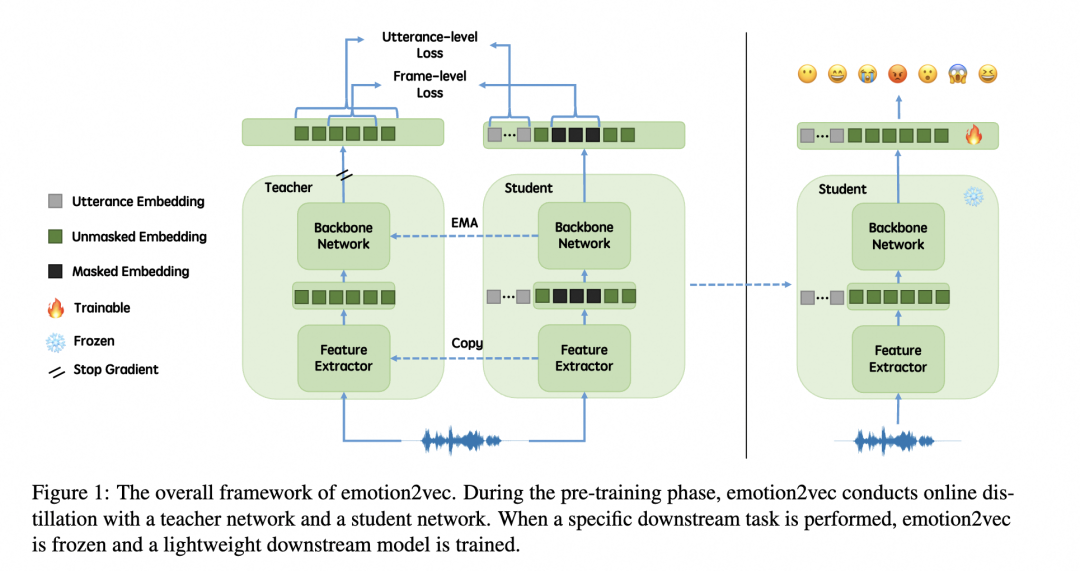
本文提出的emtion2vec为一种自监督预训练方法,其核心为句子级别损失与帧级别损失,以及在线蒸馏范式。
采用data2vec自监督框架,emotion2vec模型在预训练阶段包含两个网络:教师网络T和学生网络S。这两个网络拥有相同的架构,包括由多层卷积神经网络组成的特征提取器F,以及由多层Transformer组成的主干网络B。
>>>句子级别损失
文章进一步提出了三种计算句子级别损失的方法,即单嵌入(Token Embedding)、块嵌入(Chunk Embedding)和全局嵌入(Global Embedding)。
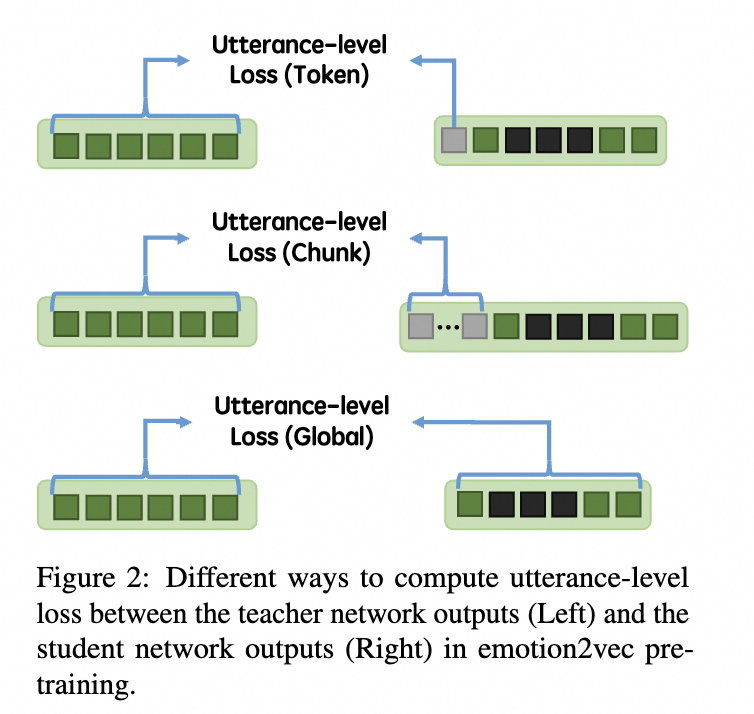
单嵌入(Token Embedding):通过一个单一的嵌入来代表学生网络S编码的全局情绪信息。具体来说,就是将可学习的言语嵌入U中的N设置为1。
块嵌入(Chunk Embedding):使用多个嵌入来表征全局情绪信息。在这种情况下,可以在一个块内聚合更多的全局信息。
全局嵌入(Global Embedding):在全局嵌入的情况下,并不添加额外的言语令牌。我们使用学生网络S的帧级别输出嵌入的时间池化结果。
这些方法为模型提供了不同的方式来集成和理解全局情感信息,进而在预训练过程中帮助模型更好地捕捉到情感的全局特性,为后续的情感识别任务奠定基础。
>>>帧级别损失
通过这种方式,模型能够专注于预测那些在输入中被随机掩盖的部分,从而学习到在给定上下文中预测情感所需的信息。这种训练方式促使网络能够更细致地理解情感的局部或帧级别变化,为后续基于帧的情感识别打下坚实基础。
>>>在线蒸馏
对于教师网络T,其参数T初始化为与学生网络S相同的参数,然后在每个小批量训练过程中通过EMA进行更新。这种在线蒸馏方法使得模型能够从师生两个网络中迭代学习,不断提升模型对情感特征的捕捉和理解能力。
▎实验结果
>>>IEMOCAP情感数据集上对比测试
从实验结果可以看出,emotion2vec在所有现有的SSL预训练模型中表现最佳,不论是参数规模相似的基础模型还是参数规模更大的大型模型。与通过从WavLM-large蒸馏得到的SER模型Versper-12相比,emotion2vec在使用更少参数的情况下取得了更好的性能。
此外,最新的SER专家模型如TIM-NET、MSTR和DST分别采用了不同规模的上游特征和下游网络。在仅使用线性层的情况下,emotion2vec的性能要么超过要么与这些模型相当,而后者的下游网络参数量分别是emotion2vec的2倍、135倍和114倍。
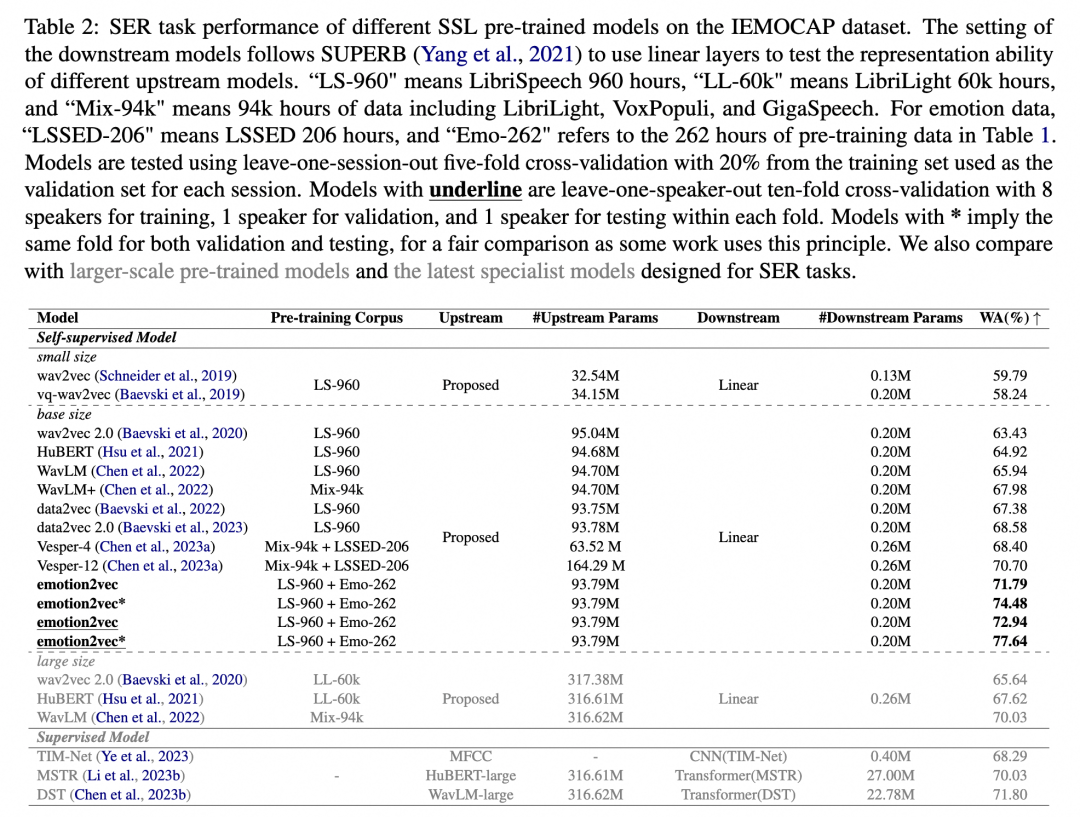
图示:IEMOCAP情感数据上对比结果
我们还在其他主流英语数据集上进行了实验,以证明emotion2vec在不同环境中的泛化能力,实验结果见Table3。其中,MELD是一个嘈杂的数据集,用于在复杂环境中测试模型的语音情感识别(SER)性能。RAVDESS和SAVEE是来自不同录音环境的跨领域数据集。
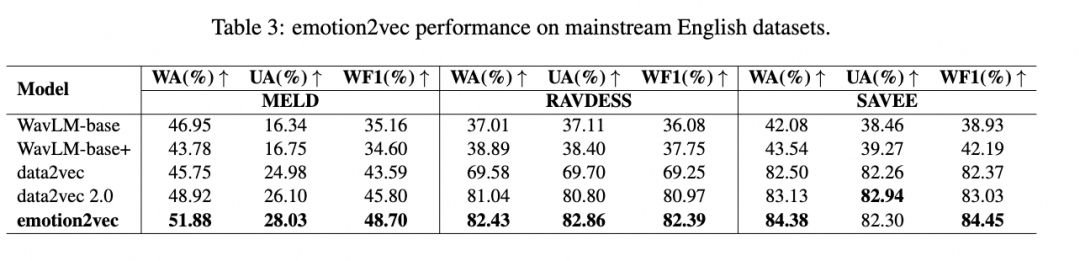
图示:其他主流英语数据集对比
实验结果表明,emotion2vec在不同数据集上都展现了最先进的性能。这证明了emotion2vec不仅能够在被训练的数据集上表现优异,还能够很好地适应不同的录音条件和背景噪声,有着良好的性能泛化能力。
>>>语种泛化性
我们按照SUPERB的评估标准,冻结了预训练模型,并训练下游线性层,隐藏层的维度设定为256,其中WavLM-base、WavLM-base+、data2vec、data2vec 2.0和emotion2vec是我们根据上述实践进行的实现。
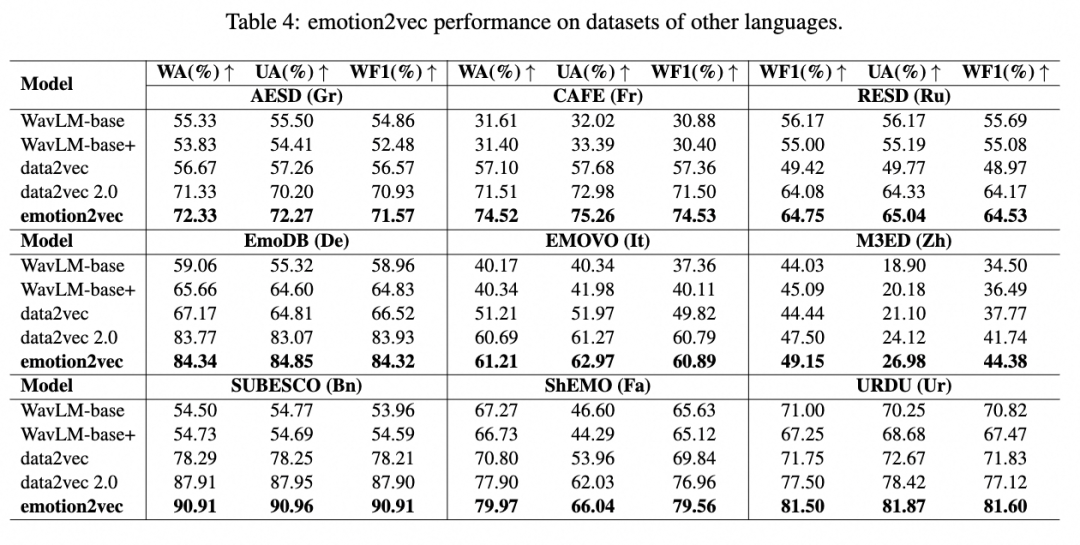
如Table4所示,emotion2vec在9种不同语言数据集上的加权平均(WA)、无权平均(UA)和加权F1(WF1)分数方面均优于所有SSL基线方法。这些结果证明了emotion2vec能够捕捉跨语言的情感模式,并展现了最先进的性能。这表明emotion2vec不仅在训练见过的语种上表现出色,还能够有效适应和识别训练未见的新语种中的情感特征,具有显著的语种泛化能力。
>>>任务泛化性
歌曲情感识别
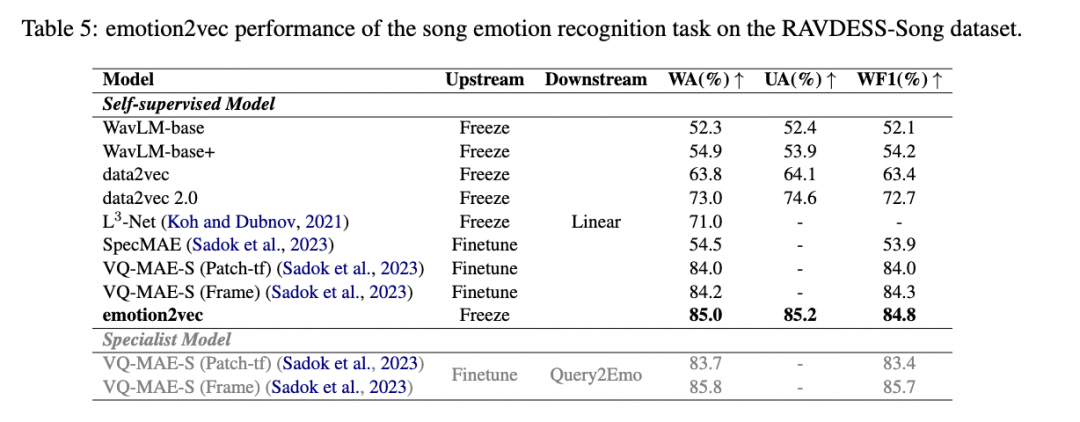
图示:歌曲情感识别
如Table5所示,在歌曲情感识别任务中,即使没有对模型进行微调,emotion2vec也胜过了所有已知的自监督学习(SSL)模型。这突显了emotion2vec在捕捉和理解歌曲中情感特征方面的卓越性能,进一步证明了其在不同情感识别任务中的有效性和强大的泛化能力。
对话中的情感预测
对话中的情感预测(EPC)指的是基于历史对话信息预测特定说话人未来的情感状态。我们复现了\cite{shi2023emotion}的方法,除了语音特征是使用我们提出的emotion2vec获得的。
简言之,该模型使用具有层次结构的多个GRU来进行情感预测。每次预测都会取对话的前6个回合,每个回合中一个说话人可以说多个话语。网络维度、超参数和训练策略与参考实现保持一致,并采用留一发言人外十折交叉验证。对于语音模态,输入是768维的emotion2vec特征;对于文本模态,输入是378维的BERT特征;对于语音+文本多模态,输入是emotion2vec特征和BERT特征的连接,也与参考实现保持一致。结果表明,在EPC任务中,用emotion2vec替换语音特征后,在单一语音模态和语音-文本多模态中均有性能提升。
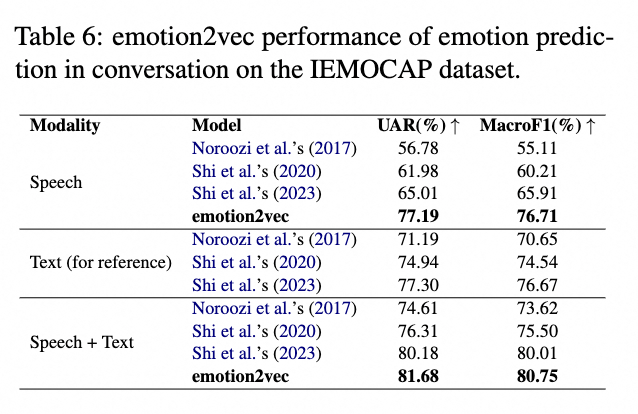
图示:对话中的情感预测
情绪分析
情绪分析是一项分析文本或语音的任务,旨在判断所传达的情感状态是积极的、消极的还是中性的。根据Lian et al. [5]的做法,我们去除了中性情绪,并在CMU-MOSI和CMU-MOSEI的标准训练/验证/测试集上分别进行二分类任务。同样遵循Lian et al. [5]的做法,我们使用预训练模型最后四层特征的平均值来训练下游线性层。
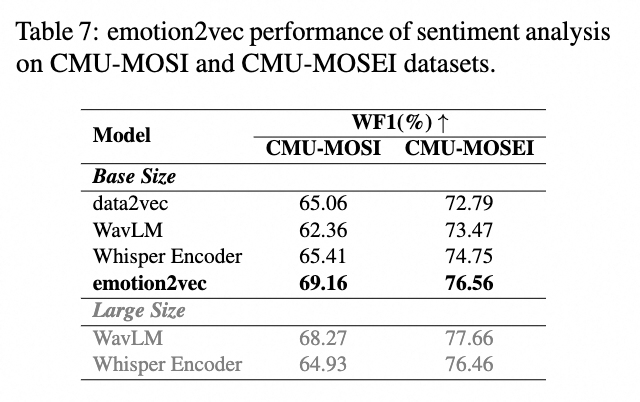
图示:情绪分析
如表格7所示,emotion2vec在使用自监督学习训练的data2vec和WavLM,以及在使用自动语音识别(ASR)任务进行监督学习训练的Whisper Encoder中表现最佳。这表明emotion2vec在情绪分析任务上的性能优于其他预训练模型,并证实了其在不同类型的情感任务中具有良好的泛化能力。
>>>表征可视化
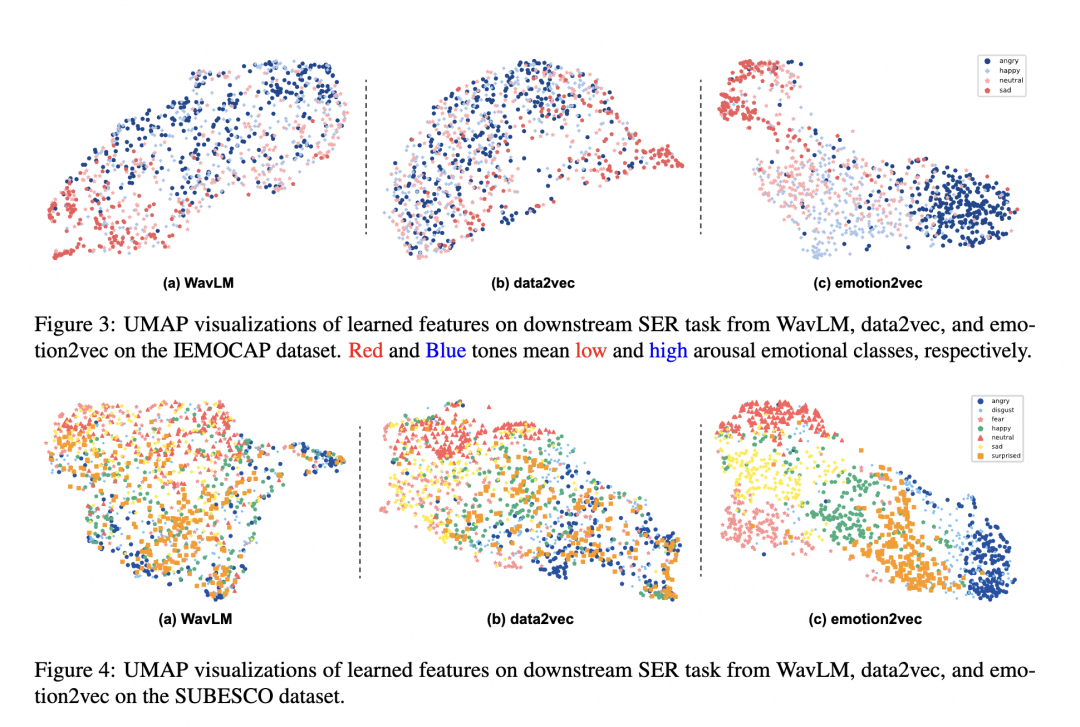
我们在IEMOCAP数据集上采用留一会话外(leave-one-session-out)评估策略,并在SUBESCO数据集上采用8:2的保留集评估,两种情况下我们都从训练集中随机选择了10%的样本作为验证集。具体来说,为了公平比较,在不同SSL模型相同的训练阶段之后,我们选择了第一线性层的表示进行可视化。
图4上可视化了不同SSL模型对唤起值(arousal)的表示。在某种意义上,唤起值指的是情感强烈程度。图3上(a) 和图3上 (b)显示高唤起值和唤起值情感类别之间存在大量重叠。相比之下,图3上(c) 显示高唤起值和低唤起值的表示分别聚类,并且特征分布展示了从高唤起值过渡到低唤起值的趋势,与其他方法相比更为合理。
图4下展示了不同SSL模型表示离散情感类别的能力。如图3下 (a)和图3下 (b)所示,WavLM和data2vec存在类别混淆的问题。相反,emotion2vec学习的特征展现了更高的类内紧凑性和更大的类间间隔。
这些结果表明emotion2vec提供了更具类别区分性和情感感知性的表示,以支持其卓越的性能。
▎Future Work
在这篇论文中,我们提出了emotion2vec,这是一个通用的情感表示模型。emotion2vec通过自监督在线蒸馏在262小时的未标记情感数据上进行预训练,从而获得了通用的情感表示能力。我们证明了在情感预训练过程中结合使用句子级别损失和帧级别损失的策略是有效的。
通过广泛的实验,我们证明了所提出的emotion2vec具有跨不同任务、语言和场景提取情感表示的能力。在未来,我们将探索情感表示模型的规模化定律,即如何通过更多数据和更大的模型参数提供更好的表示。这意味着,我们将研究在数据规模和模型复杂性增加时,如何优化情感表示模型的性能,并将情感表示的准确性和泛化能力提升到一个新的水平。
参考文献:
[1] Ma, Ziyang, et al. "emotion2vec: Self-Supervised Pre-Training for Speech Emotion Representation." arXiv preprint arXiv:2312.15185 (2023).
[2] Chen, Weidong, et al. "Vesper: A compact and effective pretrained model for speech emotion recognition." IEEE Transactions on Affective Computing (2024).
[3] Yang, Shu-wen, et al. "SUPERB: Speech processing universal performance benchmark." Proc. Interspeech (2021).
[4] Shi, Xiaohan, et al. "Emotion Awareness in Multi-utterance Turn for Improving Emotion Prediction in Multi-Speaker Conversation." Proc. Interspeech (2023).
[5] Lian, Zheng, et al. "MER 2023: Multi-label learning, modality robustness, and semi-supervised learning." Proceedings of the 31st ACM International Conference on Multimedia. (2023).
