 阿里语音AI
(8月发布)FunASR实时语音听写软件包:
实时语音听写软件包介绍
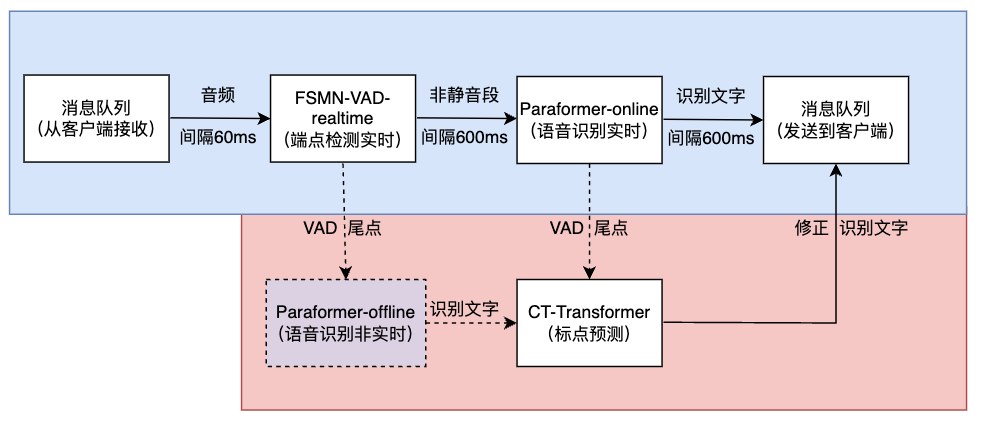
图1 FunASR实时语音听写服务架构图
FunASR实时语音听写服务包架构如图1所示,集成了实时语音端点检测模型(FSMN-VAD-realtime),语音识别实时模型(Paraformer-online),语音识别非流式模型(Paraformer-offline),标点预测模型(CT-Transformer)。采用多模型协同,既可以实时的进行语音转文字,也可以在说话句尾用高精度转写文字修正输出,输出文字带有标点,支持多路请求。
软件包同时支持websocket与grpc协议,支持以下几种推理配置(mode):
实时语音听写服务(ASR-realtime-transcribe)
非实时一句话转写(ASR-offline-transcribe)
实时与非实时一体化协同(ASR-realine&offline-twoPass)
软件包优势
>>便捷部署
FunASR社区提供了实时语音听写软件包一键部署方案,开发者可以通过funasr-runtime-deploy-online-cpu-zh.sh一键完成docker安装、镜像启动、服务部署,详见语音识别实时听写服务便捷部署教程👇:
>>高实时性
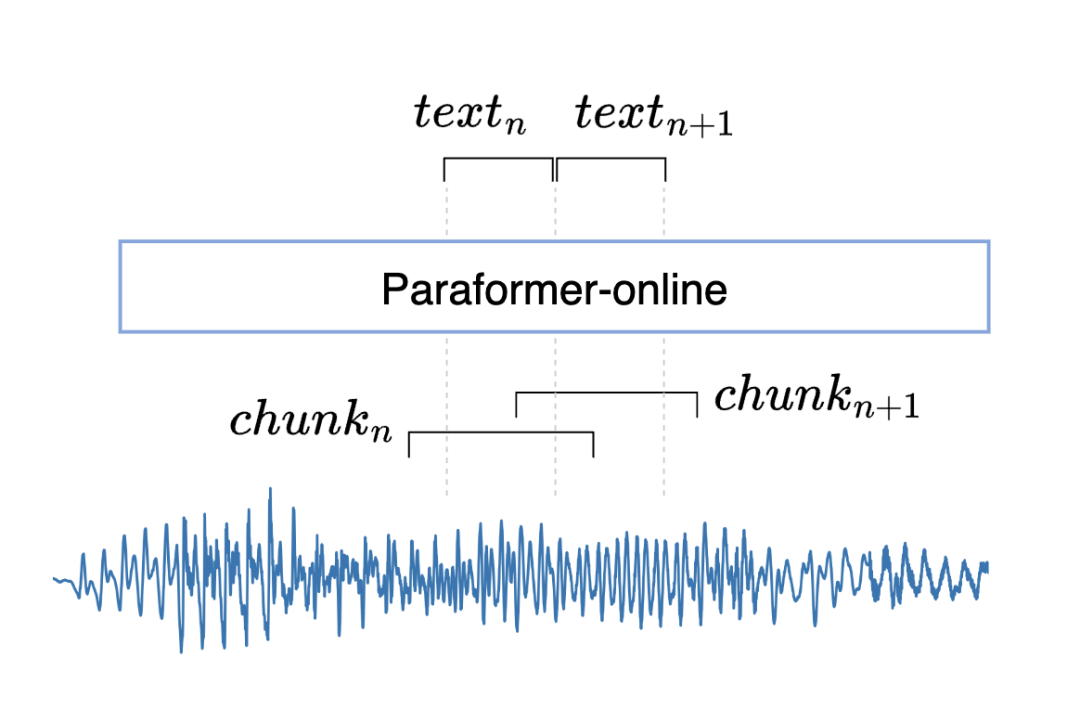
FunASR语音实时听写软件包,集成了达摩院自研的Paraformer流式实时模型,采用工业大数据训练的非自回归流式识别模型,相比于自回归模型,具有高计算效率与高实时性的优点。
>>高精度
FunASR软件包集成了达摩院语音实验室在ModelScope开源的基于Paraformer实时和非实时非自回归端到端语音识别模型。这些模型均数万小时工业数据训练,保证了端到端识别的精度。
下方表格对比了Paraformer-large非实时与实时版本与当前最优SOTA模型识别效果:
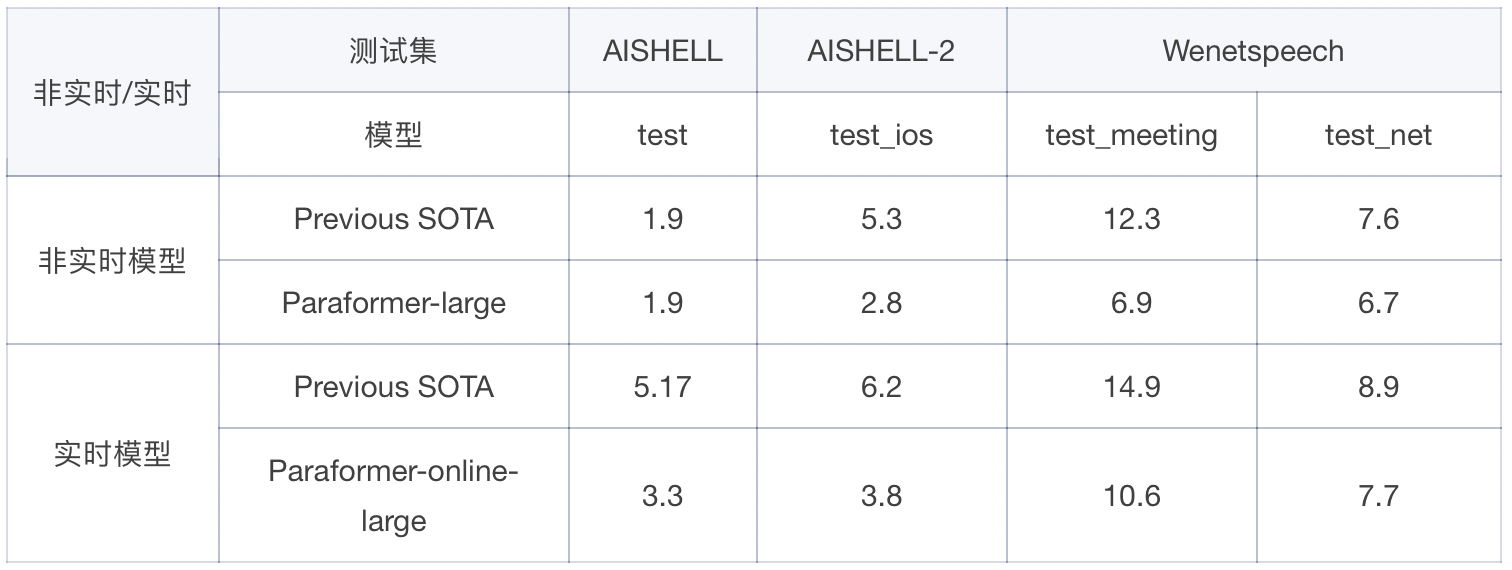
FunASR提供了一套完整的语音识别服务链路,采用多模型协同方案,包括语音端点检测(VAD)、语音识别非实时与实时(ASR)、标点预测(PUNC)。既可以实时的进行语音转文字,也可以在说话句尾用高精度转写文字修正输出,输出文字带有标点,支持多路请求。同时,用户也可以根据业务场景需要,配置为实时语音识别、非实时一句话识别,以及实时与非实时一体化协同等可选择场景。
https://mp.weixin.qq.com/s/DHQwbgdBWcda0w_L60iUww
使用指南
FunASR实时语音转写软件包当前已经开源。
https://github.com/alibaba-damo-academy/FunASR/blob/main/funasr/runtime/docs/SDK_tutorial_online_zh.md
操作步骤如下:
curl -O https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/shell/funasr-runtime-deploy-online-cpu-zh.sh第二步:安装部署
sudo bash funasr-runtime-deploy-online-cpu-zh.sh install --workspace ./funasr-runtime-resources第三步:测试与使用
运行上面安装指令后,会在./funasr-runtime-resources下载samples, 为客户端测试工具,支持python/c++/java/html网页等语言。