
 语音小管家
基于神经网络的方法使语音分离技术取得显著进步,在信号层面的指标上表现更佳。然而,这些方法往往难以在分离信号中保持语音可懂度,这会对语音识别等下游任务的性能产生负面影响。本文提出SLM-SS方法,通过将语音语言模型应用于语音分离,旨在提升分离信号的可懂度与连贯性。我们采用编码器-解码器模型将量化后的混合语音映射至目标词元,将语音分离问题建模为离散多码本序列生成任务。除自回归建模策略外,我们引入非自回归模型以提升残余词元的解码效率。在LibriMix数据集的实验结果表明,相较于现有方法,本方案显著提升了语音可懂度的保留能力,从而在多种下游任务中实现了更优的语言一致性。
作者列表:Tianhua Li, Chenda Li, Wei Wang, Xin Zhou, Xihui Chen, Yanmin Qian
合作单位:上海交通大学,宇生月伴
背景与简介
语音分离是语音处理中的关键任务,旨在从混合重叠信号中分离出独立的语音源,其应用领域包括自动语音识别(ASR)、说话人识别(SID)及助听器等。当前研究多采用判别方法处理语音分离问题如BSRNN,Sepformer,通常以尺度不变信号失真比(SI-SDR)等指标进行训练。尽管这些方法在波形重建方面有效,但往往无法保持语音可懂度,引入的失真会降低ASR等下游任务的性能。
相比之下,大语言模型(LLMs)的最新进展通过量化或离散语音标记实现了声学与语言信息的更紧密融合,从而显著提升了各类语音处理任务的性能。在文本转语音(TTS)、目标说话人提取(TSE)、自动语音识别(ASR)等领域,一些最新的研究使用LLM进行建模,取得了较好性能,验证了离散标记建模在语音分离及生成与识别之外的多任务语音处理中的有效性,彰显了该建模方法在生成与识别任务之外的应用价值。
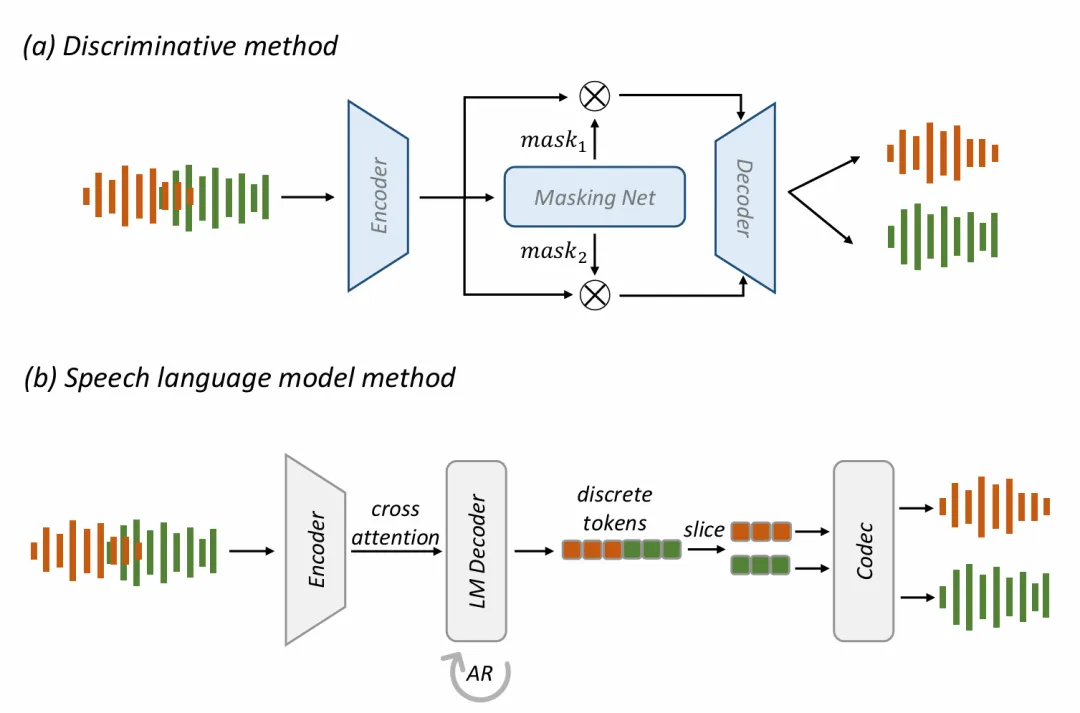
Figure 1:基于判别式和SLM的语音分离模型范式对比
在本研究中,我们提出SLM-SS框架,通过结合语音语言模型(SLMs)与量化编解码器来提升分离语音的可懂度。我们采用Encodec将语音转换为离散字典序列。这些序列通过串行化输出训练(SOT)进行拼接,该方法借鉴了当前ASR研究成果,并由基于Transformer的自回归(AR)编码器-解码器模型实现:编码器从混合信号中提取特征,解码器通过交叉注意力机制将特征与离散序列对齐。为进一步提升语音质量,我们引入非自回归(NAR)模型,通过从低阶码本预测高阶码本来提高解码效率。该框架为语音合成提供了生成式替代方案,不仅显著提升语音可懂度,更在下游任务中展现出卓越性能。
语音分离的生成式建模
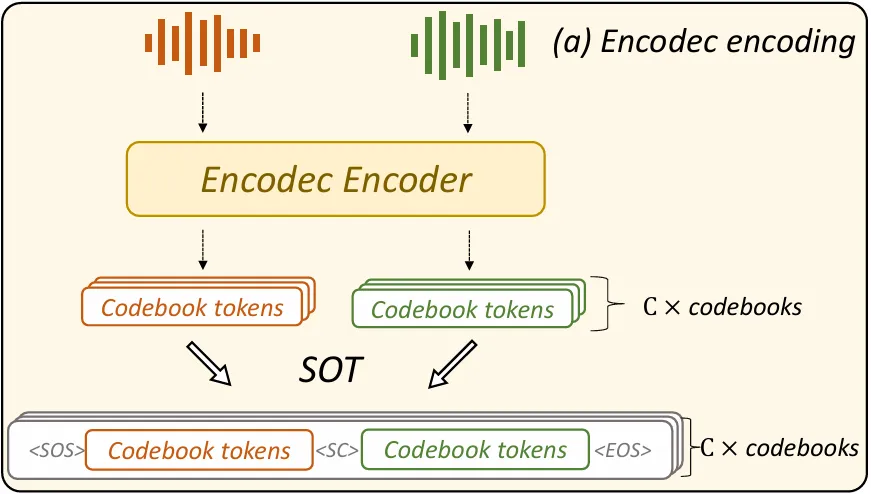
Figure 2:连续音频到SOT离散码本序列的生成过程
我们采用Encodec模型将连续音频映射为紧凑的离散表示。编码过程生成32阶码本,其词表大小为1024。在编码器-解码器框架内,我们从数据集提供的多说话者片段中提取并编码单说话者片段。随后采用SOT策略将多码本序列拼接:引入转写起始符号
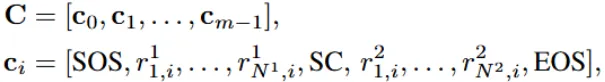
通过SLM-SS方法获得完整的多阶SOT序列后,我们使用
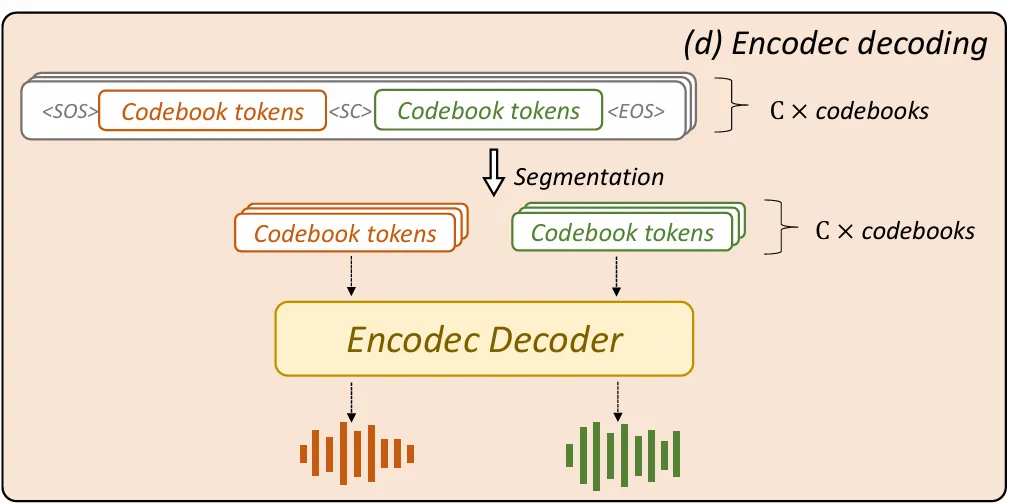
Figure 3 :SOT序列切片后经Encodec还原成单人音频
渐进式编解码器序列生成中的混合解码
零阶序列的自回归模型
对于编码器,我们选用了预训练的WavLM模型,一种基于Transformer的强大特征编码器,并选择在WavLM预训练权重基础上进行微调。对于解码器,我们遵循Whisper解码器的设计构建模型,并从零开始训练。词表包含编码器模型的编码本大小,以及用于SOT任务的三个特殊符号:
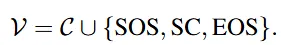
在获取零阶码本序列时,编码器首先将多人音频编码为深度特征。为整合WavLM中各隐藏层的能力,我们设计了一个线性层来融合所有层的特征。经过层归一化后,深度特征被输入解码器。随后,自回归解码器基于编码后的音频特征、交叉注意力机制以及历史token序列,预测新一个token的概率分布:
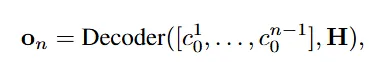
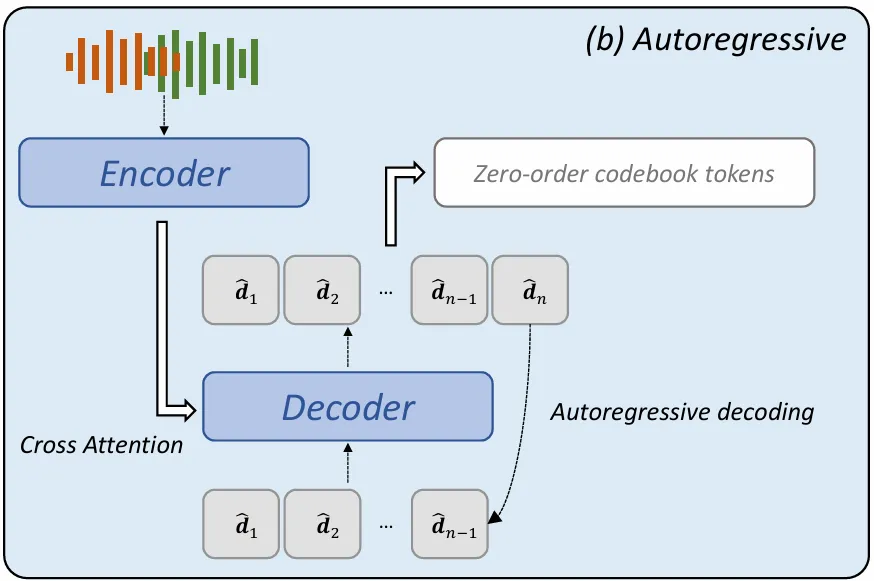
Figure 4:零阶码本序列的自回归生成
高阶序列的非自回归模型
在预测高阶码本时,为加快推理效率,我们引入了非自回归(NAR)模型。我们采用与AED模型相同的架构,但移除单向掩码以实现NAR模型。为实现多阶码本的协同训练,我们设计了八个共享相同位置嵌入的独立词嵌层。此外,我们引入任务嵌入机制,使模型能够识别当前码本预测任务类型。
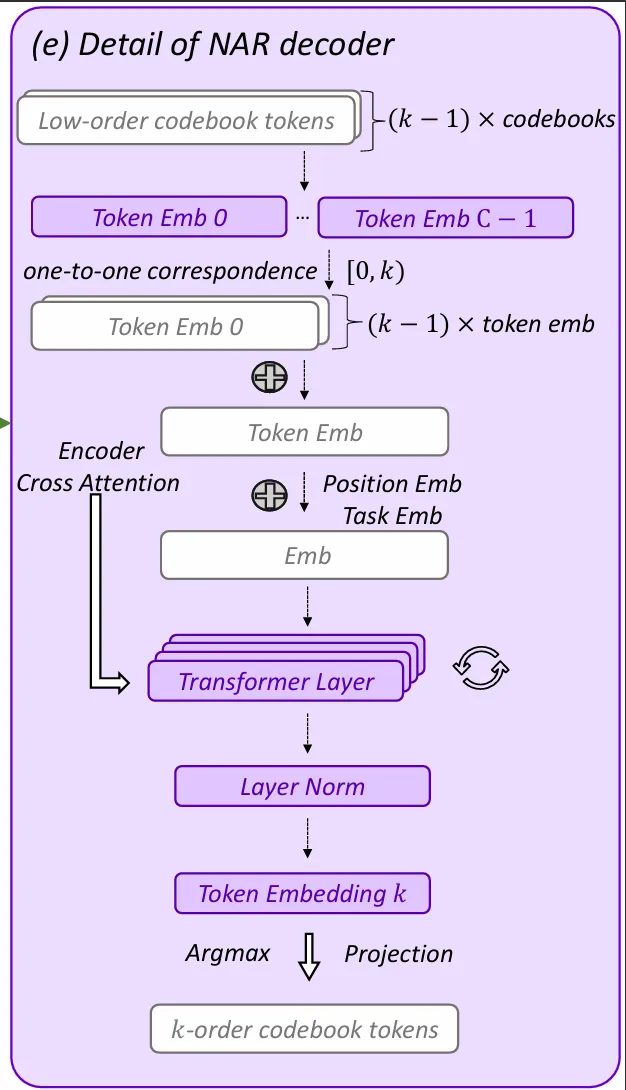
Figure 5:非自回归解码器的详细架构
在预测某一非零阶编码本序列时,必须同时考虑所有低阶编码本序列的信息。这需要对所有低阶序列进行嵌入并求和,再结合位置嵌入和任务嵌入,最终获得总嵌入向量:
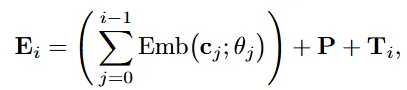
随后,总嵌入被输入到一系列Transformer层进行深度建模,从而获得深层隐空间特征。最后,将其投影到目标阶数码本的词元嵌入矩阵上,从而为该阶码本序列中的所有词元生成概率分布:
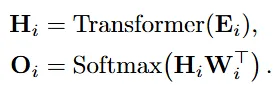
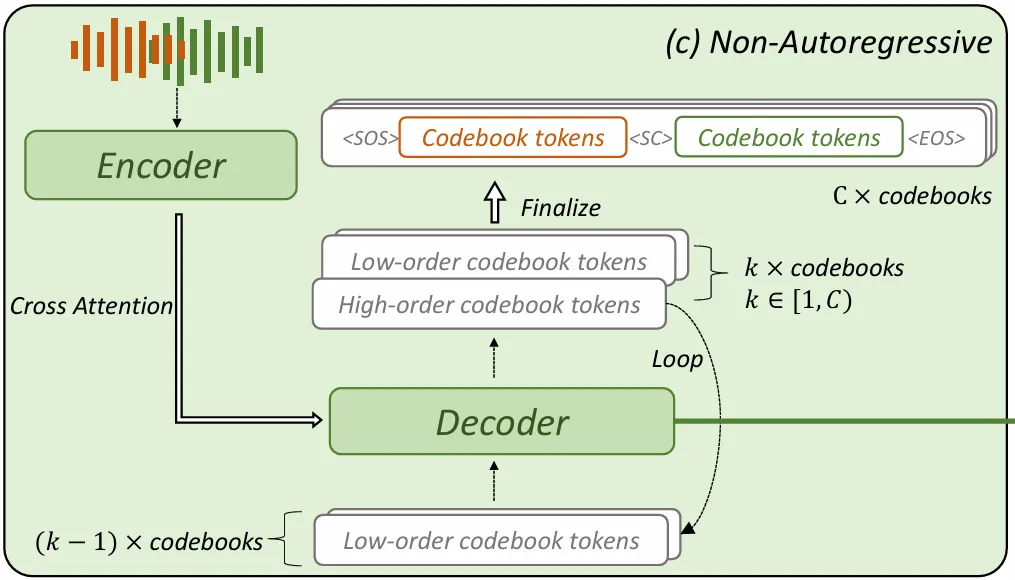
Figure 6:高阶码本序列的迭代式非自回归生成
实验分析
在LibriMix数据集上与BSRNN,Sepformer等判别式方案进行了比较,在对下游任务的支持和主观听感测试上,SLM-SS方案均好于判别式模型。
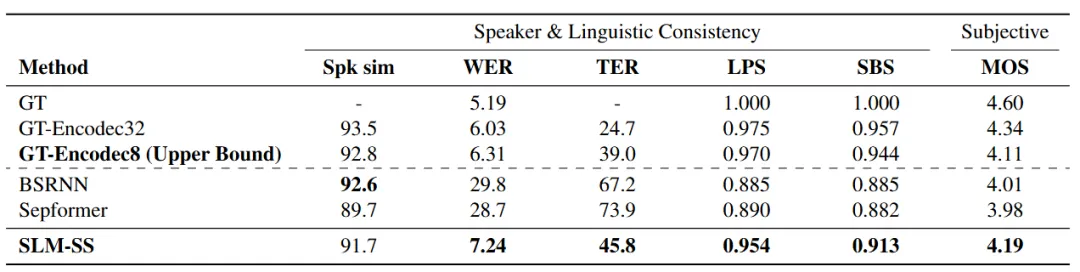
Table 1: SLM-SS与其他判别式方法的性能比较
由于NAR模型需要结合所有低阶码本信息,因而其训练难度较高,若全部使用32阶码本,训练难度和计算开销是不可接受的,考虑到其残差特性,我们最终选择前8阶作为训练目标。参数消融实验可以看出,当使用的码本阶数超过6以后,对模型的性能提升增幅大幅衰减。
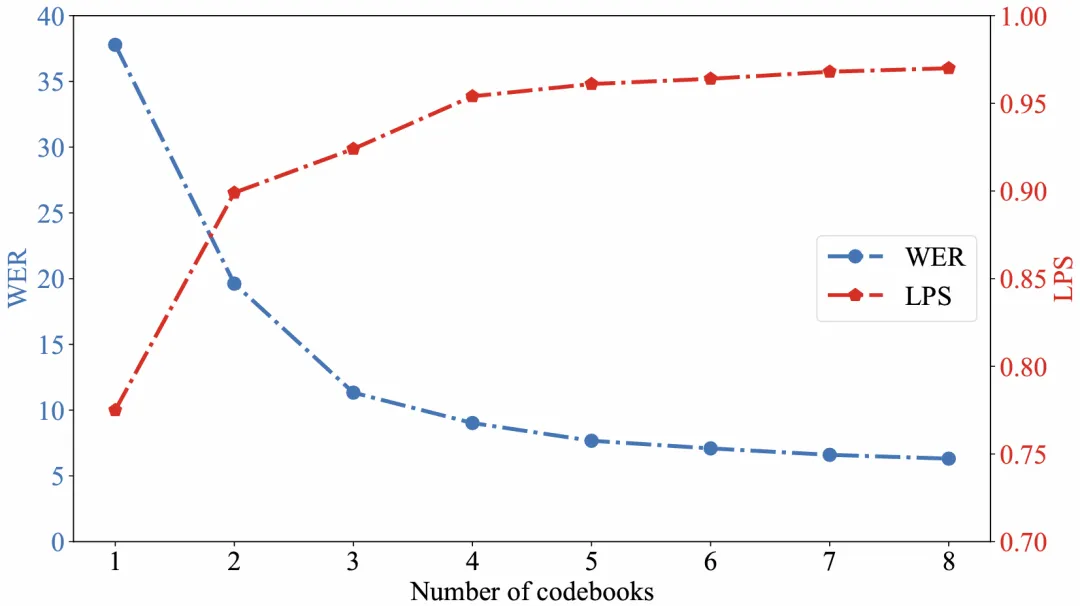
Figure 8:码本的数量对性能的影响
我们测试了零阶AR模型在不同温度下进行自回归解码的性能差距,可见我们的方案在原温度下具有最强的能力,不需要进行额外的温度调整。
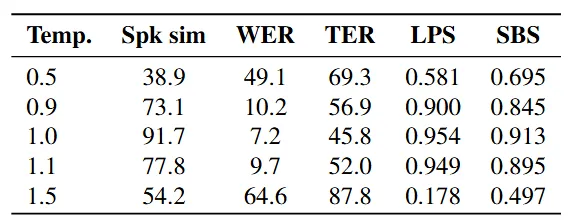
Table 2:自回归温度对性能的影响
本文总结
本文提出基于SLM的语音分离算法——SLM-SS。通过Encodec将连续语音信号离散化为多码本序列后,我们依据SOT策略将它们进行拼接。我们首先采用AR模型获取零阶码本,再运用NAR模型逐级预测高阶码本。最终的多码本序列经Encodec切片解码后,可生成纯净的单说话人音频。大量实验验证了本方法的有效性。
参考文献
[1] Y. Luo and N. Mesgarani, “TaSNet: Time-Domain Audio Separation Network for Real-Time, Single-Channel Speech Separation,” in 2018 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE Press, 2018, p. 696–700.
[2] Y. Luo, “Conv-TasNet: Surpassing Ideal Time-Frequency Magnitude Masking for Speech Separation,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 27, no. 8, pp. 1256–1266, 2019.
[3] Y. Luo and J. Yu, “Music Source Separation With Band-Split RNN,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 31, pp. 1893–1901, 2023.
[4] C. Subakan and J. Zhong, “Attention Is All You Need In Speech Separation,” in ICASSP 2021 - 2021 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 2021, pp. 21–25.
[5] B. Chen and W. Zhao, “SEPDIFF: Speech Separation Based on Denoising Diffusion Model,” in ICASSP 2023- 2023 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 2023, pp. 1–5.
[6] R. Scheibler and M.-S. Choi, “Diffusion-Based Generative Speech Source Separation,” in ICASSP 2023 – 2023 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 2023, pp. 1–5.
[7] S. Chen and F. Wei, “Neural Codec Language Models are Zero-Shot Text to Speech Synthesizers,” IEEE Transactions on Audio, Speech and Language Processing, vol. 33, pp. 705–718, 2025.
[8] B. Seed Team, “Seed-TTS: A Family of High-Quality Versatile Speech Generation Models,” arXiv preprint arXiv:2406.02430, 2024.
[9] B. Tang, B. Zeng, and M. Li, “TSELM: Target Speaker Extraction using Discrete Tokens and Language Models,” 2024.
[10] S. Chen, X. Xiao et al., “WavLM: Large-scale Self-supervised Pre-training for Full Stack Speech Processing,” IEEE Journal of Selected Topics in Signal Processing, vol. 16, no. 6, pp. 1505–1518, 2022.
[11] Y. Wang and X. Wu, “UniSep: Universal Target Audio Separation with Language Models at Scale,” in 2025 IEEE International Conference on Multimedia and Expo (ICME), 2025, pp. 1–6.
[12] N. Zeghidour, A. Luebs, A. Omran, J. Skoglund, and M. Tagliasacchi, “SoundStream: An End-to-End Neural Audio Codec,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 30, pp. 495–507, 2022
供稿:李天骅,编辑:方楠,审核:钱彦旻
