NCMMSC2025丨ASLP实验室6篇录用论文分享

2025年第二十届全国人机语音通讯学术会议(National Conference on Man-Machine Speech Communication,NCMMSC2025)将于2025年10月16~19日在江苏镇江召开。本次会议由中国…
21 0 0

2025年第二十届全国人机语音通讯学术会议(National Conference on Man-Machine Speech Communication,NCMMSC2025)将于2025年10月16~19日在江苏镇江召开。本次会议由中国…
来源丨机器之心 单 GPU 级世界模型来了。斯坦福大学教授李飞飞创业公司 World Labs 又推出了新成果! 上个月,World Labs 发布了空间智能模型 Marble,「只需一张图片,就能生成持久存在的 3D 世界,比以往更宏大、…
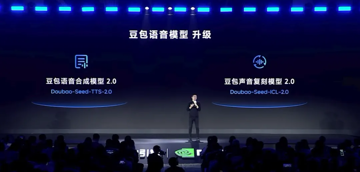
今天,火山引擎发布了豆包语音合成模型2.0(Doubao-Seed-TTS 2.0)和豆包声音复刻模型2.0(Doubao-Seed-ICL 2.0)。此次升级基于豆包大语言模型研发语音合成新架构,让合成和复刻的声音都能解锁深度语义理解和上…
在自然人机交互中,实现如同人类般“边听边说”的全双工语音对话(Full-duplex Spoken Dialogue)一直是语音交互系统的终极目标。与传统的半双工系统不同,全双工系统要求模型能够在用户发言过程中,实时判断是否需要继续倾听、生…
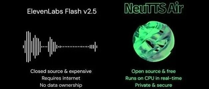
分享一款开源 TTS 模型:NeuTTS Air,它是一款免费、开源、轻量级的超逼真语音合成模型。 仅 0.5B 参数,但实际体验几乎媲美市面上许多商用 TTS 引擎。更关键的是,它能在手机、笔记本甚至树莓派这样的低功耗设备上流畅运行,真正…
时空壶成⽴于 2016 年,在中国深圳和美国德克萨斯州普莱诺设有双重运营总部。公司致⼒将⼈⼯智能技术和语⾔科学相结合,开创业界⾸个AI同传翻译⼤模型⸺Babel OS 系统,并打造享誉全球的同传翻译⽿机产品,推动翻译产品从 App、⼿持翻译…
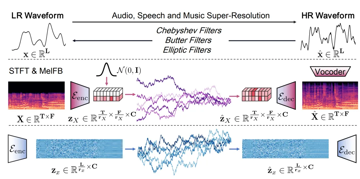
音频超分辨率(Audio Super-Resolution, Audio SR),即从低采样率音频恢复出高采样率版本,是提升语音清晰度、音乐细节与沉浸式音频体验的关键技术。无论是在老旧录音修复、语音通信增强,还是音乐制作与多模态生成中,高分…
