
 语音小管家
大家好,欢迎来到「AudioCC交我学」专栏!
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
一、背景:基于生成式模型的语音增强
近年来,生成式模型(Generative model)为语音增强(Speech enhancement)带来了革命性的变化。其核心思想发生了根本转变:
传统判别式思路:学习一个从含噪语音到纯净语音的直接映射函数。这通常是一个“平均”效应,可能导致过度平滑,失去语音的细节和自然度。
生成式思路:不直接学习映射,而是学习纯净语音本身的概率分布。在增强时,模型从一个简单的初始分布(通常是含噪语音或高斯噪声)出发,通过一个学习到的去噪或净化过程,一步步将其塑造成符合纯净语音分布的信号。
基于生成式方法的语音增强模型具备以下优势:
生成式模型能产生更多样、更自然的语音(尤其体现于在非侵入式指标上表现更佳,例如DNSMOS,NISQA,WVMOS等指标),因为它是在“创造”符合纯净语音特性的信号,而不是做一个简单的减法。
生成式模型具备更强的泛化性能,对未知噪声类型有更好的鲁棒性。理论上可以生成训练集中未出现过的、但合理的语音内容,从而更好地恢复被严重掩盖的语音部分。
生成式模型在真实采集的增强数据上表现更佳。
而本次分享的主题:流模型(Flow-based model)正是当前最先进的生成式模型家族中的重要成员。
二、流模型的前身:扩散(diffusion)模型
代表性工作:Speech Enhancement and Dereverberation With Diffusion-Based Generative Models(TASLP 2023)
这篇论文提出了一种基于分数匹配(Score-matching)的生成模型SGMSE+来处理语音增强与去混响任务。其核心方法在于设计了一个基于随机微分方程(SDE)的条件扩散过程,该过程直接在复数短时傅里叶变换(STFT)域中进行。
方法概述
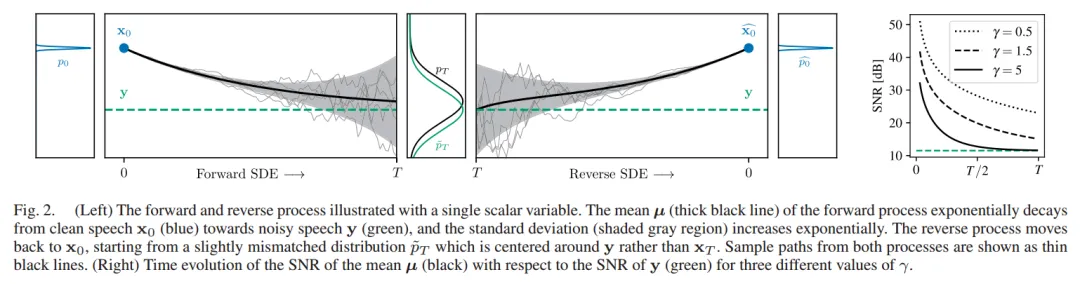
模型定义了一个前向加噪过程和一个对应的逆向去噪过程,在简单的、易获取的带噪语音分布和复杂的、未知的干净目标语音分布之间建立一个映射。前向过程通过一个包含漂移项的随机微分方程(SDE),将纯净语音逐渐扰动为带噪(或混响)语音与高斯噪声的混合体。其中,漂移项被设计为引导均值从纯净语音平滑地过渡到带噪语音。反向(生成)过程则从一个强噪声污染的带噪语音状态开始,利用一个训练好的分数模型(即神经网络)来估计每一步的分数函数(梯度),并通过求解反向SDE,逐步迭代地生成对纯净语音的估计。
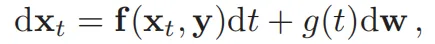
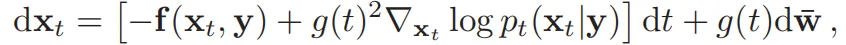
该方法的一个关键创新是将任务目标(从带噪语音生成纯净语音)直接融入到SDE的前向和反向过程设计中,而非像传统的扩散模型那样依赖额外的辅助损失或条件机制。论文采用了改进的NCSN++网络架构(一种多分辨率U-Net)作为分数模型,以处理复数谱图。
主要实验结论
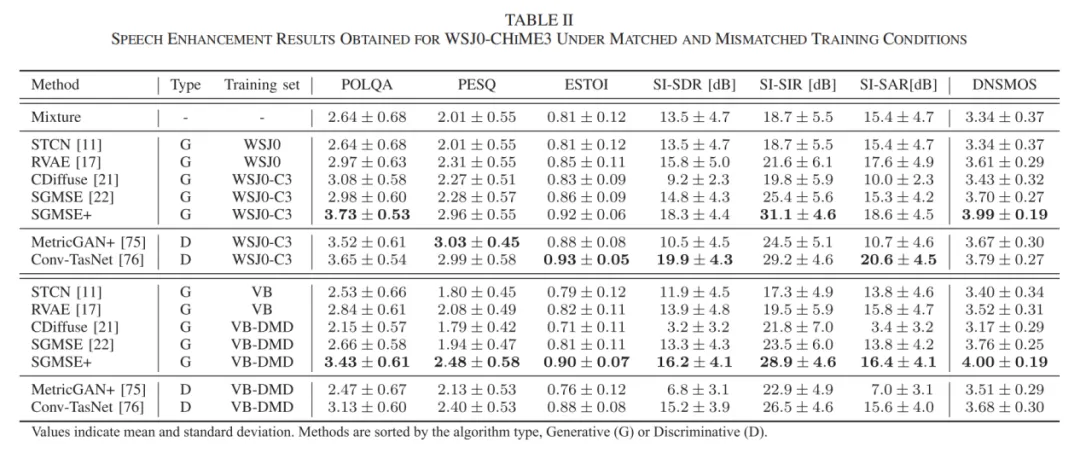
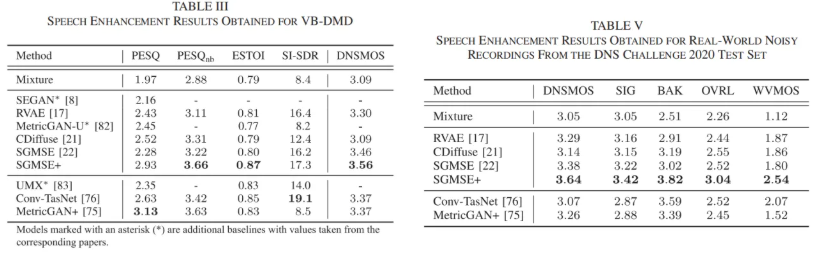
在语音增强任务上,该方法在集内测试中,其性能与先进的判别式模型相当,甚至在多项感知质量指标(如POLQA)和非侵入式指标(如DNSMOS)上表现更优。
在跨数据集评估中,该方法显著优于所有基线模型(包括生成式和判别式),显示出其优异的泛化能力。主观听力实验也证实了该方法在感知质量上获得最高评分。
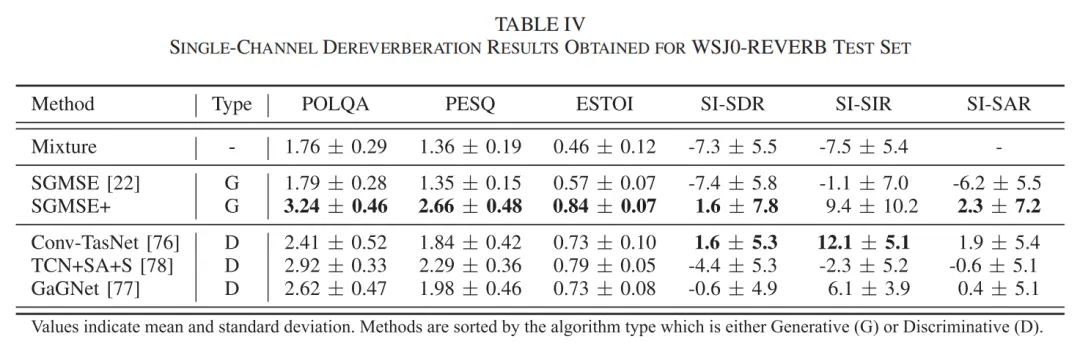
该方法同样适用于语音去混响任务,在该任务上的表现大幅超越了专门的判别式基线模型,表明该生成式框架能够适应不同类型的语音失真。
三、基于流模型的语音增强
代表性工作一:FlowSE: Flow Matching-based Speech Enhancement(ICASSP2025)
这篇论文提出了一种基于条件流匹配(Conditional flow matching)的语音增强模型FlowSE,旨在解决扩散模型中反向迭代步数较多,推理速度慢的问题。
方法概述
FlowSE的核心是利用常微分方程(ODE)定义的连续归一化流,来建模从带噪语音到纯净语音的概率路径。具体而言,该方法对最优传输条件向量场(Conditional vector field)进行了调整,使其均值路径从带噪语音线性地流向纯净语音,同时标准差线性衰减至零。
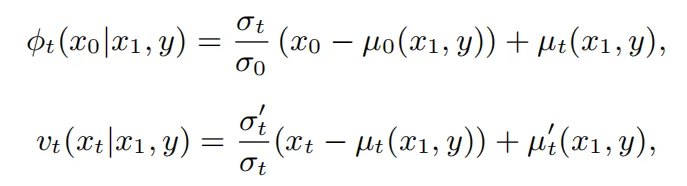
文中通过一个神经网络来学习这个条件向量场,训练时采用条件流匹配(Conditional flow-matching)损失。在推理阶段,只需从以带噪语音为中心的高斯分布中采样一个初始点,然后使用欧拉法(Euler method)求解ODE,即可生成对纯净语音的估计,并且这个求解过程通常只需要1至5步迭代,大幅优于扩散模型中普遍的25步以上。论文还证明了该方法可以等价于一个具有特定漂移和扩散系数且采用特定求解方式的扩散模型:
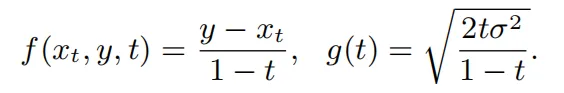
主要实验结果
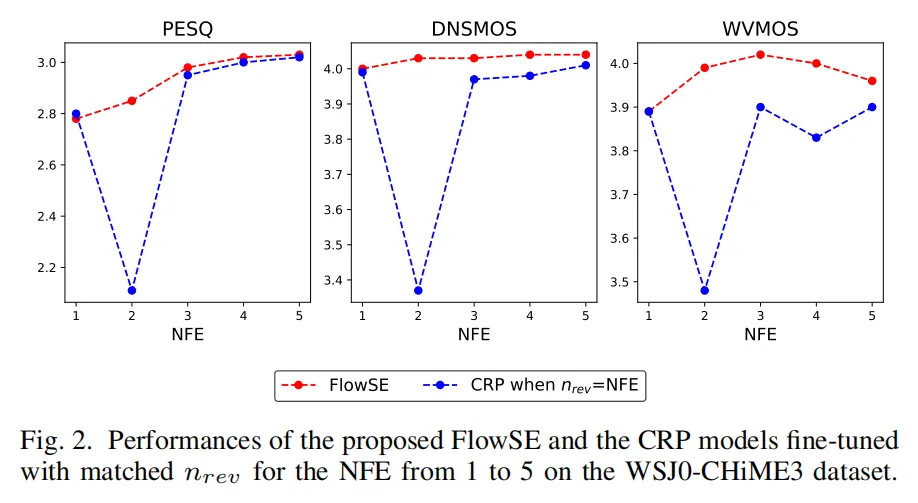
在WSJ0-CHiME3和VoiceBank-DEMAND数据集上的实验表明,FlowSE仅需5步反向迭代推理,其性能即可与需要60步推理的基线模型BBED相媲美,并且显著优于仅用5步的BBED模型
FlowSE的性能与经过反向过程校正(Correcting the Reverse Process)微调的CRP模型相当,但FlowSE是直接训练得到的,不需要额外的微调步骤。即使在不同推理步数(1到5步)下,单个FlowSE模型也能达到与对应步数专门微调的CRP模型相似的效果。
实验还表明,使用分数匹配来训练其等价的扩散模型,在5步推理下也能达到与使用流匹配训练FlowSE相似的效果。这证明了通过设计合适的概率路径,扩散模型本身也能实现高效采样,无需复杂的事后校正。
流模型(FlowSE)与扩散模型(SGMSE+)的核心差异分析
尽管流模型和扩散模型同属生成式模型,并且论文中指出它们在数学上存在等价关系,但它们在具体实现、训练目标和推理效率上存在显著差异:
1. 确定性和随机性
流模型基于常微分方程(ODE),描述的是一个确定性的过程。从起点(带噪语音加一点高斯噪声)到终点(纯净语音)的路径是唯一且确定的。而扩散模型基于随机微分方程(SDE),其反向过程包含一个随机性的布朗运动项。这使得生成过程具有随机性,虽然大方向正确,每次生成的路径可能略有不同。
2. 训练目标的差异
流模型的训练目标是让神经网络直接学习一个向量场。这个向量场指明了在流程的任何一个中间状态,应该朝哪个方向“流动”才能到达纯净语音。而扩散模型的训练目标是让神经网络学习分数函数(即梯度场)。这个分数描述了数据分布的概率密度增长最快的方向,其本质是在对数据分布进行“去噪”。
3. 推理效率的差异
流模型由于其确定的ODE路径,通常可以用极少的步数(如1-5步)就达到很高的生成质量,推理速度非常快。而扩散模型由于其随机性和需要模拟更复杂的噪声扰动过程,通常需要更多的迭代步数(如30-60步)才能达到最优性能,导致计算成本高昂。虽然可以通过改进的采样器(如PC Sampler)减少步数,但其效率通常仍低于流模型。
我们可以做一个形象的比喻,扩散模型像一个技艺精湛的雕刻家,通过多次、细致地凿除冗余的石料(噪声),最终显露雕像(纯净语音)的全貌,过程精细但耗时。而流模型更像一个拥有精确蓝图的导航系统,它规划了一条从原料到成品的最短、最直接的平滑路径,从而实现了一次高效、快速的“塑造”。
代表性工作二:FlowSE: Efficient and High-Quality Speech Enhancement via Flow Matching(INTERSPEECH 2025)
方法概述
本论文提出的FlowSE同样基于流匹配框架,但在具体实现上与前一篇有根本区别。首先,它放弃了复数STFT域,转而采用梅尔频谱图(Mel Spectrum)作为输入和输出的表征。其次,本文引入了隐扩散变换器(latent Diffusion Transformer)作为学习向量场的主干网络,以替代之前工作中使用的U-Net类架构(NCSN++),旨在更好地捕捉语音在时频域上的长程依赖关系。
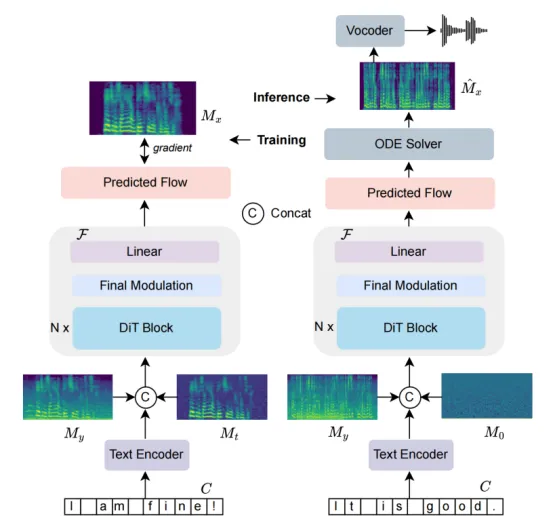
此外,本工作的一大亮点是开创性地引入了可选的文本条件(Text condition)输入:通过一个文本编码器处理语音转录本,并将文本特征与音频特征融合,从而利用高级语义信息来指导增强过程。为了确保模型在无文本输入时也能工作,训练中会随机丢弃文本条件。这种设计使得本FlowSE成为一个更通用、更强大的框架,不仅在效率上继承了流匹配的优势,更在增强质量上寻求突破。
主要实验结论
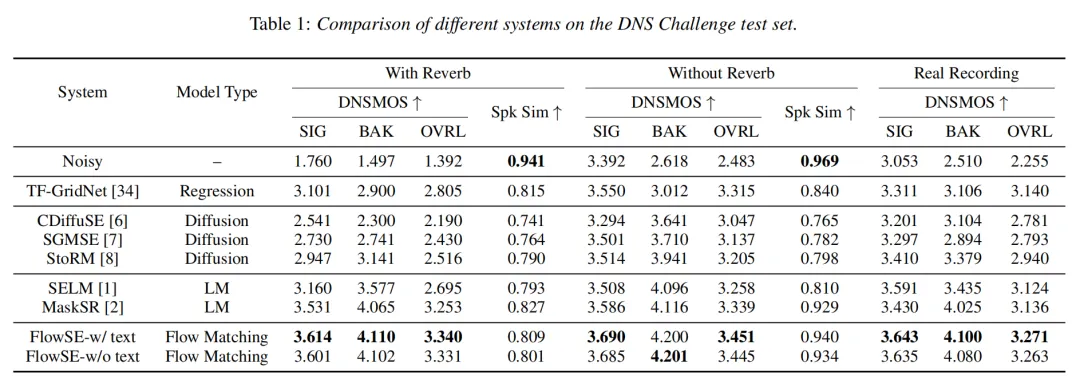
在DNS Challenge-interspeech 2021测试集上,该FlowSE在感知质量(DNSMOS)、背景噪声抑制和整体音质上均显著超越了所有基线模型,包括先进的回归模型、扩散模型和基于语言模型(Language model)的方法。
该模型在“说话人相似度”指标上取得了最高分,证明其能最有效地保留原说话人的音色特征,克服了许多生成式模型(尤其是扩散模型)在此方面的短板。
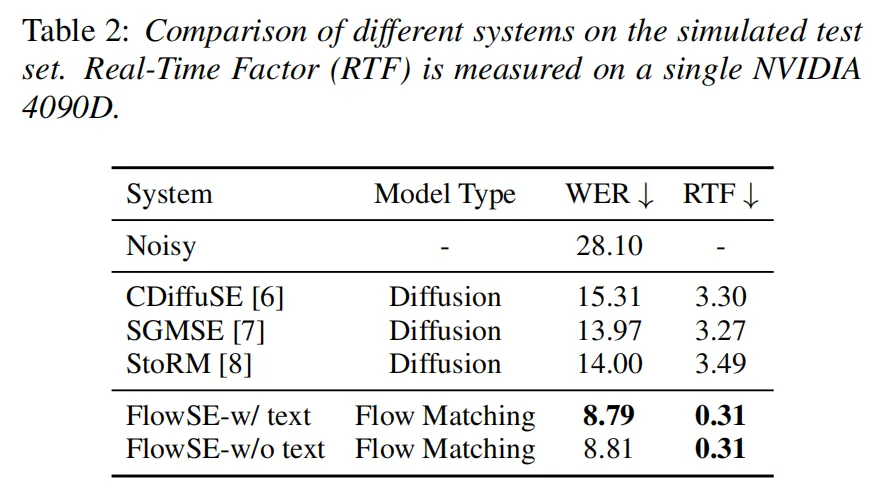
模型实现了0.31的实时因子(RTF),比扩散模型快了超过10倍。同时,它将词错误率(WER)从几个基线模型的14%左右大幅降至约8.8%,证明了其输出语音在保持自然的同时具有极高的可懂度。
四、基于平均速度流(Mean Flow)的语音增强
实验室近期工作:MeanSE: Efficient Generative Speech Enhancement with Mean Flows(submitted to ICASSP 2026)
方法概述
MeanSE 并非使用传统的流匹配方法,而是采用了更先进的均值流框架。其根本区别在于模型学习的目标:传统流模型学习的是“瞬时速度场”(Instantaneous velocity field),即在流程中每一个无限小的时间点上,数据点应该向哪个方向移动;而MeanSE学习的是“平均速度场”(Average velocity field),即在一个有限的时间区间内,状态从起点到终点所需的平均移动速度。
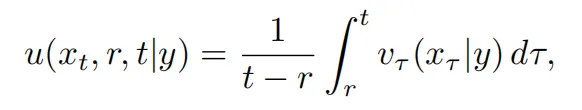
这一改变允许模型在推理时,仅用1步(1-NFE)就直接预测出从噪声起点到纯净终点的整体变换。具体实现上,模型网络需要同时输入起始时间r和终止时间t来表征一个时间区间[r, t]。为了稳定训练如此宏观的目标,论文采用了流场混合(Flow field mixup)策略,让模型同时学习瞬时速度场和平均速度场、和时间区间课程学习(Curriculum learning)方法,让模型从学习小区间的平均速度开始,逐步过渡到学习整个流程的大区间的平均速度。
主要实验结论
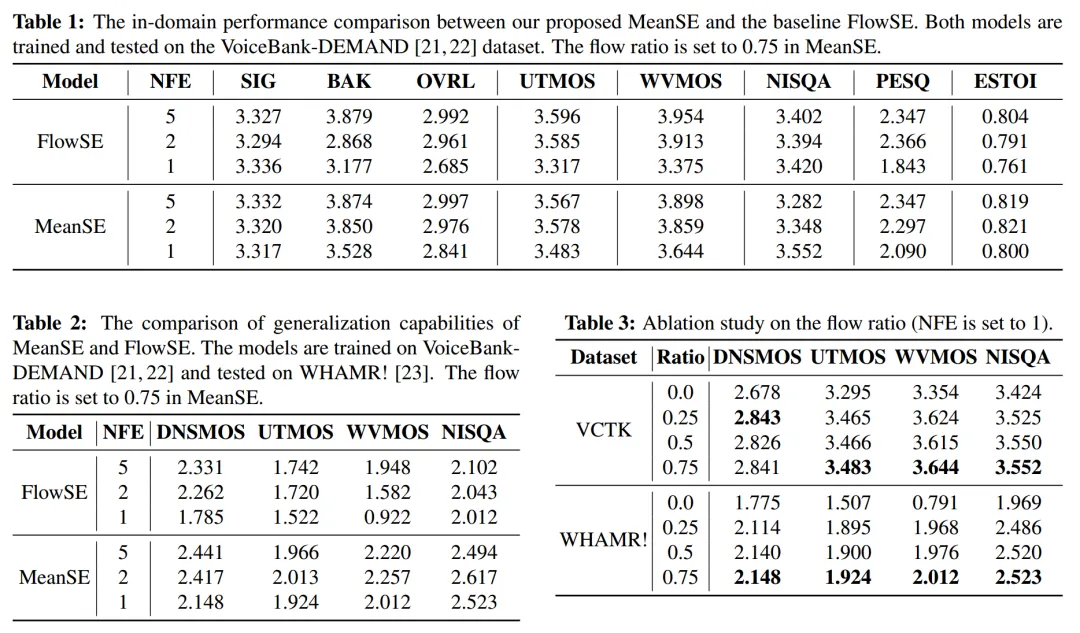
在VoiceBank-DEMAND数据集的集内测试上,MeanSE 在一步反向迭代(1-NFE)的设置下,其性能显著优于流匹配基线模型(FlowSE)。尽管在多个NFE下两者性能相当,但MeanSE在单步推理上的巨大优势使其在需要极低延迟的实时场景中具有不可替代的价值。
在跨领域测试(在VoiceBank-DEMAND数据集上训练,在WHAMR!数据集上测试)中,MeanSE 的优势更为明显。特别是在1-NFE的设置下,基线模型FlowSE在个别指标中几乎失效,而MeanSE依然能生成有效的增强语音,在所有非侵入式指标上均展现出大幅度的性能领先。这证明了均值流模型学习到的平均速度场具有更优的鲁棒性和泛化性。
消融实验表明,流场混合策略(Flow field mixed)对训练的稳定性和最终性能至关重要。完全不加该策略会导致训练失败,而将其设置为0.75时能取得最佳效果。
总结
近年来,生成式语音增模型强异军突起,正成为解决语音“保真度”与“泛化性”难题的新范式。与直接学习“从带噪语音到纯净语音”映射的判别式模型不同,生成式模型学习的是纯净语音本身的分布。这使得它们不仅能输出更自然、细节更丰富的语音,还对训练时未见的噪声类型展现出惊人的鲁棒性。然而,早期的扩散模型虽效果出色,但迭代采样导致计算开销巨大。Flow模型通过常微分方程(ODE)路径,将采样步数从几十步大幅缩减至几步。MeanSE进一步通过建模“平均速度场”,实现了高质量的单步增强。总之,基于流模型的系列工作凭借其高效、高质和高泛化能力的独特优势,正在推动生成式语音增强走向实用,为生成式模型用于实时通信、音频修复等场景带来了新的可能性。
