
 语音小管家
官方 Blog: https://developers.google.com/health-ai-developer-foundations/medasr
huggingface: https://huggingface.co/google/medasr
MedASR 为何物?
MedASR 是基于 Conformer 架构预训练的语音识别模型,旨在为开发者提供一个起点,并适用于医学领域的语音转文本任务,如放射学转录和医生-患者对话的转录。
MedASR 模型是专门针对多样化的医学语音数据进行训练的。其训练使用了大约5000 小时的医生语音记录,涵盖了各种专业领域( proprietary dataset 1)和非识别的医学对话,主要是医生-患者对话(proprietary dataset 2)。模型在音频片段与对应的转录和元数据上进行训练, conversational data 的子集也包括了广泛的医学命名实体注释,如症状、药物和条件。因此,MedASR 对医学上下文中的词汇有很强的理解能力。
MedASR 模型是推荐用于涉及专业医学术语和转录医生-患者对话的语音转文本任务。对于需要分析转录文本的语义内容(如摘要或问答)的应用程序,MedASR 的输出可以作为生成模型(如 MedGemma)的输入。
以上是来自 MedASR 的官方(https://developers.google.com/health-ai-developer-foundations/medasr)介绍,那么其疗效如何呢?我们同样以官方给出的结果为例。
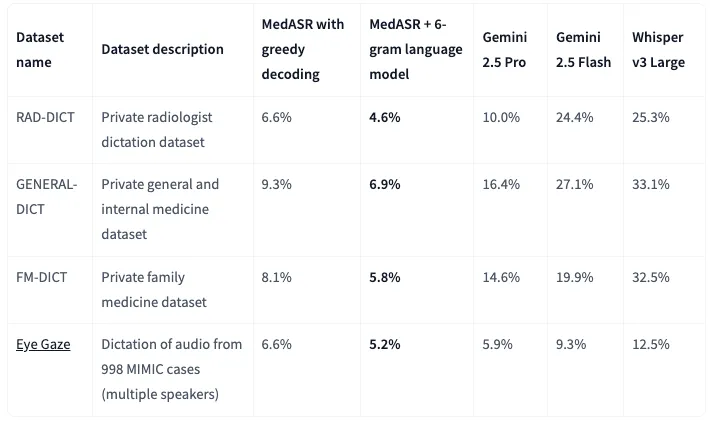
可以看到,MedASR 在医疗领域表现十分出色,大幅领先同门的通用 Gemini,断崖式领先行业的 Whisper 模型。并且我们看到,即使在有海量数据的 Google,语音识别中的语言模型依旧在发光发热,大幅度提升了医学领域的语音识别效果。
这里,我们汇总几个要点:
模型架构:模型架构为 Conformer-CTC(是的,你没看错,还是旧的配方,还是 Conformer,还是 CTC)。 模型大小:105M,算是很小了,并可以外挂 700M 的语言模型。 数据:官方简介中使用了 5000 小时的医学数据,这块应该是在通用识别的海量数据基础上,新增了 5000 小时医学数据。 与 Gemini 的对比:这块事实上是存疑的,不清楚有没有部门墙和数据墙,是否 Gemini 中也同样包含了 5000 小时医学数据。不过,撇开这点不谈,能以一个 100M 的规模,能把自家几百 B 的 Gemini 2.5 Pro 按在地上狠狠摩擦,已经证明了其价值。
通用与专用,如何破局?
看到这个工作,对我们有何启发?我们第一想到的是通用和专用。
大模型开创了通用模型的先河,在大模型诞生之初,我们普遍强调大模型的能力不在于他在特定单一任务上的表现,而在于他能够适应各种任务的能力。所以自大模型诞生以来,通用模型一直是行业探索的主流。 然而,随着越来越多的公司参与到大模型的军备竞赛中来,事实上同质化非常严重。
那么如何破局,特别是对于进入到这个领域的新公司,如何打造自己独有的卖点? 或许专用就是答案。当然这个专用不是仅作用在一个领域,而是模型能力成 T 型,在保留一定通用能力的基础上, 在某个特定领域能远比其他模型表现更好,从而构建差异化的竞争优势,打造自己独有的卖点。
事实上,我们已经看到了这样的趋势,对目前的部分模型也有了特殊的记忆点,例如 Claude 在代码方面能力突出,Nano Banana 在图片生成方面能力突出, 智谱的 AutoGLM 在 GUI Agent 方面也积累了一些声量。
未来,通用和专用或是并驾齐驱的发展,大模型如是,视觉如是,语音亦如是,通用万岁万岁万万岁,而专用模型的春天也已来!
