
 语音小管家
标题:Adapting Speech Language Model to Singing Voice Synthesis
链接:https://arxiv.org/pdf/2512.14657
作者单位:卡内基梅隆大学、中国人民大学、约翰霍普金斯大学
发表日期:2025年12月16日
说明:Accepted by NeurIPS 2025 workshop AI for Music.
01、摘要:核心是“改造SLM做SVS”
把音乐得分(比如音高、歌词音素、时长)和歌声波形都转成token; 让模型做“多流token预测”(就是同时预测不同类型的token); 用“条件流匹配”的方法生成mel谱(声音的一种特征); 最后用声码器把mel谱转成实际的歌声波形。
结果也不错:改完的SLM做SVS的效果,能跟现在主流的、专门做SVS的“离散token模型”比一比。他们还放了项目页,能听样例、看代码:https://tsukasane.github.io/SLMSVS/
02、引言:为啥要做这件事?
用“条件流匹配模型”把高斯噪声转成mel谱,还把音高信息加进去,让歌声更准; 专门训了个声码器,跟codec的参数对齐,解决声音质量问题。
03、方法:具体怎么改SLM做SVS?
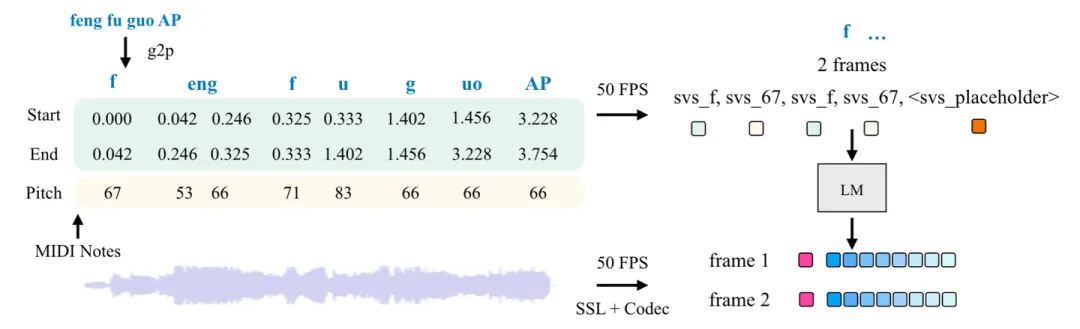
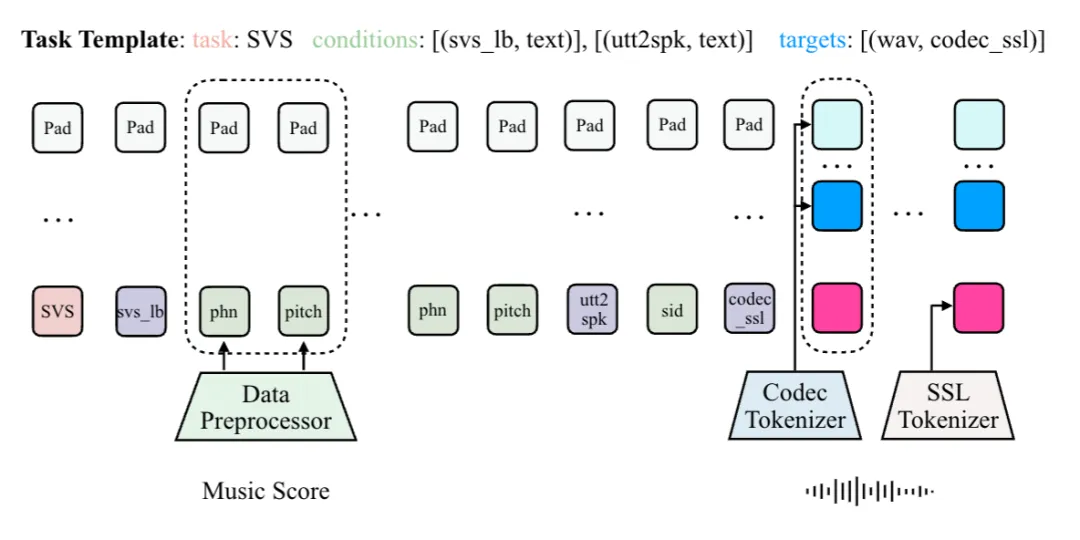
对于音乐得分里的“音素、音高、时长”:先把它们量化成“50FPS的离散token”(50FPS就是每秒50个帧,保证时间对齐),然后加到原来TTS模型的词汇表里; 对于歌声波形:用两个预训练模型提token——一个是codec编码器(提“低层声学token”,管声音的细节),一个是SSL模型(提“高层语义token”,管歌词对应的语音特征),每帧的token是“1个SSL token + 8个codec token”拼起来的。
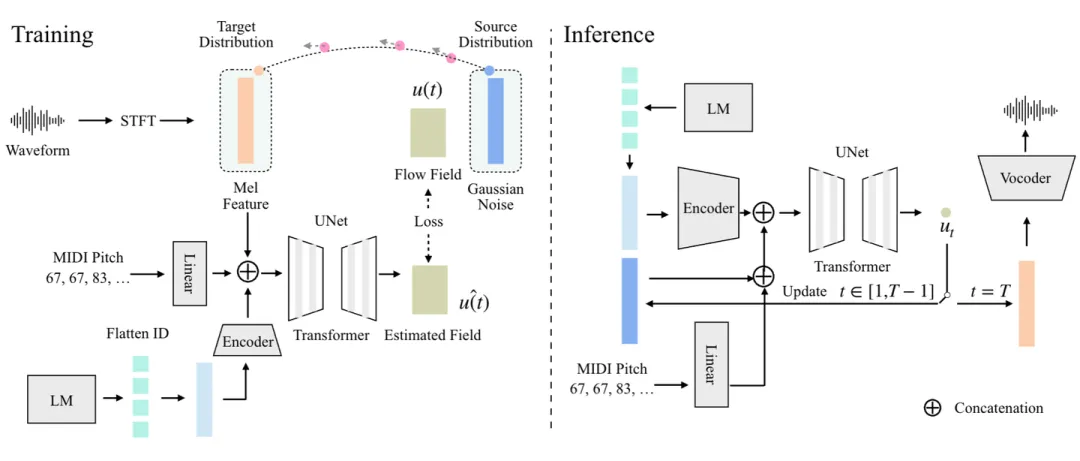
起点(源分布):X₀,是标准高斯噪声(简单说就是随机噪声); 终点(目标分布):X₁,是真实歌声经过STFT(一种信号处理方法)得到的mel谱; 路径:用“线性插值”——比如时间t=0时是纯噪声,t=1时是纯mel谱,中间t时刻的状态是“(1-t)×噪声 + t×mel谱”,这样走的路径是“动能最小”的,模型好学好优化; 条件:为了让生成的mel谱符合SVS需求,他们把“模型预测的codec token”和“音乐得分里的音高信号”都作为“条件”喂给流模型,保证生成的声音既贴合预测的token,又不跑调;; 训练损失:让模型预测的“速度”和“真实速度”尽可能像——真实速度是“从噪声到mel谱的实际变化速度”,模型预测的速度要跟它接近,用平方误差算损失。
04、实验:效果到底怎么样?
数据集:用的是ACE-Opencpop,135小时的合成歌声数据集,是目前最大的开源SVS数据集。它是在一个5.2小时的中文女声数据集(Opencpop)基础上做的,加了30个歌手的声音(用ACE Studio生成,还手动调过),所以数据量够大,也够多样。 模型参数: SLM微调:用DeepSpeed混合精度(FP16)训练,Adam优化器(β₁=0.9,β₂=0.95),学习率5e-6,还开了ZeRO stage2省内存;学习率用“ Warmup-Cosine”调度(先涨后降,总步数7e5,最低LR是初始的30%),梯度裁剪设1.0,防止训练崩。 流匹配训练:训30轮,batch size=64;学习率从3e-4线性降到1e-4(从2e5步降到5e5步)。
F0_RMSE:基频(音高)的均方根误差,越低越好(说明音高越准,不跑调); F0_CORR:基频的相关性,越高越好(说明生成的音高和参考的音高越像); MCD:mel倒谱距离,越低越好(说明生成的声音频谱和参考的越像,音质越好); PER:音素错误率,越低越好(说明歌词对应的语音越准,没唱错字); SingMOS:歌声的MOS分(1-5分),越高越好(主观听感越好); Sheet-SSQA:歌声和乐谱的匹配度,越高越好(说明歌声符合音乐得分)。
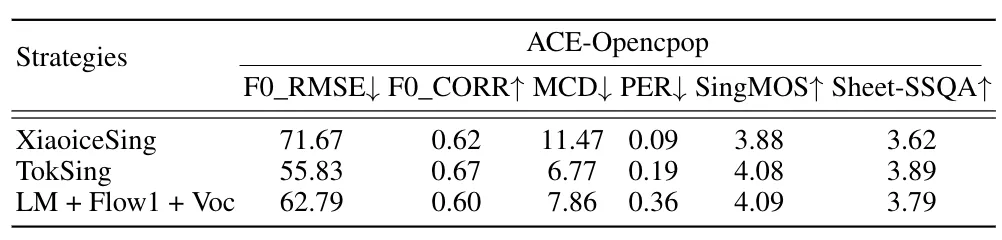
音高准度:本文模型比XiaoiceSing好,但比TokSing差一点(毕竟TokSing专门加了旋律优化); 音质和听感:本文模型的SingMOS(4.09)比两个对比模型都高,MCD也比XiaoiceSing好很多,说明听感更自然; 乐谱匹配:跟TokSing差不多,比XiaoiceSing好。
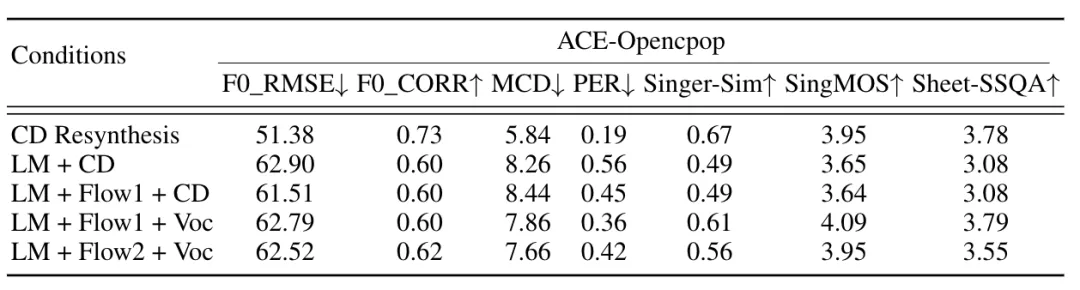
直接用codec编解码(CD Resynthesis)的“客观指标”(F0_RMSE、MCD)很好,但“主观听感”(SingMOS)一般——因为codec是用语音训的,还原歌声不够自然; 只做SLM微调+codec解码(LM+CD)效果最差——证明之前说的“token有噪声、codec不适配歌声”是真的; 加了流匹配+专门声码器(LM+Flow1+Voc)后,主观听感(SingMOS)和乐谱匹配(Sheet-SSQA)直接冲到最好——说明流匹配和专用声码器是关键,解决了音质问题; 流匹配里加音高条件(LM+Flow2+Voc)后,F0RMSE、F0CORR、MCD这些客观指标略好——证明把音高信息加进去,能让音高更准。
05、结论:总结一下
验证了SLM的泛化性——不用专门训SVS模型,改改预训练的TTS-SLM就行,小数据也能适配; 设计了SVS专用的token化方案——把音乐得分(音素、音高、时长)转成帧级token,还和音频的codec/SSL token结合,让模型能同时学语音和音乐特征; 用“条件流匹配+专用声码器”解决了音质问题——既补了codec的短板,又让音高更准,还提升了听感。
