
 语音小管家
心理学研究证明,人的情绪是一个随时间连续演化的动态过程:会上扬、会回落、可以在几秒内完成从一种情绪到另一种情绪的过渡。然而当下的情感语音合成(TTS)系统,大多只能给一整句话贴上一个离散标签或一个静态情绪向量,与情绪的时间本质错位。本文提出 EmoTra-TTS,对“句内情绪平滑过渡”进行显式、可控的建模:仅新增 +0.43% 参数、几乎零延迟开销,在情绪过渡质量上取得 30%–87% 的相对提升,并在与 4 个开源 SOTA、2 个商业系统的成对偏好测试中取得 64.4%–79.5% 的整体胜率。
论文标题:EmoTra-TTS: Smooth Intra-Utterance Emotion Transitions for Speech Synthesis
接收会议:EMNLP 2026 (main conference)
论文:https://arxiv.org/pdf/2608.23791
Demo 展示页:https://liu-tianchi.github.io/EmoTra_DemoPage/
开源代码:https://github.com/Liu-Tianchi/EmoTra-TTS
▎ 01 研究背景:情绪不是标签,而是过程
在讲故事、有声书、影视配音等表现力场景中,情绪的“起—转—落”是自然表达的核心。心理学的情绪动态(emotion dynamics)研究表明,情感状态随时间连续波动,具有惯性、渐变衰减与类别间的平滑过渡;Russell 环状模型与 PAD 框架用连续的 VAD(效价 Valence–唤醒 Arousal–支配 Dominance)空间刻画这一连续性。
然而,主流情感 TTS 仍沿用“一句话一个情绪标签”的范式。近期已有更细粒度的探索(EmoSphere-TTS 的球面 VAD、EmoKnob 的解耦风格旋钮、WeSCon 的词级离散控制),但均未建模情绪在句内随时间连续变化的“上扬—过渡—回落”。基于 LLM 的 TTS 虽可借助文本理解隐式改变韵律,却既无法由用户精确控制,也不足以完成句内定向的情绪过渡。
▎ 02 三大核心挑战
数据稀缺:句内情绪过渡在情感语音语料中极其稀少;要求演员精确控制过渡的起始时刻、方向与强度,同时保持自然韵律与清晰内容,是非常困难且昂贵的,难以支撑规模化的模型训练需要。
双层级条件控制:现代 LLM-based TTS 将合成拆为“韵律规划(LLM)”与“声学实现(Flow 解码器)”两级,两级都需要时间对齐的情绪信号。
幅度控制:向冻结的预训练解码器注入条件,易将其推出正常工作区间;而可学习的“软约束”会被网络协同自适应地绕开,导致内容退化。
▎ 03 方法:EmoTra-TTS 三大组件
针对上述挑战,EmoTra-TTS 由三个关键设计构成:合成情绪过渡数据 + 双阶段 VAD 条件 + 方向-幅度解耦注入。
3.1 多遍 Flow 融合:合成情绪过渡数据
核心洞察在于:Flow 解码器对说话人/情绪嵌入的条件独立于语言内容。即同一段语音 token 序列在不同情绪条件下解码,可得到时间对齐、情绪不同的梅尔谱。凭借这一“内容不变”特性,即可在梅尔谱空间平滑融合而不引入时间错位。
对给定文本与“初始→结果”情绪对,流程如下:① LLM 生成一条共享语音 token 序列,保证帧级对齐;② 三遍独立 Flow 解码,分别得到初始、过渡桥接、结果三段梅尔谱;③ 用 Sigmoid 交叉淡化在中段平滑过渡、两端近乎二值地保留纯情绪区;④ 用 Whisper ASR 质检内容完整性,超过词错阈值的样本予以丢弃。该流水线可任意组合情绪对、精确控制过渡的时机,并支持多 GPU 并行,每小时可生成数千条样本。
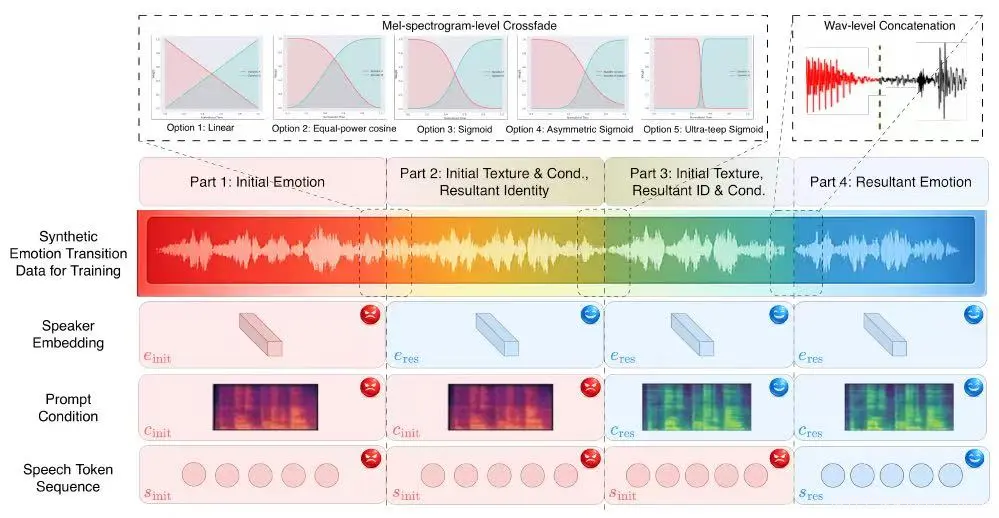
图 1 合成情绪过渡数据生成流程:part 1-3共享 token + 多遍 Flow 解码 + Sigmoid 交叉淡化。Part 4 为纯净的结尾情绪。
3.2 双阶段 VAD 条件注入训练:LLM + Flow
LLM 阶段:投影网络将 3 维 VAD 向量映射到 LLM 嵌入空间。为在离散 token 序列中编码连续的 VAD 过渡,在初始与结果端点之间均匀采样 Ntra 个中间点,连同两个端点 token 一并前置于文本 token 之前;同时引入辅助的隐状态重建损失,为 VAD 嵌入提供“感知锚定”,避免其落入数值可分却声学无意义的区域。
Flow 阶段:情绪经由说话人通道注入。原因有二:其一,说话人身份与情绪都只改变“声音怎么听”、不改变“说了什么”,与内容属同一类条件;其二,加性注入无需改动预训练解码器结构。帧级 VAD 由分段线性插值构造(前段恒定、中段线性过渡、后段恒定),与合成训练数据的时间结构相似。
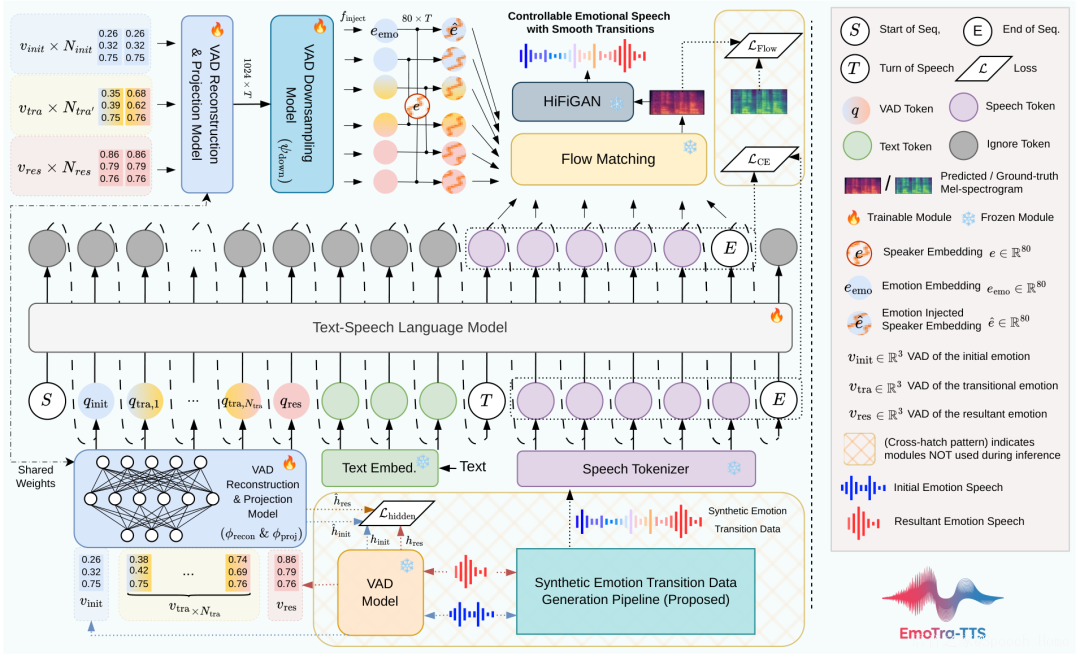
图 2 EmoTra-TTS 总体架构。下部:带时序 VAD token 的 LLM 阶段;上部:通过方向-幅度解耦注入实现帧级情绪调制的 Flow 阶段。
3.3 方向-幅度解耦注入
注入向量纠缠了两个语义不同的因子:方向(是哪种情绪)与幅度(注入多强)。作者发现,无约束训练会使 MLP 输出范数超过说话人嵌入范数,导致内容崩坏;而 FiLM 一类的“可学习软约束”又会被 MLP 协同绕开。
我们提出的解法是以结构性硬约束实现解耦:f_inject(x) = ε · LayerNorm(x)。LayerNorm 将输出范数重新归一化,锁定幅度,使 MLP 只能自由学习情绪方向、无法放大幅度;使用 ε 独立控制注入强度。最终部署的 ε=0.07,使注入的有效范数与说话人嵌入范数(≈0.622)持平,落在“安全工作区”内。
▎ 04 实验结果
在前后的多次评测中,合计采用了 21 人的盲听团队,并将 MOS 拆解为三项独立指标:MOS-Qua(自然度/音质)、MOS-Emo(情绪表达充分度)、MOS-Tra(句内情绪过渡平滑度);另报告说话人相似度 SIM、WER,以及成对偏好胜率与 95% 置信区间。
4.1 与开源系统的整体对比(节选)
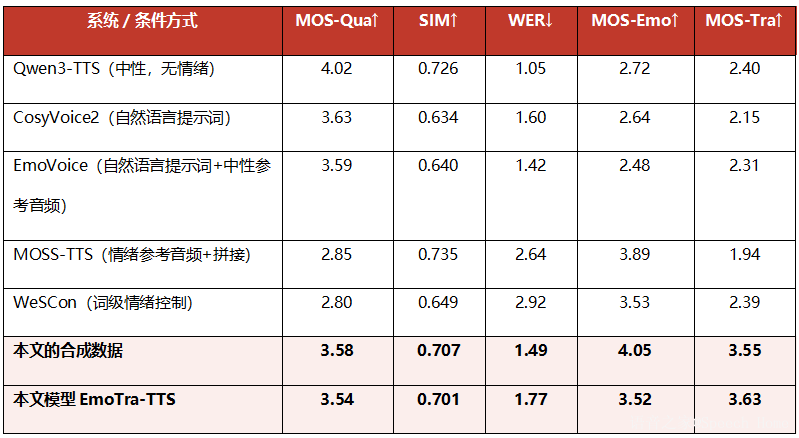
表 1 与开源系统对比(节选自论文 Table 2;主观指标为均值)。EmoTra-TTS 在过渡平滑度 MOS-Tra 上取得最优 3.63。
关键结论,在情绪过渡场景下:
- 中性基线音质最高,但几乎没有情绪与过渡。
- 指令类系统难以把自然语言提示词转变为精确的句内控制与过渡。
- 拼接类(如 MOSS-TTS)情绪最强(MOS-Emo 3.89)却过渡最差(MOS-Tra 1.94):情绪越强,在拼接方式下,边界断裂越明显,“失败代价”随表现力上升而放大。
- 所有基线 MOS-Tra ≤ 2.80,说明可控的平滑过渡仍是开放问题。
- EmoTra-TTS 单遍解码 + 帧级 VAD 连续插值,取得最优过渡平滑度 MOS-Tra 3.63,其余指标同样具备竞争力。
现有系统(无论开源还是商业)在整体合成质量上都已相当出色:在主观音质(MOS-Qua)、说话人相似度(SIM)与 WER 上普遍表现优异:例如中性条件下 Qwen3-TTS 的 MOS-Qua 高达 4.02、MOSS-TTS 的 SIM 达 0.754、多数系统 WER 低至约 1%。它们代表了当前 TTS 的高水准。EmoTra-TTS 的价值不在于在通用音质上取代这些强系统,而在于补齐一项它们尚未专门支持的能力:句内情绪过渡的显式、可控建模。这一方向训练数据极其稀缺、此前少有系统专门优化,正是本文聚焦并主要贡献之处。
4.2 成对偏好
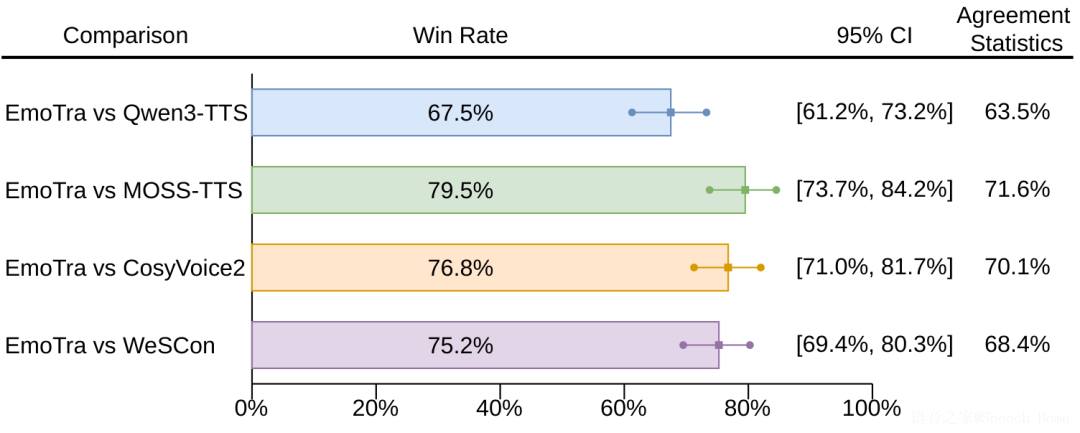
图 3 EmoTra-TTS 对 4 个开源基线的成对偏好胜率(67.5%–79.5%),每个 95% CI 下界均高于 60%。
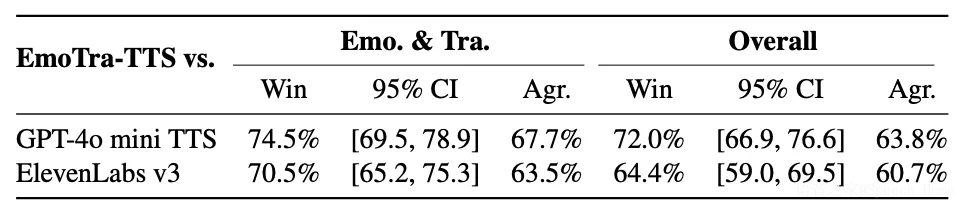
表2 EmoTra-TTS 对 2个商用TTS系统的成对偏好胜率,每个 95% CI 下界均高于 59%。
GPT-4o mini TTS 与 ElevenLabs v3 都是成熟且高质量的商业TTS系统,其通用合成质量与自然度均非常优秀。差异主要出现在它们尚未专门支持的句内情绪过渡上:在情绪过渡的测试场景下,EmoTra-TTS 的整体偏好胜率为 72.0%(vs GPT-4o mini TTS)与 64.4%(vs ElevenLabs v3);在“情绪与过渡自然度”维度上优势更大(74.5% 与 70.5%),且每个 95% CI 下界均高于 50% 随机水平。
注:该商业系统对比是在论文 rebuttal 期间补充完成的,采用了与前述开源成对测试部分重叠但并不完全相同的评测人员与样本对;因此,它构成一次有效的“EmoTra-TTS 与 商业系统”的比较,但不可与 图 3中的开源成对结果直接横向比较。
4.4 推理效率:几乎零开销
EmoTra-TTS 仅新增 0.43% 参数(642M vs 639M),延迟与基座 CosyVoice2 基本持平(1.74s vs 1.75s),显存占用几乎不变(3.05GB vs 3.04GB)。相比之下,多遍 Flow 融合的合成数据流水线需 4× Flow 推理,仅用于离线数据生成。
▎ 05 Demo 对比试听
下表按“情绪过渡场景”组织,横向对比不同系统的合成效果。更多样例见 Demo 页面:https://liu-tianchi.github.io/EmoTra_DemoPage/
▎ 06 总结
情绪动态研究已确立“情感随时间连续演化”,但句内情绪时间轨迹的显式、可控建模此前仅被部分解决。EmoTra-TTS 以三项设计回应这一问题:多遍 Flow 融合合成过渡数据、双阶段 VAD 条件实现韵律与声学的互补控制、方向-幅度解耦注入约束注入幅度以缓解“内容—表现力”权衡。在仅 +0.43% 参数、零延迟开销的前提下,它取得了所有被评系统中最优的情绪过渡平滑度,相对多个 SOTA 与商业系统提升 30%–87%,成对偏好胜率达 64.4%–79.5%。在这项工作中,我们把情绪视为“时间过程”而非静态属性来建模,希望能为富表现力语音合成提供一个有价值的新视角。
