
 语音小管家
以下文章来源:努力犯错玩AI
近日,独立开发者 Owen Song 发布了 Inflect v2。这是一个极致轻量的英文语音合成模型。Micro 版只有 9.36M 参数,FP32 权重只有 37.5MB。Nano 版更是只有 3.97M 参数和 16MB。到 7 月 25 日,Inflect-Nano-v2 已登上 HuggingFace TTS 排行榜第一。
地址:https://huggingface.co/owensong/Inflect-Micro-v2
Inflect v2 项目封面:轻量级、高质量、本地的英文 TTS 系统。
说到语音合成,很多人第一反应是云端的商用 API,或者需要高端显卡才能跑的模型。但很多场景其实只需要一个轻量的本地方案:内容创作时的配音辅助、阅读辅助工具、边缘设备上的语音反馈。这些场景不需要克隆别人的声音,不需要多说话人切换,只需要一段自然流畅的语音。Inflect v2 就是为这类需求设计的。
Micro 版在 4 核 CPU 上每秒能处理 6.28 秒的音频输出。读一篇六百字的文章并生成语音,消耗的时间远少于朗读所需的时间。Nano 版更快,每秒能处理 10.72 秒。两个版本都只需要几十兆字节的磁盘空间。
在人类盲听评测中,Micro 版获得了 66.2% 的偏好率——21 次胜出、10 次失败、3 次平局。预测自然度得分 4.395,双语音识别系统的语义词错误率仅 3.99%。这些数字放在任何规模的 TTS 模型中都很有竞争力。
Owen Song 是独立开发者,所有工作由他一人完成。从模型架构设计、数据处理、训练到评估和文档,没有团队支持,全部个人出资。训练和评估总支出超过 500 美元。项目以 Apache 2.0 许可开源。
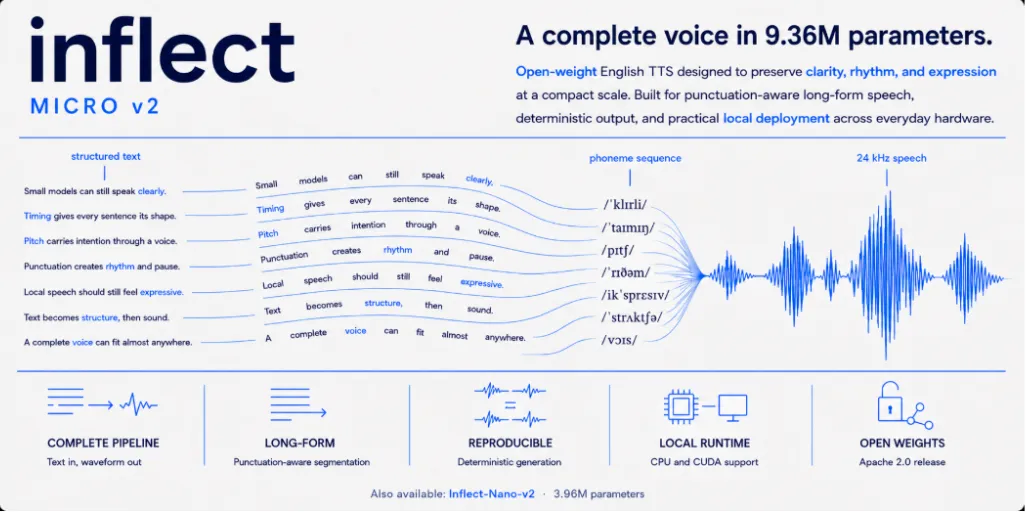
两个型号
Inflect v2 提供两个规格。Micro 侧重质量,Nano 侧重体积。推理参数完全公开透明,精确到每个参数的数值。
Micro 版有 9,356,513 个推理参数,FP32 权重 37.53MB,4 核 CPU 上每秒处理音频是消耗时间的 6.28 倍。Nano 版有 3,966,721 个推理参数,FP32 权重 15.97MB,10.72 倍实时。两个型号共享同一套 Python API 和命令行工具,所有代码在同一个仓库,切换只需要改一个参数。都输出 24kHz 单声道波形,同一个固定英文男声。
参数计数覆盖了文本编码、时长预测、潜语音生成和波形解码器的全部参数,只有训练时用的判别器不计入。这意味着用户下载的模型文件就是完整的推理包,不需要额外加载其他组件。
人声盲听结果
评测由三个维度构成,每个维度解决一个特定的评估需求。
第一是社区盲听偏好。在 Modern400 测试集上使用双盲 A/B 比较,参评者不知道样本来自哪个系统。Micro 版 66.2% 偏好率,21 次胜出、10 次失败、3 次平局。这是最直接的评估方式,反映了真实听众的主观感受。同类系统在这个测试中的偏好率通常在 40% 到 55% 之间。
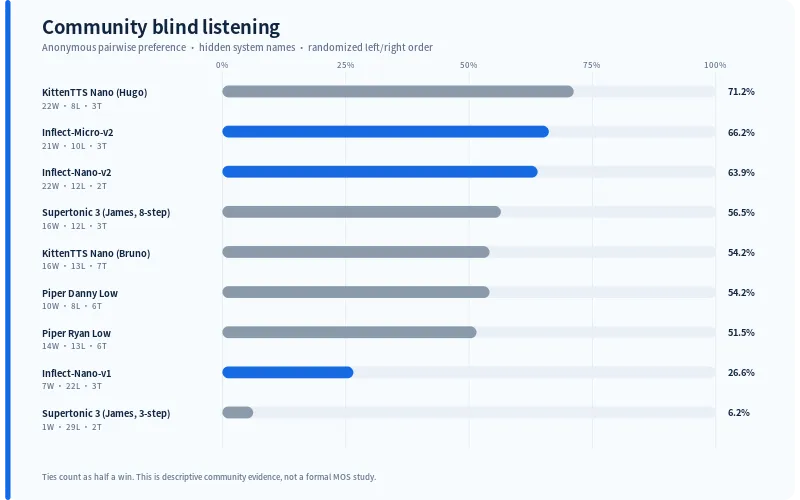
人类盲听评测结果:Inflect-Micro-v2 以 66.2% 的偏好率胜出,21 胜 10 负 3 平。
第二是 UTMOS22 自然度评分 4.395,置信区间 4.381 到 4.408。UTMOS 是广泛使用的无参考语音自然度评估器,由日本国立情报学研究所开发,评分范围 1 到 5。4.4 分已经属于高质量水平,接近真人录音的自然度。作为参考,许多商用 TTS 系统在 4.0 到 4.3 之间。
第三是语义词错误率。用两个不同的语音识别系统分别对生成语音做识别,把识别结果与原始文本比较,计算错误率。Qwen3-ASR 上 Micro 版错误率 2.52%,Nemotron 3.5-ASR 上 5.45%,Whisper large-v3 上 2.73%。双系统平均约 3.99%。
对比同类系统:KittenTTS Nano 在 Qwen3-ASR 上错误率 2.15%,Piper Low 是 2.62%,Supertonic 三步版本 3.03%。Inflect-Micro-v2 的错误率跟这些系统在同一水平线上。但 KittenTTS 和 Piper 都依赖外部声码器,真实的总体参数远不止公布的数字。Inflect 把声码器集成到主模型中,这是真正的端到端一体设计。
CPU 运行速度
所有速度测试在同一个配置上完成:8 个 vCPU,32GB 内存,4 个处理线程,使用 100 条提示词评估。Inflect-Nano-v2 每秒能处理 10.72 倍的音频时长,读一段 100 字的短文生成语音只需 0.1 秒。Micro 版是 6.28 倍,也是毫秒级别。
对比同类系统:Piper Low 31.37 倍最快但自然度较低,KittenTTS Nano 13.33 倍,Supertonic 三步版 10.15 倍,八步版 4.37 倍。Inflect-Micro-v2 的 6.28 倍在质量优先的模型中属于很快的水平。Nano 版的 10.72 倍在速度和自然度之间取得了较好的平衡。
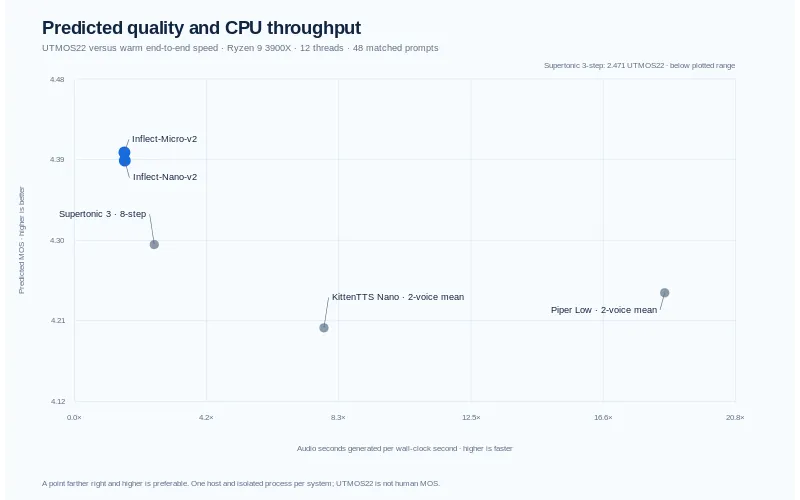
质量和 CPU 速度对比:Inflect v2 在质量和速度的平衡点上处于有利位置。
一个值得注意的细节:Inflect 使用 PyTorch 做推理,而大多数竞品使用 ONNX。ONNX 在 CPU 推理上通常有 1.5 到 2 倍的优化空间。如果未来提供了 ONNX 导出选项,速度还能进一步提升。即使当前 PyTorch 模式下,Micro 版处理 1 秒的音频只需要 160 毫秒的计算时间,足以满足绝大多数实际使用场景的需求。
架构设计
Inflect v2 属于 VITS 家族的端到端文语转换模型。VITS 这类模型的特点是从输入的文本直接生成波形,跳过传统两阶段方法中先生成频谱图再转波形的中间步骤。这样设计的好处是减少了信息损失,生成的语音更自然连贯。缺点是模型训练比较困难,对数据和计算资源要求更高。不过 Owen Song 用不到 500 美元的预算就完成了训练,说明在小规模预算下也可以做出可用的端到端模型。
推理管线按顺序经过以下步骤:英文文本先做正则化处理,把数字、缩写、符号等转换为单词形式。然后经过音素前端,把单词转成音素序列。音素序列进入 Transformer 文本编码器,提取语义特征。随机时长预测器根据语义特征预测每个音素应该持续多长时间。然后做单调对齐,把文本特征和时间轴对齐。接下来进入潜变量语音生成模块,加入残差耦合流来丰富语音的表现力。最后是内置的抗混叠神经波形解码器,直接输出 24kHz 的波形数据。
最核心的设计是波形解码器集成在模型内部。多数轻量 TTS 项目需要额外加载一个独立的声码器,比如预训练的 HiFi-GAN、BigVGAN 或者 MB-MelGAN。这些声码器本身就有不小的参数量,通常 10M 到 30M 不等。如果主模型只有 3M 参数但声码器有 20M,总参数还是 23M,下载和加载都需要两倍的时间。Inflect 把声码器压缩集成到主模型中,总参数量反而更低,用户只需要加载一个文件就能完成全部推理。
Micro 版的架构细节:隐层通道 192 个,文本编码通道 96 个,编码器 3 层每层 2 头注意力,前馈层通道 768 个,流式耦合模块 4 个,初始解码器通道 320 个,上采样率是 8 倍、8 倍、2 倍、2 倍共四级,训练段长 16384 个采样点。Nano 版在同样的结构上压缩了宽度参数,但保持了相同的部署逻辑和代码兼容性。
安装和使用
使用非常直接。从 GitHub 克隆仓库后安装依赖就能用:
git clone https://github.com/owenawsong/Inflect.git
cd Inflect
pip install -r requirements.txt
命令行直接合成语音:
python -m inflect --text "Hello, world." --output output.wav 切换到 Nano 版只需加一个参数:
python -m inflect --model nano --text "Hello, world." --output output.wav Python 调用同样简洁,支持直接从 HuggingFace Hub 加载模型:
from inflect import InflectModel
model = InflectModel.from_pretrained("owensong/Inflect-Micro-v2")
audio = model.synthesise("Hello, world.")
模型提供了几个实用控制参数。速度控制从 0.5 倍到 2.0 倍,慢速时发音更清晰,快速时语速更快。变化度从 0.0 到 1.0,默认 0.667,变化度越高每次生成的微妙差异越大,听起来更自然而不是机械重复。种子参数保证相同输入下结果可重现,方便调试和对比测试。
长文本的处理方式也很实用。系统会自动检测句号、问号、感叹号等标点边界,把长文本切成小块分别合成,再用可控的停顿拼接起来。不会因为文本太长而截断或超出显存——在 CPU 上运行也不会有内存问题。
项目还在 HuggingFace Spaces 上提供了在线 Playground,可以直接在浏览器里输入文本生成语音,支持速度、变化度和音高控制,结果可以下载 WAV 文件。
独立开发者项目
Inflect v2 最特别的地方在于它完全由一个人完成。Owen Song 不是大型 AI 公司或研究机构的成员,就是一个独立开发者。他的身份从 HuggingFace 模型卡片的描述中可以看出——没有组织后缀,没有团队署名,只有一个个人账号。模型卡片写道:"我独立构建并资助了 Inflect v2,在训练和评估上花费了超过 500 美元。"
一个人完成这样一套系统并不容易。从零开始训练一个端到端 TTS 模型,需要准备训练数据、设计模型架构、编写训练代码、调试训练过程、设计评估协议、对比竞品、分析结果、编写文档、发布模型。任何一个环节出问题都需要自己解决。五百美元的预算在深度学习项目中其实很少——租用一块 GPU 训练一周可能就要几百美元。Owen Song 能在这样的预算下做出质量可观的 TTS 模型,说明在数据效率和训练策略上做了很多优化。
项目的文档完整度也值得一提。GitHub 仓库包含完整的架构文档、部署指南、评估协议、安全策略、贡献指南和引用规范。原始评测数据、识别假设和完整性哈希都随模型发布在 HuggingFace 上。评测方法详细到可以完整复现——使用了哪些提示词、每个提示词的具体参数、ASR 系统的版本和配置都有记录。很多大公司团队的开源项目在文档完整度上都不如这个个人项目。这说明 Owen Song 不仅会做模型,也很会做项目和做社区。
HuggingFace Spaces 上的在线 Playground 也体现了这种社区意识。不需要安装任何东西,直接在浏览器里输入文本就能听到生成效果。下载 WAV 文件也不需要登录。这种低门槛的体验对推广开源模型很重要。
现有局限
Inflect v2 目前只支持英文,并且是固定的男声。不支持声音克隆,不支持多说话人,不支持流式输出。音高控制是受限制的输出控制,不是通过学习得到的说话人或情感控制。如果需要中文语音合成、声音克隆或者多说话人系统,Inflect v2 不适合。
但如果需要一个能在本地 CPU 上快速运行、不依赖 GPU 和任何外部 API 调用的英文语音合成系统,Inflect v2 是当前参数效率最高的选择之一。下载权重几十 MB,几行代码就能合成语音,没有第三方依赖,没有隐藏成本。
