
 语音小管家
在真实录音场景中,语音增强并不是简单地“把噪声去掉”。更实际的目标是:在压制背景噪声、干扰说话人和录音失真的同时,尽量保留目标说话人的音色、内容和自然度。手机通话、在线会议、智能耳机和语音交互设备中,这类需求都非常常见,也对增强模型的鲁棒性提出了更高要求。
近年来,语音增强主干网络已经取得了很大进展,但当噪声类型、录音设备和说话人条件发生变化时,模型仍然可能出现泛化不稳定的问题。除了继续堆叠更强的增强网络,一个直接而有效的思路是引入说话人级别的引导信息,让模型更明确地知道“应该保留谁的声音”。不过,这类引导式方法的关键在于条件信息是否可靠:干净注册语音在实际部署中并不总是可得,而直接从带噪语音中提取的条件嵌入又容易受到噪声和跨域条件影响。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)的论文“G-MaP-SE: Guided Speech Enhancement via GMM-Based Prior Matching”被语音研究顶级会议 Interspeech 2026 接收。该论文提出 G-MaP-SE —— 一种基于 GMM 先验匹配的引导式语音增强框架。G-MaP-SE 先离线拟合干净语音嵌入的分布,再将带噪条件嵌入匹配到这一先验空间,并通过轻量级门控融合模块将匹配后的先验嵌入注入时频域增强主干。在不依赖额外 enrollment audio 的情况下,该方法提升了引导信息的可靠性,并在域内与跨域测试中表现出更稳定的增强效果。现对该论文进行简要解读。
论文题目:G-MaP-SE: Guided Speech Enhancement via GMM-Based Prior Matching
作者列表:朱毅可,王子谦,刘子楷,李星辰,陈庄祺,夏咸军,黄传增,谢磊
论文预印版:https://arxiv.org/abs/2606.08580
开源地址:https://github.com/Hello3orld/G-MaP-SE
背景动机
语音增强的目标,是在噪声干扰情况下尽可能恢复目标语音的清晰度和可懂度[1]。近年来,随着深度学习的发展,单通道语音增强方法在时域和时频域都取得了显著进展。例如,DCCRN 对复数频谱进行建模[2],MP-SENet 显式并行估计幅度谱和相位谱[3],ZipEnhancer 进一步探索了基于 Zipformer 的高效增强结构[4]。此外,也有工作从训练目标角度提升增强质量,例如 MetricGAN [5] 和 MetricGAN+ [6] 直接优化与感知质量相关的评价指标。
不过,在真实场景中,噪声类型、说话人特征和录音设备往往与训练条件存在明显差异,模型的泛化能力仍然面临挑战。除了继续增强主干网络,一条互补路线是引入额外辅助信息来约束增强过程。其中,personalized / guided speech enhancement 利用说话人嵌入作为条件信息,使模型在竞争说话人、强背景噪声或复杂声学环境下更有针对性地保留目标说话人的语音[7,8]。
这一路线的关键瓶颈在于:条件信息本身是否可靠。很多 personalized SE 方法默认可以拿到干净的 enrollment audio,用它来提取稳定的说话人嵌入;这在实验设置里很常见,在真实部署中却并不总是成立。用户未必愿意额外录制参考音频,也未必能保证参考音频足够干净。另一种更轻量的做法是直接从带噪语音中提取条件嵌入,类似 WavLM 用于语音增强的探索也说明,预训练表征可以为增强任务提供有价值的信息[9]。但这种条件表示会同时受到噪声、混响和领域偏移影响,导致嵌入不稳定,进而影响增强性能。
因此,本文关注的不是“再造一个更大的增强网络”,而是更本质的条件建模问题:“能否把带噪条件嵌入,映射到一个更接近干净语音的先验空间里?” 如果条件本身先被拉回到合理位置,再交给增强主干处理,通常会比直接喂入带噪嵌入更稳健。
从这个角度看,G-MaP-SE 的思路很清晰。它不是假设带噪嵌入天然可用,而是承认条件信息本身会出问题,并专门设计一个先验匹配步骤去修正它。也就是说,模型优化的不只是增强输出,还包括“输入条件应该长什么样”这个问题。
本文方法
G-MaP-SE 的整体框架可以概括为三部分:先离线构建干净语音嵌入的 GMM 先验,再将带噪嵌入匹配到这一先验上,最后通过门控融合模块把匹配后的条件注入到增强主干中。
干净语音嵌入先验
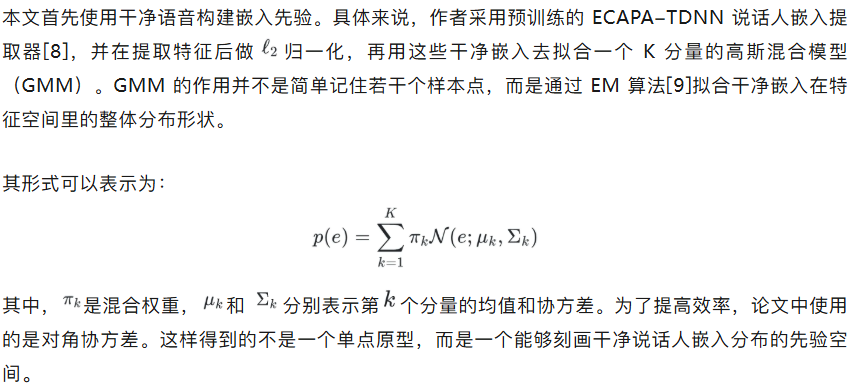
这里可以把 GMM 理解为一种“分布拟合”机制:干净嵌入并不完全相同,但它们在空间中会形成一个有结构的集合。GMM 的作用就是把这个集合的形状学出来,后续再拿带噪嵌入去对齐它。
MaP:Prior Matching
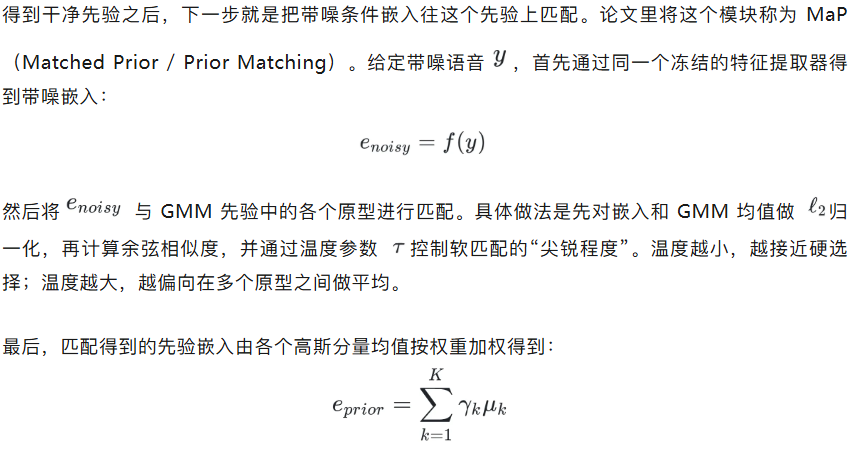
这个过程的直观含义很简单:带噪嵌入不是被直接拿来用,而是先被投影、校正,再变成一个更稳定的 prior embedding。这样做的好处是,它保留了说话人相关信息,同时尽量去除了噪声造成的偏差。
轻量级门控融合
匹配后的先验嵌入不会被直接拼接进增强网络,而是通过一个轻量级门控融合模块注入到增强主干中。论文的主干采用的是 MP-SENet,整体仍然在时频域进行增强建模。融合模块先对增强特征和条件嵌入分别做线性映射,再通过一个门控函数计算融合强度:
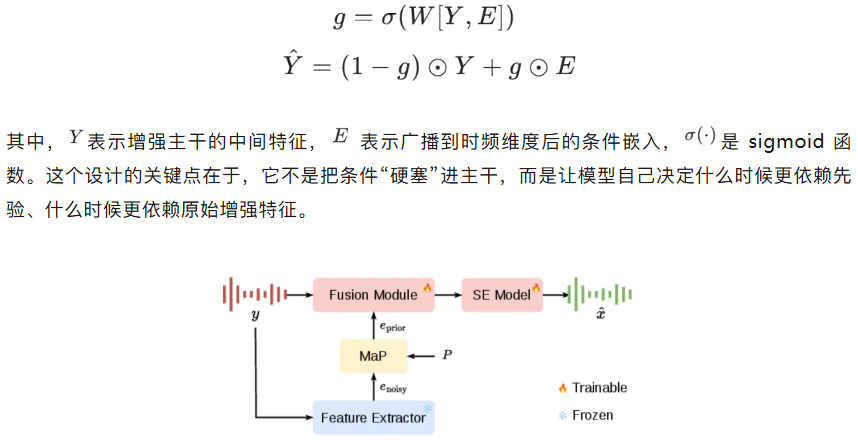
图1G-MaP-SE 的整体框架图
整体来看,G-MaP-SE 的逻辑并不复杂,但链条很完整:先用 GMM 拟合干净条件分布,再通过 MaP 把带噪嵌入匹配到这个分布,最后用门控融合把先验条件注入到增强网络。它把关注点放在“条件是否可靠”上,而不是单纯追求更深的主干结构。
实验验证
本文在两个常用数据集上验证了 G-MaP-SE 的效果:一个是 VoiceBank+DEMAND(VBD)测试集,用于做域内评估;另一个是 DNS Challenge 2020 的无混响测试集,用于观察跨域泛化能力。训练时,所有模型都在 VBD 训练集上完成,增强主干保持一致,便于公平比较。
实验设置
本文采用的增强主干是 MP-SENet [3],设置为 64 通道、4 个 TF blocks、4 个 attention heads。音频输入被随机裁剪为 2 秒片段,STFT 使用 400 点 FFT、400 点窗长和 100 点 hop,对应 16 kHz 下 25 ms 窗长和 6.25 ms 帧移。训练采用 AdamW 优化器,学习率初始化为 5e-4,并按 epoch 逐步衰减,训练步数为 500k,batch size 为 4,单卡 32GB V100 即可完成。
损失函数沿用 MP-SENet [3] 的组合形式,包含 PESQ 相关损失、STFT 一致性损失、幅度损失、复谱损失、相位损失以及时域损失。也就是说,G-MaP-SE 并没有更改主干的基本优化范式,而是主要通过条件建模来带来额外收益。
对比实验
对比实验结果比较直观。对比对象包括原始 MP-SENet、Oracle-Cond、Noisy-Cond,以及两种 G-MaP 变体。结果显示,在 VBD 上,G-MaP-SE 能够接近 oracle clean conditioning 的上界,并且明显优于直接使用 noisy conditioning 的方案;在 DNS2020 无混响测试集上,prior matching 带来的提升更稳定,且使用来自目标域的 clean prior(PDNS)还能进一步提升性能,说明这种先验可以按目标域进行替换,具有较好的 plug-and-play 特性。
表1 G-MaP-SE 在 VBD 和 DNS2020 测试集上的语音增强结果
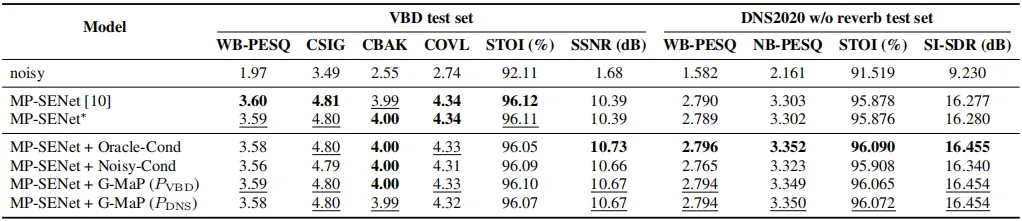
更具体地说,在 VBD 上,prior matching 后的嵌入与 clean embedding 的余弦相似度分布整体向更高区域移动,说明嵌入确实被拉近到了更干净的空间里;而在 DNS2020 上,这种匹配带来的收益更加明显,说明它在跨域条件下更能发挥作用。
嵌入分析
本文还单独分析了嵌入匹配效果。结果显示,直接使用 noisy embedding 时,它与 clean embedding 的平均 cosine similarity 为 0.805,而经过 GMM matching 后,这个值提升到了 0.838。这个结果说明,MaP 不只是形式上的一个映射模块,而是真的在把条件表示往更稳定的方向修正。
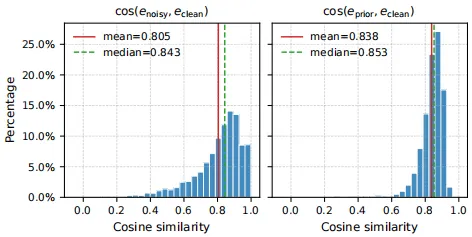
图2 Prior Matching 前后条件嵌入与干净嵌入的余弦相似度分布
少数样本在匹配后并不会显著提升,甚至可能因为被分配到不够理想的原型而恢复不完全。这说明 prior matching 虽然不能完全恢复所有样本的理想干净嵌入,但能够把条件表示拉回到更接近干净分布的区域,从而减少带噪嵌入直接参与增强带来的偏差。
消融实验
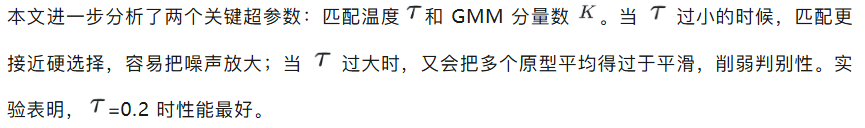
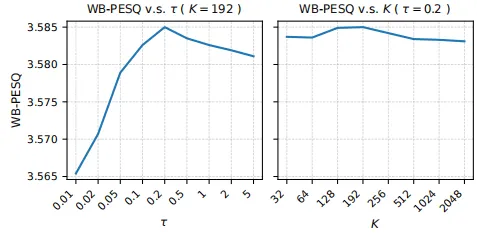
图3 匹配温度与 GMM 分量数对 G-MaP-SE 性能的影响

这组实验的价值在于,它进一步说明 G-MaP-SE 的提升并不是来自额外参数堆叠,而是来自匹配策略本身。换句话说,温度和原型数决定了 prior matching 到底是“硬对齐”、 “过度平均”,还是“恰到好处地校正”。
从整体实验来看,G-MaP-SE 的收益主要体现在两点:一是让带噪条件嵌入更接近干净条件空间,二是在不需要 enrollment audio 的前提下保持稳定的增强性能。
更多样例敬请访问: https://github.com/Hello3orld/G-MaPSE/tree/main/audio_samples
总结
总体来看,G-MaP-SE 的核心价值在于把“说话人条件是否可靠”这个问题显式建模。它没有大幅改变增强主干,也不依赖额外注册语音,而是用干净嵌入分布作为先验,将带噪条件嵌入校正到更稳定的空间中。实验结果表明,这种轻量级 prior matching 尤其有助于缓解跨域场景下 noisy conditioning 的不稳定性,也为后续构建更强、更可迁移的引导式语音增强系统提供了一个简洁有效的思路。
参考文献
[1] P. C. Loizou, Speech Enhancement: Theory and Practice. CRC Press, 2007.
[2] Y. Hu, Y. Liu, S. Lv, M. Xing, S. Zhang, Y. Fu, J. Wu, B. Zhang, and L. Xie, “DCCRN: Deep complex convolution recurrent network for phase-aware speech enhancement,” Interspeech, 2020.
[3] Y.-X. Lu, Y. Ai, and Z.-H. Ling, “Explicit estimation of magnitude and phase spectra in parallel for high-quality speech enhancement,” Neural Networks, 2025.
[4] H. Wang and B. Tian, “ZipEnhancer: Dual-path down-up sampling-based zipformer for monaural speech enhancement,” ICASSP, 2025.
[5] Y. Fu, C. Yu, T.-A. Hsieh, P. Plantinga, M. Ravanelli, X. Lu, and Y. Tsao, “MetricGAN+: An improved version of MetricGAN for speech enhancement,” Interspeech, 2021.
[6] S.-W. Fu, C.-F. Liao, Y. Tsao, and S.-D. Lin, “MetricGAN: Generative adversarial networks based black-box metric scores optimization for speech enhancement,” ICML, 2019.
[7] H. Song, S. Chen, Z. Chen, Y. Wu, T. Yoshioka, M. Tang, J. W. Shin, and S. Liu, “Exploring WavLM on Speech Enhancement,” SLT, 2023.
[8] B. Desplanques, J. Thienpondt, and K. Demuynck, “ECAPA-TDNN: Emphasized Channel Attention, Propagation and Aggregation in TDNN Based Speaker Verification,” Interspeech, 2020.
[9] A. P. Dempster, N. M. Laird, and D. B. Rubin, “Maximum likelihood from incomplete data via the EM algorithm,” Journal of the Royal Statistical Society: Series B, 1977.
