
 语音小管家
本期为大家介绍基于ICASSP 2026 URGENT 语音增强比赛的总结论文[1]。在本届 ICASSP 2026 中,我们围绕 URGENT Challenge 的组织与评测工作,完成了 challenge overview 论文。
ICASSP 2026 URGENT SPEECH ENHANCEMENT CHALLENGE
作者列表:李晨达, 王巍, Marvin Sach, 张王优, Kohei Saijo, Samuele Cornell, Yihui Fu, Zhaoheng Ni, Tim Fingscheidt, Shinji Watanabe, 钱彦旻
合作单位:上海交通大学、德国布伦瑞克工业大学、早稻田大学、卡内基梅隆大学、Meta 等
研究背景
语音增强(Speech Enhancement, SE)[2]旨在提升受噪声、混响和各类失真影响的语音质量与可懂度。近年来,神经网络驱动的 SE 方法发展迅速,但很多工作仍主要在“匹配条件”下评测,典型表现是训练与测试场景接近、失真类型有限、语种与说话风格较单一。这样的设定有助于比较算法,但也容易掩盖一个更现实的问题:模型一旦进入真实世界,面对未见过的设备、语言、口音和失真类型,性能往往明显下降。
因此,SE 领域真正的关键问题已经不只是“在某个封闭数据集上再提升一点指标”,而是如何构建通用(Universal)、鲁棒(Robust)、可泛化(Generalizable)的系统。URGENT Challenge(Universality,Robustness, andGeneralizability for speechEnhancemeNT)正是在这一目标下持续推进。相比往届,ICASSP 2026 版本进一步强化了数据管理导向、语音多样性扩展以及感知质量评估三条主线,推动社区从“单任务优化”走向“真实条件下的综合能力验证”:
1. 数据管理(Data Curation)导向:鼓励“高质量数据筛选”而非“无差别堆数据”;
2. 语音多样性扩展:覆盖更多年龄、口音、情感、耳语/歌声及多语种条件;
3. 感知质量评估:新增 Track 2,聚焦增强语音的 MOS 预测能力。
挑战任务设置
本届挑战包含两个互补赛道。Track 1 聚焦通用语音增强,要求参赛者构建单一系统,在未知输入类型的前提下处理多种失真、场景和采样率条件。系统需要面对 8–48 kHz 的输入,并覆盖加性噪声、混响、削波、带宽受限、编解码失真、丢包和风噪等七类典型失真。
赛道一:通用语音增强
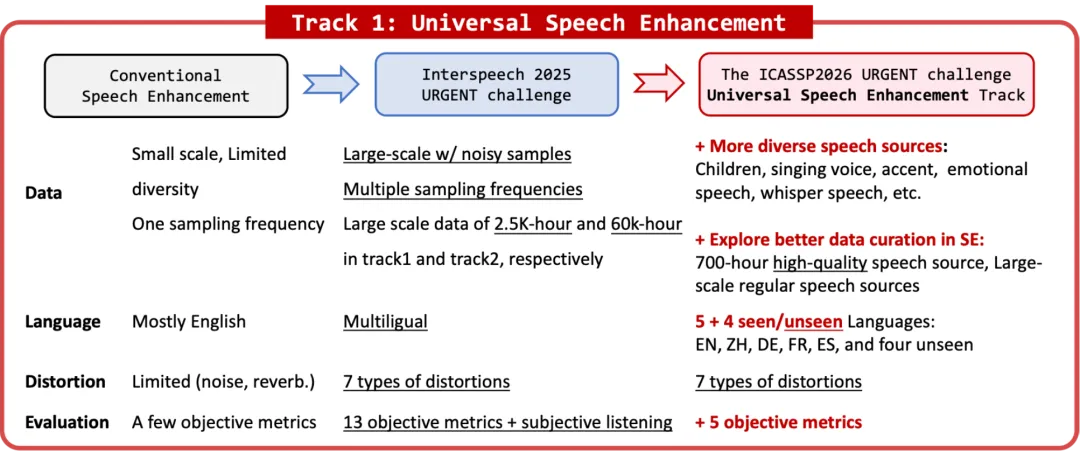
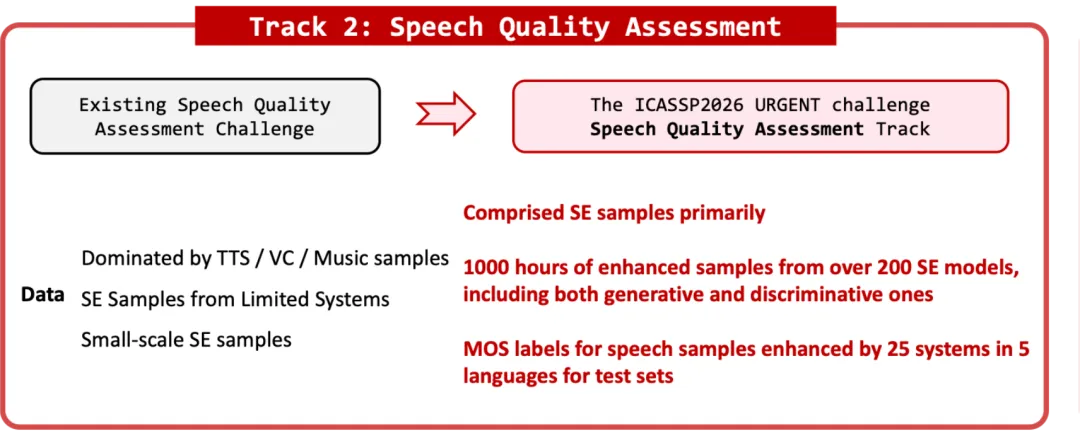
Track 2 聚焦增强语音质量评估,目标是预测不同增强系统输出语音的主观质量分数(MOS)。与一般的语音质量打分任务不同,本赛道强调“增强后语音”的感知质量建模,评测同时关注话语级与系统级预测和人工标注的一致性。
赛道二:语音质量评估
数据集与基线系统
Track 1 的训练数据由多类公开语音、噪声和房间脉冲响应资源构建而成,覆盖多语种、多年龄、多风格语音,包括朗读、会话、情感、歌声和耳语等条件。盲测集同时包含模拟样本和真实录音,并引入训练集中未出现的语言,用于检验系统在真实分布偏移下的泛化能力。
值得强调的是,本届 Track 1 明确提出“数据效率”导向:与其盲目扩大训练时长,不如通过数据管理筛选高价值样本。基线方案中也给出了从大规模语料中筛选高质量子集的实践路径,这一思路与本届挑战的设计理念高度一致。
Track 2 的训练数据整合了多类带 MOS 标注的语音质量数据,覆盖合成语音、语音转换、退化语音和增强语音等来源。盲测集包含 8,000 条 MOS 标注样本,来自 URGENT 2025 挑战盲测阶段的 16 个系统输出,能够较全面地检验模型跨系统、跨失真条件下的稳健性。
在基线系统方面,Track 1 同时提供了判别式与生成式两条技术路线。BSRNN [3]作为判别式基线,采用时频域建模框架,在增强效果、计算效率和工程可落地性之间取得了较好平衡,并通过 sampling-frequency-independent 处理方案适配多采样率输入[4]。FlowSE [5]作为生成式基线,将增强建模为从带噪分布到纯净分布的连续变换,核心是学习时间相关速度场并通过常微分方程求解得到结果。它通常在感知自然度和跨域泛化方面展现潜力,但性能与推理步数(NFE)关系更紧密,也带来一定计算开销。
Track 2 的官方基线是 Uni-VERSA-Ext [6]。该模型延续了 challenge 系列中“多指标联合监督”的思路,不仅拟合主观 MOS,也借助相关质量线索提升泛化表现,目标是在不同系统输出和不同失真模式下保持稳定预测。论文同时报告了 URGENT-PK 作为补充对比。URGENT-PK 可理解为感知对齐导向的排名学习范式,在系统级相关性上具有代表性,为后续 SQA 模型设计提供了有价值的对照视角。
评测与排名机制
Track 1 采用两阶段评测流程。第一阶段为资格评测,使用多项客观指标进行综合排序,指标覆盖非侵入式质量评价、侵入式语音质量与可懂度评价,以及下游相关能力评价。第二阶段为决选评测,第一阶段排名前列的系统进入主观听评(Mturk平台众包听音),采用 ITU-T P.808 的 ACR/CCR 协议,通过 MOS 与 CMOS 确定最终排名,并结合统计显著性分析保证结果可靠性。
Track 2 采用相关性与误差并重的评测框架,通过比较预测 MOS 与真实标注,计算 MSE、LCC、SRCC 和 Kendall’s tau 等指标,并在话语级和系统级双粒度上进行综合排名。这样的设计能够同时评估模型的局部预测精度与全局排序能力。
扫码访问官网,获取数据集与比赛基线
结果与观察
本届挑战吸引了大量社区参与。Track 1 注册队伍 80 支,Track 2 注册队伍 77 支,两个赛道合计 29 支队伍提交有效结果。其中 Track 1 共收到 23 份有效竞争提交,前 6 名进入主观评测;Track 2 共收到 6 份有效竞争提交。同时,共有4支优胜队伍的技术报告被ICASSP 2026大会收录[7-10]。
从技术趋势看,Track 1 领先方案普遍采用“生成式 + 判别式”的混合范式,常见实现包括双分支与多阶段流程,即利用生成式模型提升复杂失真条件下的恢复能力,再由判别式模块强化细节保真与稳定性。多个头部系统在技术报告中也反复强调,高质量数据筛选与定制化增强策略对跨域泛化提升至关重要。
Track 2 的头部系统在系统级和话语级上均与人工评分保持较高一致性,说明围绕增强语音场景构建的质量建模策略正在变得更成熟。作为补充对比,URGENT-PK 在系统级相关性指标上的表现也进一步印证了感知对齐范式的潜力。
扫码查看比赛排名
本文总结
本届 URGENT,我们更希望强调这样一种转变:语音增强正在从“单一任务优化”走向“真实世界能力评测”,而真实世界能力的关键并不只在模型结构本身,更在于数据质量、语音多样性与评测协议的协同设计。
从这个角度看,本次的比赛释放了三个清晰信号。第一,语音增强任务的数据管理会越来越重要,决定模型上限的往往不是总数据时长,而是训练样本的信息密度与分布覆盖。第二,通用性将成为下一阶段核心目标,系统需要在跨语言、跨说话风格、跨采样率和跨失真类型的条件下稳定工作。第三,语音增强评测方法本身需要被认真对待,如何选用、设计指标,会直接左右领域对"什么是好的增强系统"的判断。
ICASSP 2026 URGENT Speech Enhancement Challenge 通过双赛道设计,系统推动了语音增强与增强语音质量评估两个方向的发展。整体结果表明,高质量数据与有效数据管理是提升泛化能力的关键,生成式与判别式融合方案在复杂场景下具有明显优势,而面向真实应用的评测体系也需要持续坚持主客观结合和多维能力覆盖。
受篇幅限制,ICASSP 2026 URGENT 语音增强比赛的更细粒度分析(包括更完整的结果分析,统计数据等)将在后续技术报告中进一步展开。
参考文献
[1] C. Li et al., “ICASSP 2026 Urgent Speech Enhancement Challenge,” in ICASSP 2026 - 2026 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), May 2026, pp. 21919–21921. doi: 10.1109/ICASSP55912.2026.11461686.
[2] P. C. Loizou, Speech Enhancement: Theory and Practice. Boca Raton: CRC Press, 2007. doi: 10.1201/9781420015836.
[3] Y. Luo and J. Yu, “Music Source Separation With Band-Split RNN,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 31, pp. 1893–1901, 2023, doi: 10.1109/TASLP.2023.3271145.
[4] W. Zhang, K. Saijo, Z.-Q. Wang, S. Watanabe, and Y. Qian, “Toward Universal Speech Enhancement For Diverse Input Conditions,” in 2023 IEEE Automatic Speech Recognition and Understanding Workshop (ASRU), Dec. 2023, pp. 1–6. doi: 10.1109/ASRU57964.2023.10389733.
[5] S. Lee, S. Cheong, S. Han, and J. W. Shin, “FlowSE: Flow Matching-based Speech Enhancement,” in ICASSP 2025 - 2025 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), Apr. 2025, pp. 1–5. doi: 10.1109/ICASSP49660.2025.10888274.
[6] W. Wang, W. Zhang, C. Li, J. Shi, S. Watanabe, and Y. Qian, “Improving Speech Enhancement with Multi-Metric Supervision from Learned Quality Assessment,” in 2025 IEEE Automatic Speech Recognition and Understanding Workshop (ASRU), Dec. 2025, pp. 1–8. doi: 10.1109/ASRU65441.2025.11434718.
[7] R. Matsunaga, R. Takahashi, and S. Takamichi, “Three-Stage BSRNN for Universal Speech Enhancement and Data Curation Using a Large Pre-Trained Speech Restoration Model,” in ICASSP 2026 - 2026 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), May 2026, pp. 21904–21906. doi: 10.1109/ICASSP55912.2026.11464365.
[8] N. Goswami and T. Harada, “Hybrid Speech Enhancement with Discriminative and Codec Token Prediction Models Guided by Cleaned SSL Features for the ICASSP 2026 Urgent Challenge,” in ICASSP 2026 - 2026 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), May 2026, pp. 21916–21918. doi: 10.1109/ICASSP55912.2026.11461676.
[9] Y. Liu, C. Liu, X. Liang, H. Yan, S. Xue, and Z. Xue, “A hybrid discriminative and generative system for Universal speech enhancement,” in ICASSP 2026 - 2026 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), May 2026, pp. 21907–21909. doi: 10.1109/ICASSP55912.2026.11461249.
[10] X. Rong, Y. Wang, Z. Wang, and J. Lu, “GAP-URGENet: A Generative-Predictive Fusion Framework for Universal Speech Enhancement,” in ICASSP 2026 - 2026 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), May 2026, pp. 21895–21897. doi: 10.1109/ICASSP55912.2026.11463702.
供稿:李晨达,编辑:方楠,审核:钱彦旻
