
 语音小管家
论文链接: https://arxiv.org/abs/2604.10708v1
代码链接: https://zeyuet.github.io/Audio-Omni
发表会议: arxiv
Sora 带火了视频生成,但音频 AI 却一直深陷 "碎片化泥潭":做语音的不懂音乐,做生成的不会编辑,做理解的不能创作。你想做一条短视频配乐,得同时开 TTS、音乐生成、音效合成、音频剪辑四个工具,效果还不统一。
腾讯微信视觉 × 港科大最新发布的「Audio-Omni」彻底终结了这个局面。这是「首个真正意义上端到端的统一音频大模型」,仅用 7.9B 总参数(仅 3.05B 可训练),就在声音、音乐、语音三大领域同时打通理解、生成、编辑全链路,在 TTS、文本转音乐等核心任务上直接超越 F5-TTS、MusicGen 等专用专家模型。更绝的是,它还继承了大模型的 "超能力":懂世界知识、会上下文学习、零样本说 6 国语言。同时开源的百万级 AudioEdit 数据集,更是砸开了音频编辑领域的最后一道数据壁垒。
⏩一、音频 AI 的 "专科时代" 该结束了
在聊 Audio-Omni 之前,我们先直面一个扎心的现实:「现在的音频 AI,全是 "偏科生"」。
你手机里的语音助手只能听懂人话,不能给你写歌;你用的音乐生成工具只能生成旋律,不能识别里面用了什么乐器;你下载的音频编辑软件只能做简单的剪切拼接,不能听懂 "把这段里的猫叫声去掉,换成狗叫声" 这样的自然语言指令。
更离谱的是,这些工具之间完全不互通。一个专业音频创作者的工作流是这样的:
用 TTS 工具生成旁白 用音乐生成工具做背景音乐 用音效库找环境音 用剪辑软件把三者拼到一起 反复调整音量、节奏和过渡
整个流程要切换 5 个以上的工具,耗时几小时,而 Audio-Omni 能把这一切压缩成一句话指令:"给我生成一个 1 分钟的旅行 vlog 音频,开头是轻快的吉他,中间加海浪声和鸟鸣,结尾用温柔的女声旁白 ' 这就是我想要的夏天 '",一键输出完整的混合音频。
这就是「统一音频大模型」的魅力:一个模型,搞定所有音频任务。它不是多个工具的简单拼接,而是真正像人一样,能听懂声音、创作声音、修改声音。
⏩二、为什么统一音频大模型这么难做?
过去几年,无数团队尝试过统一音频能力,但都以失败告终,核心是绕不过三道坎:
第一道坎:三个音频世界,三套完全不同的逻辑
音频不是一个单一模态,而是三个 "平行宇宙":
「语音」:语义优先,核心是传递语言信息,音色只是附属品 「音乐」:结构优先,必须严格遵循旋律、节奏、和声的数学规律 「通用声音」:事件优先,只要能识别出 "这是狗叫" 或 "这是雨声" 就行
这三个领域的声学特征、语义结构、优化目标天差地别。之前的模型要么只能覆盖其中一两个,要么强行把它们塞到一个框架里,结果就是 "样样通,样样松"。
第二道坎:音频编辑数据,比黄金还稀缺
音频编辑是最实用但也最难的任务。要训练一个能听懂自然语言指令的编辑模型,需要大量 "原始音频 - 编辑指令 - 编辑后音频" 的三元组数据。但人工标注这样的数据成本是文本的 10 倍以上,之前最大的公开数据集也只有几万样本,而且大多是 "两个声音简单混合" 的合成数据,和真实场景差了十万八千里。
第三道坎:理解和生成,天生的范式冲突
音频理解是 "编码":把连续的声波转换成离散的语义符号;而音频生成是 "解码":把离散的语义符号还原成连续的声波。这两个过程的计算范式完全相反,之前的模型要么只能做理解,要么只能做生成,很难在一个框架里高效融合两者的优势。
⏩三、Audio-Omni 的破局之道:三个突破级设计
针对这三道坎,研究团队没有走 "堆参数" 的老路,而是用三个极其巧妙的设计,用最小的成本实现了最大的效果。
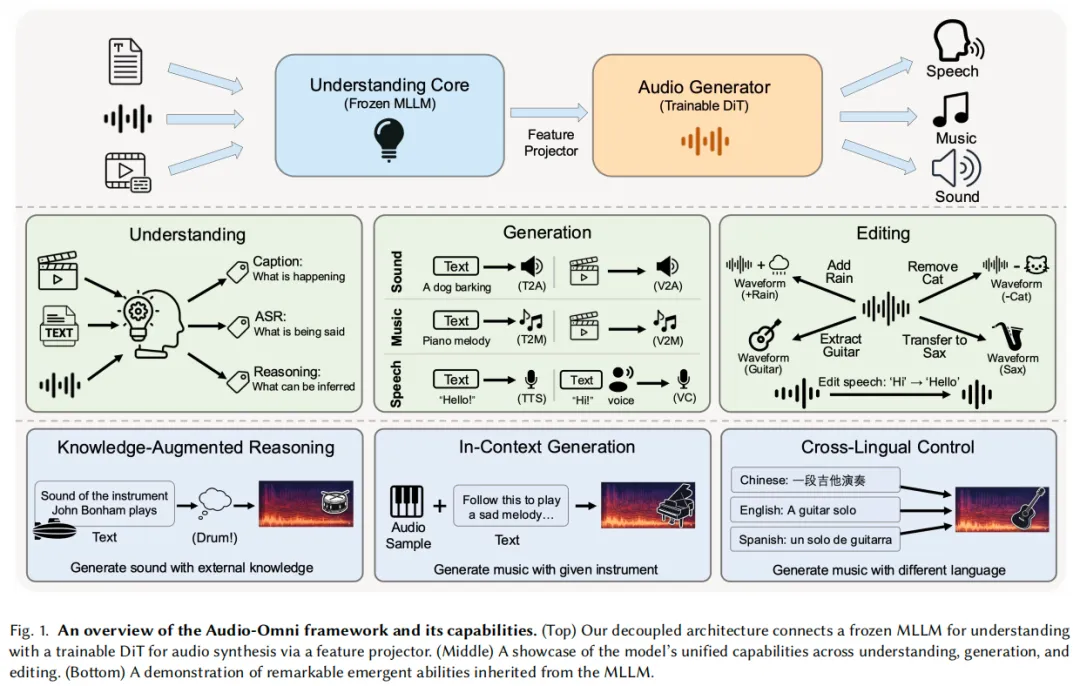
设计一:解耦架构 —— 借大模型的大脑,造自己的双手
Audio-Omni 最惊艳的就是它的「"大脑 - 双手" 解耦架构」,完美解决了理解与生成的范式冲突:
「大脑」:冻结的 Qwen2.5-Omni-3B,直接拿来一个已经训练好的多模态大模型,完全冻住不训练。它负责所有 "动脑子" 的活:理解自然语言指令、推理世界知识、处理视频等多模态输入。 「双手」:可训练的 DiT 生成器,只训练一个 36 层的 Diffusion Transformer,专门负责 "动手" 生成音频。它不需要懂世界知识,只需要听大脑的指挥,把语义信号转换成高质量的声波。 「桥梁」:轻量级特征投影层,用一个很小的投影层,把大模型输出的语义特征转换成 DiT 能理解的格式。
整个模型总参数 7.9B,但只有 3.05B 是可训练的,训练成本只有从头训练一个大模型的 1/10,却能完整继承大模型的所有能力。这就像你不用重新培养一个博士,只要给一个熟练工人配一个博士当顾问,就能干出博士级别的活。
双路条件机制:把指令拆成 "做什么" 和 "怎么做"
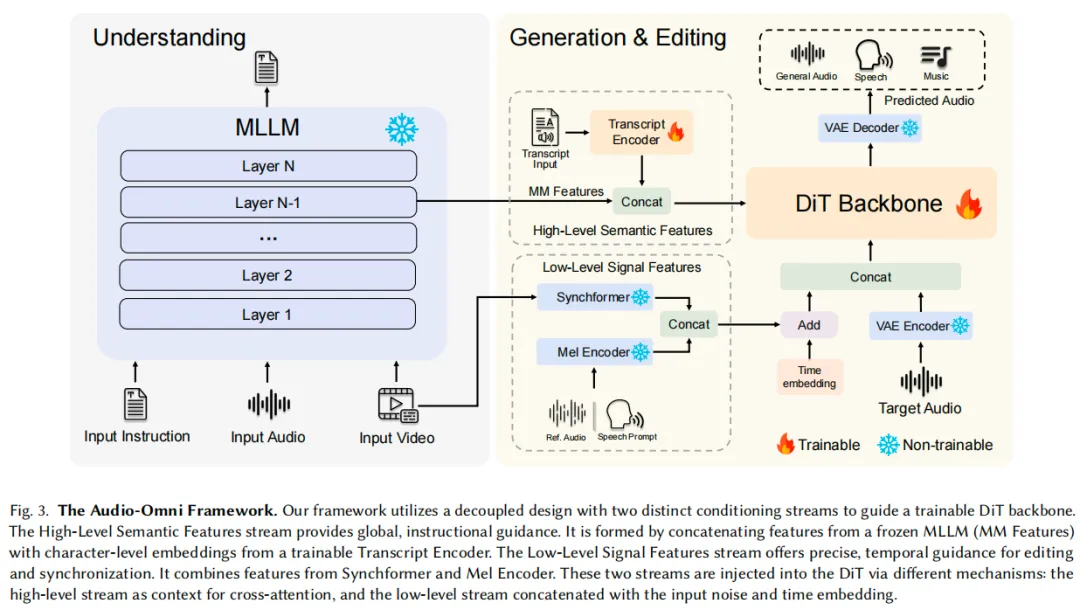
为了让 DiT 更好地理解指令,研究团队把所有输入条件拆成了两路:
「高层语义流」:大模型输出的语义特征 + 语音文本转录,通过交叉注意力注入 DiT 的每一层。这部分告诉模型 "要生成什么内容"。 「低层信号流」:参考音频的梅尔谱 + 视频同步特征,直接和输入噪声拼接。这部分告诉模型 "要生成什么样的声音"。
比如你说 "把这段男声改成女声,保留原来的语气和节奏",高层语义流负责理解 "改成女声" 这个指令,低层信号流负责保留原来的语气和节奏。
设计二:AudioEdit 数据集 —— 百万级样本砸开数据瓶颈
为了解决音频编辑数据稀缺的问题,研究团队花了几个月时间,打造了「全球最大的指令引导音频编辑数据集 AudioEdit」。
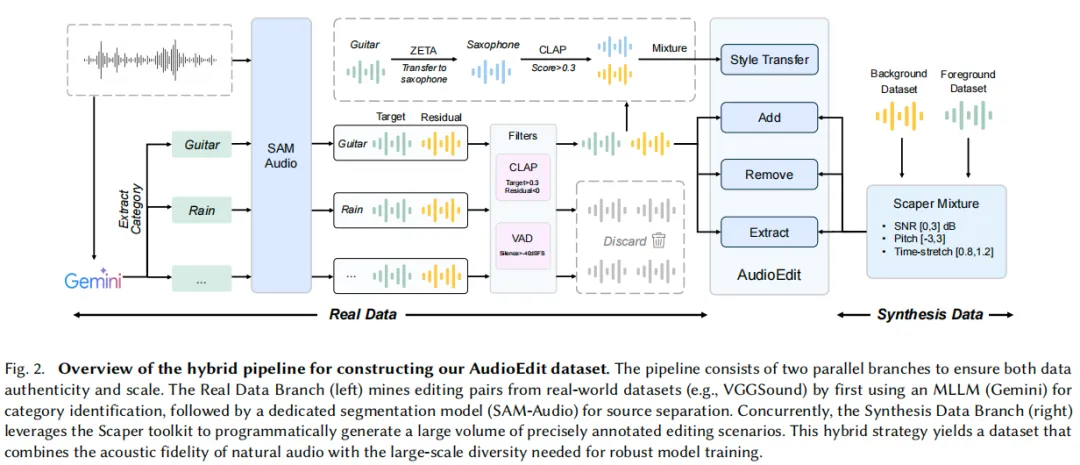
他们没有走纯人工标注的老路,而是设计了一个 "真实挖掘 + 程序合成" 的双流水线:
「真实数据流水线」:从 VGGSound 的 54 万条真实音频中,先用 Gemini 2.5 Pro 识别声音类别,再用 SAM-Audio 做源分离,把音频拆成目标音和背景音。然后生成添加、删除、提取三种任务的编辑对,再通过风格迁移生成 50 万条风格转换样本。 「合成数据流水线」:用 Scaper 工具把 ESC-50 的前景声音随机混合到 AudioCaps 的背景音中,生成 60 万条精确标注的合成样本。
最终,AudioEdit 包含「110 万训练样本 + 2000 高质量测试样本」,覆盖添加、删除、提取、风格迁移四大类编辑任务,而且 80% 以上的样本来自真实音频,彻底解决了之前合成数据的域迁移问题。
设计三:随机掩码策略 —— 一招激活零样本超能力
在训练语音任务时,研究团队加了一个极其简单却极其有效的技巧:「随机掩码 20%-75% 的语音提示梅尔谱」。
比如训练语音转换时,模型只能看到一小段说话人的声音,却要生成完整的转换后语音。这就强迫模型学会从局部信号推断全局的说话人音色特征。
就是这么一个简单的操作,让模型在推理时「自动获得了两个零样本能力」:
「零样本语音转换」:只要给 3 秒任意人的声音,就能把任何文本转换成这个人的声音 「零样本语音编辑」:只要说 "把这句话里的 ' 好' 改成 ' 不好 '",就能精确修改内容,同时保留原音色和语气
⏩四、大模型的馈赠:这些超能力,专用模型永远学不会
由于继承了 Qwen2.5-Omni 的大模型底座,Audio-Omni 获得了所有专用音频模型都不具备的涌现能力,这些能力完全超出了它的训练范围:
4.1 知识增强生成:它真的 "懂" 这个世界
普通的文本转音乐模型,你必须说 "生成一段电吉他 solo",它才能生成对应的音乐。而 Audio-Omni 能听懂:
"生成一段 Jimi Hendrix 风格的欢快音乐"
它会自动调用大模型的世界知识,知道 Jimi Hendrix 的标志性乐器是电吉他,演奏风格是狂野的布鲁斯摇滚,然后生成完全符合要求的音乐。
4.2 上下文生成:能顺着你的风格续写
给 Audio-Omni 一段你自己弹的钢琴片段,然后说:
"顺着这个旋律,续写一段 30 秒的副歌,情绪从悲伤转为激昂"
它会自动提取你钢琴的音色、旋律走向和情绪,然后生成风格完全一致的续写内容,就像同一个人演奏的一样。
4.3 零样本跨 6 国语言:没学过也能说
虽然 Audio-Omni 几乎只在英语数据上训练,但它继承了大模型的多语言能力,能「零样本支持中文、西班牙语、德语、法语、日语」的音频生成。实验表明,它生成的中文音频质量,甚至超过了一些专门在中文上训练的音频模型。
⏩五、实验结果:一个模型,单挑整个行业
当研究团队把 Audio-Omni 拉到各个赛道和专用模型单挑时,结果让所有人都惊呆了。
5.1 理解能力:和专用理解模型打平
首先是多模态音频理解基准测试:
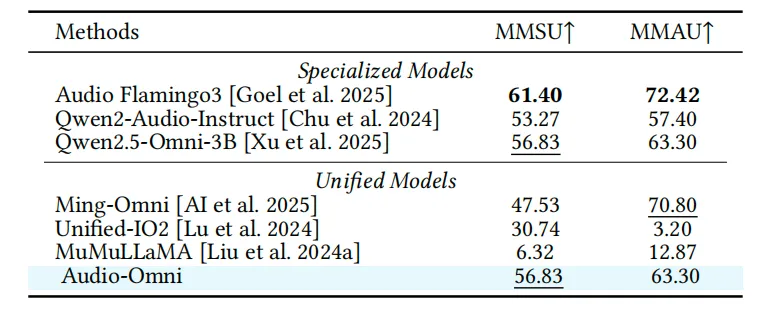
Audio-Omni 的理解能力完全继承了冻结的大模型,超过了所有其他统一模型,达到了专用理解模型的水平。
5.2 生成能力:多项 SOTA,超越专用专家
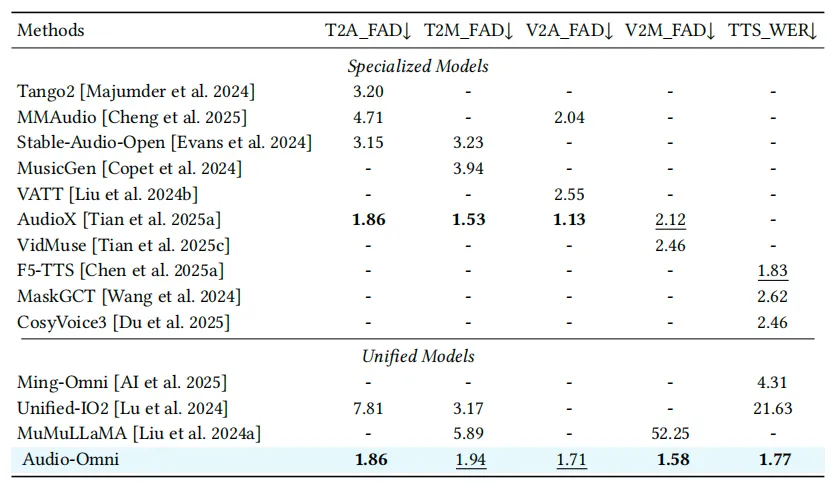
这是最震撼的部分,一个通用模型,居然在多个任务上打败了专门做这个任务的专家模型:
划重点:
在语音合成(TTS)任务上,WER=1.77,超过了当前最先进的 F5-TTS (1.83) 和 CosyVoice3 (2.46) 在视频转音乐任务上,FAD=1.58,大幅领先之前的 SOTA 所有五个生成任务,全部超过了之前的统一模型
5.3 编辑能力:全面碾压所有对手
在自己构建的 AudioEdit 基准上,Audio-Omni 的优势更加明显:
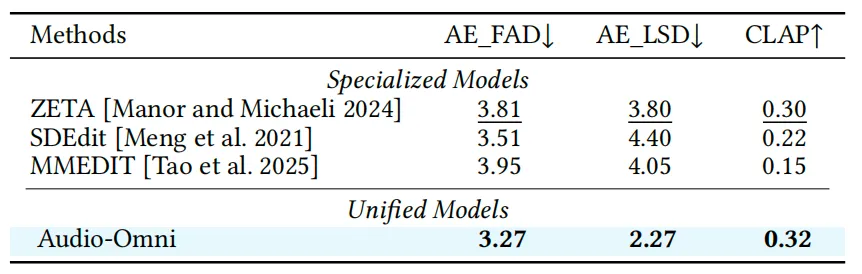
尤其是在衡量内容保真度的 LSD 指标上,Audio-Omni 比第二名低了 1.53,这意味着它编辑后的音频几乎和原始音频一样自然,没有明显的人工痕迹。
⏩六、写在最后:音频AI 的 "iPhone时刻" 来了
如果说 Sora 开启了视频生成的新时代,那么 Audio-Omni 就开启了统一音频 AI 的新时代。
它证明了一个极其重要的道理:「不需要从头训练一个超大模型,只要巧妙地利用已有的大模型作为理解核心,训练一个小的生成模块,就能在特定领域达到甚至超越专用模型的水平」。这个思路不仅适用于音频,也适用于视频、3D 等所有生成式 AI 领域。
对于普通用户来说,Audio-Omni 意味着音频创作的门槛将被彻底拉平。以后你不需要懂任何音频专业知识,只要会说话,就能创作出专业级的播客、配乐、有声书和音效。
对于行业来说,Audio-Omni 将彻底重构音频产业链。短视频、游戏、元宇宙、无障碍、教育等所有需要音频的领域,都将迎来生产力的爆发式增长。
研究团队已经宣布,将在近期开源全部代码、模型和 AudioEdit 数据集。相信在不久的将来,我们就能用上真正的 "全能音频助手",让每个人都能自由地表达自己的声音。
