大语言模型为什么能像人一样说话和思考?

李航,张少华,林苑 我们每天都在使用大语言模型(Large Language Model,LLM)。一个明显的感受是,它们似乎真的能够理解我们的语言,虽然有时也会出现幻觉。另一方面,观察 LLM 输出的思维链,也就是其推理过程的语言表示,我…
48 0 0

李航,张少华,林苑 我们每天都在使用大语言模型(Large Language Model,LLM)。一个明显的感受是,它们似乎真的能够理解我们的语言,虽然有时也会出现幻觉。另一方面,观察 LLM 输出的思维链,也就是其推理过程的语言表示,我…
论文链接: https://arxiv.org/abs/2604.10708v1 代码链接: https://zeyuet.github.io/Audio-Omni 发表会议: arxiv Sora 带火了视频生成,但音频 AI 却一直深陷…
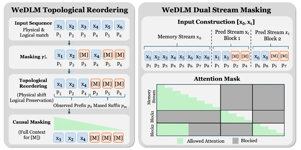
来源丨机器之心 讯微信 AI 团队提出 WeDLM(WeChat Diffusion Language Model),通过在标准因果注意力下实现扩散式解码,在数学推理等任务上实现相比 vLLM 部署的 AR 模型 3 倍以上加速,低熵场景更…
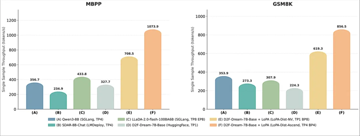
在大语言模型(LLMs)领域,扩散大语言模型(dLLMs)因其并行预测特性,理论上具备超越传统自回归(AR)模型的推理速度潜力。然而在实践中,受限于现有的解码策略,dLLMs 的单步生成往往局限于 1-3 个 Token,难以真正释放其并行…
来源丨机器之心 程爽,上海人工智能实验室和浙江大学联培博士生一年级;卞一涵,美国马里兰大学硕士生二年级,上海人工智能实验室实习生;刘大卫,上海人工智能实验室和上海交通大学联培博士生一年级;齐弼卿,上海人工智能实验室研究员(指导老师) 大模型…
蚂蚁的 Ling-1T终于发了,大半夜的 中文叫百灵,1T 参数,Instruct 版本、非推理、MoE架构 HuggingFace:https://huggingface.co/inclusionAI/Ling-1T GitHub:htt…
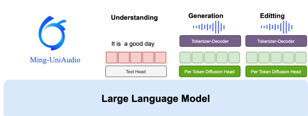
在大模型的浪潮下,语音领域也正迎来“整合与统一”的趋势。 过去我们往往需要分别调用不同的模型来完成语音识别(ASR)、语音生成(TTS)和语音编辑等任务,不仅开发成本高,而且在真实业务中很难实现流畅的衔接。 而这一次,阿里蚂蚁团队直接给出了…
论文标题:DeSTA2.5-Audio: Toward General-Purpose Large Audio Language Model with Self-Generated Cross-Modal Alignment Arxiv:h…
当语音大语言模型(SLLM)在英语等核心语言中流畅执行语音指令时,日语、法语等非核心语言场景却因语音 - 文本配对的指令跟随数据稀缺与多语言推理能力局限,面临响应质量显著下降的挑战。传统跨语言方法多聚焦文本领域,而 SLLM 以语音信号为输…