
 语音小管家
语音增强(Speech Enhancement, SE)旨在提升降质语音的质量,其中流匹配(Flow Matching)等生成模型因其卓越的感知质量而备受关注。然而,基于流的模型需要多次函数评估(Number of Function Evaluations, NFE)才能达到稳定且令人满意的性能,这导致模型推理的计算负荷较高,且在单次函数评估下的表现不佳。在本文中,我们提出了 MeanSE,这是一种利用平均流(Mean Flow)的高效生成式语音增强模型,该模型通过建模平均速度场来实现高质量的单次函数评估增强。实验结果表明,在单次函数评估条件下,我们提出的 MeanSE 显著优于流匹配基线(Baseline)模型,并展现出极强的域外泛化能力。
作者列表:Jiahe Wang,Hongyu Wang,Wei Wang,Lei Yang,Chenda Li,Wangyou Zhang,Lufen Tan,Yanmin Qian
合作单位:上海交通大学,Samsung Research China - Beijing (SRC-B),宇生月伴
论文原文:https://arxiv.org/abs/2509.21214
研究背景
语音增强[1]旨在提升被噪声、混响或干扰等因素降质的语音信号的质量与可懂度,是音频处理领域的一项基础任务。近年来,随着深度学习技术的发展,生成式模型在语音增强领域受到了广泛关注。与传统的判别式模型相比,生成式模型不仅能产生更优越的感知质量,还展现出更强的泛化能力。
在生成式方法的演进中,基于分数的生成模型(Score-based Generative Model)[2]率先取得成功,它们通过求解反向随机微分方程(Stochastic Differential Equation)来估计纯净语音。然而,此类方法通常需要较高的函数评估次数(NFE),导致计算负荷巨大,难以满足实际应用需求。随后,基于条件流匹配(Flow Matching)的FlowSE [3][4]模型作为一种轻量级替代方案应运而生。FlowSE通过学习时间相关的速度场(Velocity Field),将带噪语音分布映射为纯净语音分布,以较少的NFE实现了较好的性能。
尽管FlowSE在一定程度上降低了计算成本,但仍存在显著局限性。为了达到稳定且令人满意的增强效果,FlowSE仍需多次函数评估(例如5至20次NFE)。且更为关键的是,当NFE被限制为1次时,其性能会显著下降,甚至崩溃。这一缺陷使得基于流匹配的方法在面对实时语音增强等计算资源受限的应用场景时,显得计算成本过高且实用性不足。
综上所述,如何在保留生成模型优异感知质量特性的同时,突破低NFE下的性能瓶颈,实现高效且高质量的单步语音增强,成为当前亟待解决的关键问题。
方法概述
1. 基于流匹配(Flow Matching)的语音增强
本文选择FlowSE [3]作为基线(Baseline)模型,该方法采用了条件流匹配(Conditional Flow Matching)框架来进行语音增强。在FlowSE中,语音增强被建模为一个常微分方程(Ordinary Differential Equation)问题。具体而言,给定带噪语音,模型将其作为条件构建一个“流”。该流定义了一个依赖时间的瞬时速度场(Velocity Field):
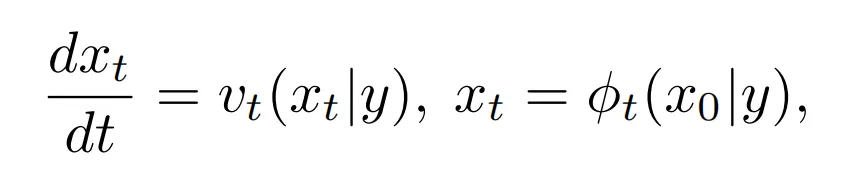
通过求解该速度场,可以将带噪语音分布这一简单且易获取的数据分布,从t = 1的虚拟时间开始,逐渐变换至t = 0时的纯净语音分布这一复杂的数据分布,公式中x1代表带噪语音,x0代表变换后的纯净语音。
在训练阶段,FlowSE的目标是利用深度神经网络来拟合这一瞬时速度场:
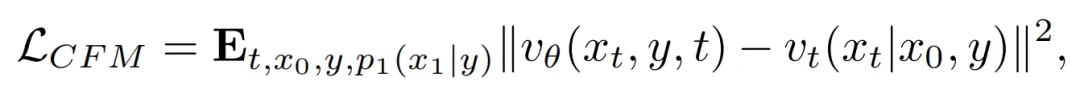
具体地,模型构建了一条从时间t = 1开始的带噪语音到t = 0时的纯净语音的高斯条件概率路径。对于给定的训练样本对模型通过插值公式生成语音数据的中间状态:
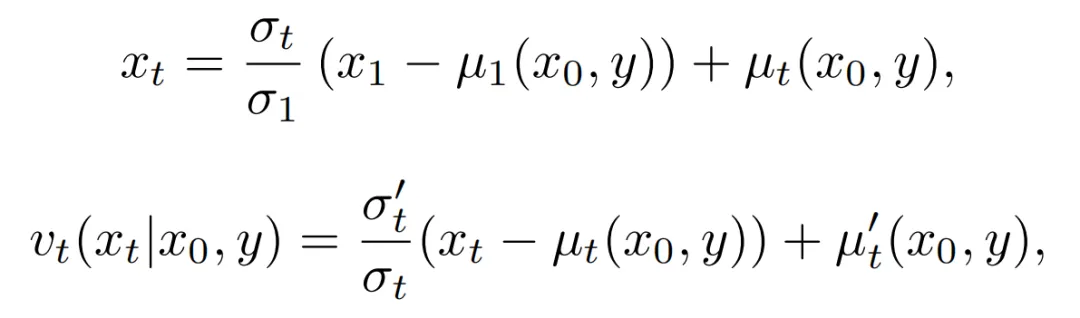
其均值和方差随时间线性变化。训练损失函数定义为神经网络预测的速度场与基于条件构建的真实瞬时速度场之间的均方误差。通过最小化该损失,网络学会了在任意时间步预测数据的运动方向。
在推理阶段,我们可以通过从带噪语音分布中采样起始点,利用数值求解器(如欧拉法)对常微分方程ODE进行积分求解,逐步推导出纯净语音:
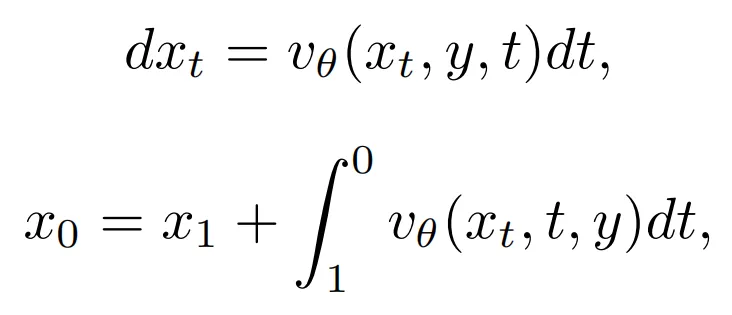
为了保证数值求解的稳定性和生成纯净语音的质量,推理时通常需要将时间区间细分为多个子区间进行多次评估。这种对多步数值积分的依赖,导致了FlowSE在低NFE条件下性能严重退化,增加了推理时的计算负担。
2. 基于平均流(Mean Flow)的语音增强
本文提出的MeanSE 升级了传统的流匹配方法,采用了更先进的平均流(Mean Flow)框架。这二者之间的根本差异在于模型学习的目标:传统流模型学习的是“瞬时速度场”(Instantaneous velocity field),即在流程中每一个无限小的时间点上,数据点应该向哪个方向移动;而MeanSE学习的是“平均速度场”(Average velocity field),即在一个有限的时间区间内,状态从起点到终点所需的平均移动速度,以时间区间[t, r]为例:
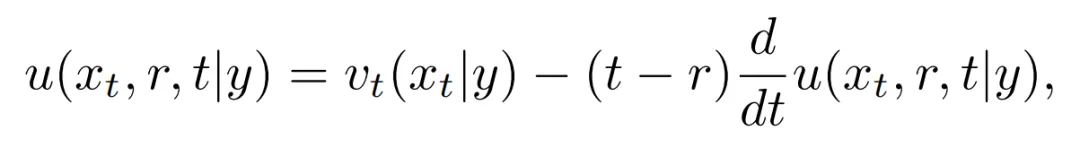
这一改变允许模型在推理时,仅用一步反向迭代(1-NFE)就直接预测出从噪声起点到纯净终点的整体变换。在数学形式上,如果我们对上图中的公式左右两边进行求导,可以发现平均速度与瞬时速度之间存在特定的微分关系:
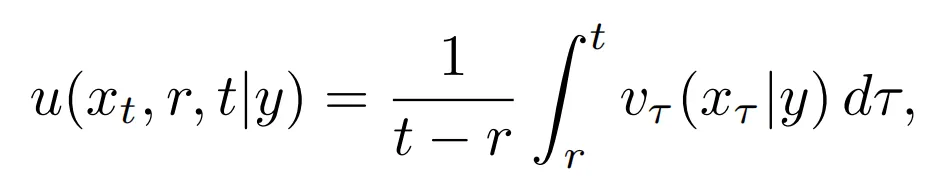
这使得模型可以通过类似的训练框架进行优化。MeanSE的训练目标是利用深度神经网络来拟合这一平均速度场,损失函数采用预测值与真实平均速度之间的均方误差:
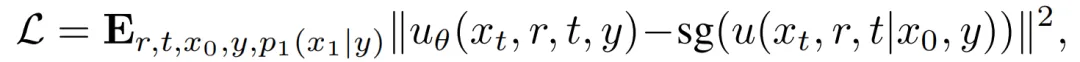
在推理时,整个“流”的变换过程的计算与FlowSE模型中的计算表达式相同,然而在变换的本质上,数值积分的计算过程退化成了简单的“逐区间计算平均位移”的过程:
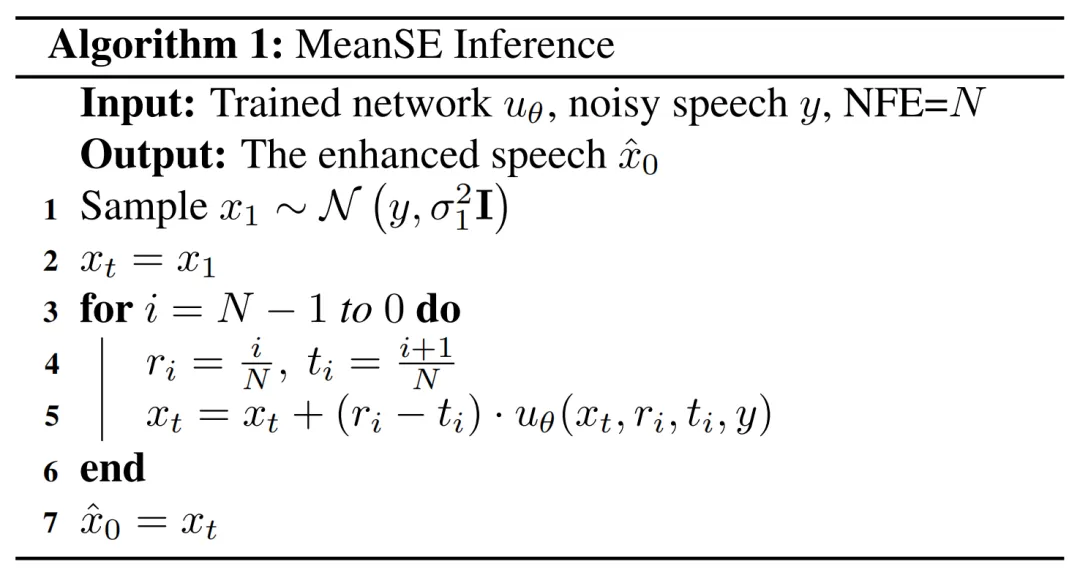
其中若设定NFE为1,增强过程简化为直接利用网络预测的平均速度对初始带噪语音进行一步修正,极大地提升了推理效率。此外,针对直接学习平均速度场可能导致训练不稳定的问题,MeanSE还引入了两项关键策略。其一是“流场混合”,在训练中以一定比例强制网络学习瞬时速度(即令r = t),从而保留流匹配的特性。其二是“时间区间课程学习(Curriculum Learning)”,模型在训练初期仅学习小时间间隔的平均速度,随后逐步扩大间隔至全时间范围,从而维护一个稳定收敛的训练过程。
实验结果
01、在VoiceBank-DEMAND数据集上的集内测试:
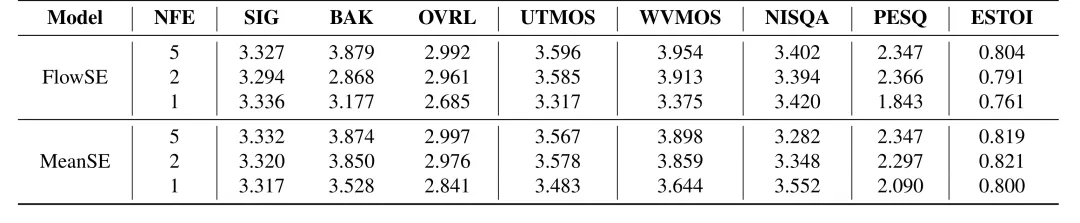
表1:集内测试(模型均在VoiceBank-DEMAND数据集上进行训练和测试,“流场混合”比例固定设置为0.75):
在VoiceBank-DEMAND [7][8]数据集上的集内测试中,MeanSE首先在多步(对应表中2步或5步)反向迭代时与基于流匹配的基线模型(FlowSE)性能相当,两个模型在所有的性能指标上互有胜负。而在一步反向迭代(1-NFE)的设置下,MeanSE在除DNSMOS的SIG指标之外的所有指标上,性能表现显著优于FlowSE,展现出在单步推理上的巨大优势,使其在需要极低延迟的实时场景中具有不可替代的价值。
02、在WHAMR!数据集上的跨数据集泛化性测试:
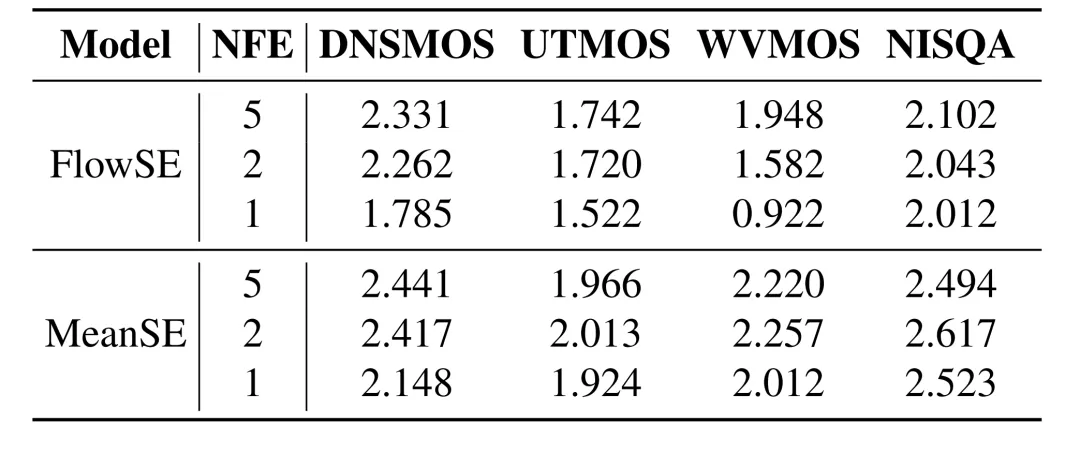
表2:跨数据集泛化性测试(模型均在VoiceBank-DEMAND数据集上训练,并在WHAMR!数据集上测试,“流场混合”比例固定设置为0.75)
在WHAMR! [9]数据集上的跨数据集的泛化性测试(模型在VoiceBank-DEMAND数据集上训练)中,MeanSE的优势更为明显,不管是在多步还是单步推理的设定下,MeanSE在数个非侵入性指标上全面大幅超越了基线模型FlowSE。尤其是在单步推理(1-NFE)的设置下,基线模型FlowSE在个别指标(WVMOS)上几乎失效,而MeanSE依然能生成有效的增强语音。这证明了均值流模型学习到的平均速度场具有更优的鲁棒性和泛化性。
03、关于“流场混合”(FlowField Mixup)参数的消融实验:
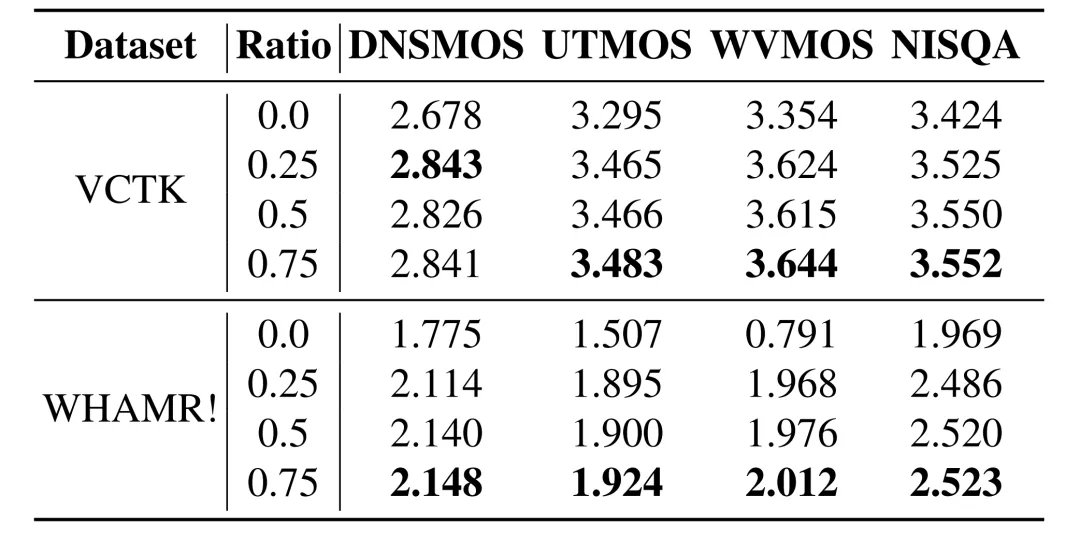
表3:关于“流场混合”(FlowField Mixup)参数的消融实验(NFE固定设置为1)
在训练阶段,MeanSE 模型采用“流场混合”(FlowField Mixup)策略来稳定训练过程。模型以一定的概率(flow ratio)采样两个相同时间步(t = r)来组成时间区间,此时平均速度场会退化为瞬时速度场,从而强制让神经网络以标准流匹配的方式进行训练,避免了直接从头回归平均速度场导致的不稳定性。消融实验表明,“流场混合”策略的参数设定对训练的稳定性和最终性能至关重要。如果不采用该策略会导致训练失败,而将其设置为0.75时能取得最佳效果,这一结论与先前同样基于平均速度流的相关工作[6]高度一致。
本文总结
近年来,生成式语音增模型强异军突起,正成为解决语音“保真度”与“泛化性”难题的新范式。与直接学习“从带噪语音到纯净语音”映射的判别式模型不同,生成式模型学习的是纯净语音本身的分布。这使得它们不仅能输出更自然、细节更丰富的语音,还对训练时未见的噪声类型展现出惊人的鲁棒性。然而,早期的扩散模型虽效果出色,但迭代采样导致计算开销巨大。Flow模型通过常微分方程(ODE)路径,将采样步数从几十步大幅缩减至几步。MeanSE进一步通过建模“平均速度场”,实现了高质量的单步增强。总之,基于流模型的系列工作凭借其高效、高质和高泛化能力的独特优势,正在推动生成式语音增强走向实用,为生成式模型用于实时通信、音频修复等场景带来了新的可能性。
参考文献
[1] Xu Y, Du J, Dai L R, et al. An experimental study on speech enhancement based on deep neural networks[J]. IEEE Signal processing letters, 2013, 21(1): 65-68.
[2] Richter J, Welker S, Lemercier J M, et al. Speech enhancement and dereverberation with diffusion-based generative models[J]. IEEE/ACM Transactions on Audio, Speech, and Language Processing, 2023, 31: 2351-2364.
[3] Lee S, Cheong S, Han S, et al. Flowse: Flow matching-based speech enhancement[C]//ICASSP 2025-2025 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2025: 1-5.
[4] Wang, Z., Liu, Z., Zhu, X., Zhu, Y., Liu, M., Chen, J., Xiao, L., Weng, C., Xie, L. (2025) FlowSE: Efficient and High-Quality Speech Enhancement via Flow Matching. Proc. Interspeech 2025, 4858-4862, doi: 10.21437/Interspeech.2025-1745
[5] Zhengyang Geng, Mingyang Deng, Xingjian Bai, J Zico Kolter, & Kaiming He (2025). Mean Flows for One-step Generative Modeling. In The Thirty-ninth Annual Conference on Neural Information Processing Systems.
[6] Li X, Liu J, Liang Y, et al. Meanaudio: Fast and faithful text-to-audio generation with mean flows[J]. arXiv preprint arXiv:2508.06098, 2025.
[7] Yamagishi J, Veaux C, MacDonald K. CSTR VCTK Corpus: English multi-speaker corpus for CSTR voice cloning toolkit (version 0.92)[J]. The Rainbow Passage which the speakers read out can be found in the International Dialects of English Archive:(http://web. ku. edu/~ idea/readings/rainbow. htm)., 2019.
[8] Thiemann J, Ito N, Vincent E. The diverse environments multi-channel acoustic noise database (demand): A database of multichannel environmental noise recordings[C]//Proceedings of Meetings on Acoustics. Acoustical Society of America, 2013, 19(1): 035081.
[9] Maciejewski M, Wichern G, McQuinn E, et al. WHAMR!: Noisy and reverberant single-channel speech separation[C]//ICASSP 2020-2020 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2020: 696-700.
供稿:王嘉禾,编辑:方楠,审核:钱彦旻
