
 语音小管家
在大模型的浪潮下,语音领域也正迎来“整合与统一”的趋势。
过去我们往往需要分别调用不同的模型来完成语音识别(ASR)、语音生成(TTS)和语音编辑等任务,不仅开发成本高,而且在真实业务中很难实现流畅的衔接。
而这一次,阿里蚂蚁团队直接给出了一个“一体化方案”——Ming-UniAudio。它是一款端到端的统一语音模型,能够在一个框架下同时完成识别、生成、编辑等语音相关任务。
GitHub 项目地址:https://github.com/inclusionAI/Ming-UniAudio
ModelScope 模型地址:https://modelscope.cn/models/inclusionAI/Ming-UniAudio-16B-A3B
更让人惊喜的是,它的语音编辑能力极具创新性:无需手动选择片段,用自然语言就能对音频进行插入、删除、替换、降噪、变声、方言转换。
在中文语音生成任务上,WER仅0.95%,超Qwen3-Omni的1.07%和Seed-TTS的1.12%;普通话/英语识别与Kimi-Audio、Qwen2.5同梯队,方言识别能力爆棚。
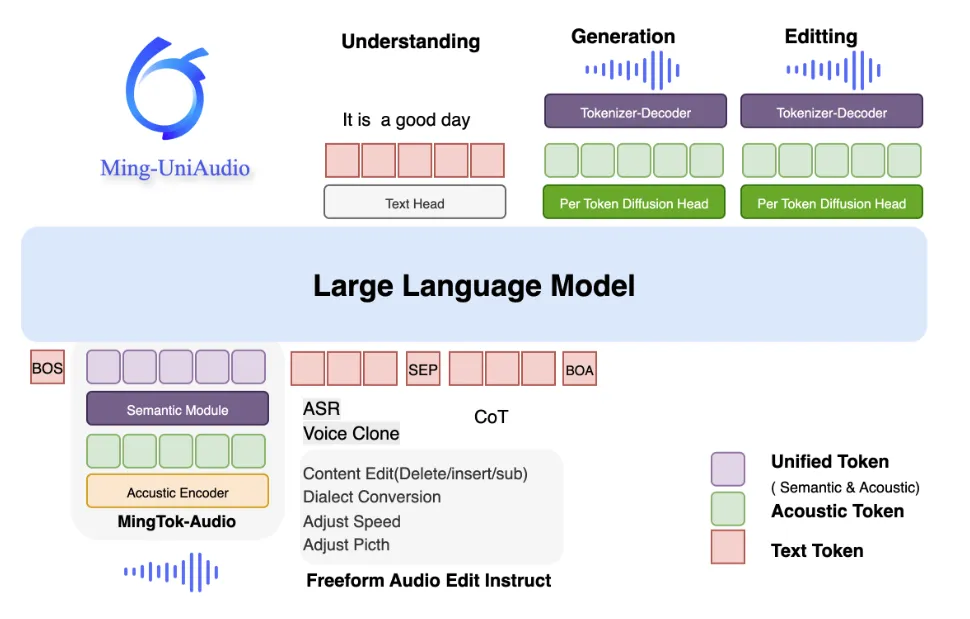
核心功能
•自由编辑:自然语言指令自动语义/声学修改,支持降噪/变速/方言转换。 •统一分词器:MingTok-Audio压缩波形为离散词元,端到端闭环。 •多任务SOTA:理解/生成/编辑基准领先,中文方言/英语识别强。
快速入手
对于开发者来说,上手 Ming-UniAudio 也非常简单。
首先,通过 modelscope 下载模型。
pip install modelscope
modelscope download --model inclusionAI/Ming-UniAudio-16B-A3B --local_dir inclusionAI/Ming-UniAudio-16B-A3B  --revision master
然后通过 docker 可快速安装。
# 克隆此仓库
git clone --depth 1 https://github.com/inclusionAI/Ming-UniAudio
cd Ming-UniAudio

# 构建 docker 镜像
docker build -t ming:py310-cu121 docker/docker-py310-cu121

# 启动容器并将当前仓库目录挂载
docker run -it --gpus all -v "$(pwd)":/workspace/Ming-UniAudio ming:py310-cu121 ming:py310-cu121 /bin/bash
官方还提供了一个关于此仓库使用的简单示例。
import warnings
import torch
from modelscope import AutoProcessor

from modeling_bailingmm import BailingMMNativeForConditionalGeneration

import random
import numpy as np
from loguru import logger

def seed_everything(seed=1895):
    random.seed(seed)
    np.random.seed(seed)
    torch.manual_seed(seed)
    torch.cuda.manual_seed(seed)
    torch.cuda.manual_seed_all(seed)
    torch.backends.cudnn.deterministic = True
    torch.backends.cudnn.benchmark = False

seed_everything()
warnings.filterwarnings("ignore")

class MingAudio:
    def __init__(self, model_path, device="cuda:0"):
        self.device = device
        self.model = BailingMMNativeForConditionalGeneration.from_pretrained(
            model_path,
            torch_dtype=torch.bfloat16,
            low_cpu_mem_usage=True,
        ).eval().to(torch.bfloat16).to(self.device)
        self.processor = AutoProcessorinclusionAI/Ming-UniAudio-16B-A3Bfrom_pretrained(".", trust_remote_code=True)
        self.tokenizer = self.processor.tokenizer
        self.sample_rate = self.processor.audio_processor.sample_rate
        self.patch_size = self.processor.audio_processor.patch_size

    def speech_understanding(self, messages):
        text = self.processor.apply_chat_template(messages, add_generation_prompt=True)
        image_inputs, video_inputs, audio_inputs = self.processor.process_vision_info(messages)

        inputs = self.processor(
            text=[text],
            images=image_inputs,
            videos=video_inputs,
            audios=audio_inputs,
            return_tensors="pt",
        ).to(self.device)

        for k in inputs.keys():
            if k == "pixel_values" or k == "pixel_values_videos" or k == "audio_feats":
                inputs[k] = inputs[k].to(dtype=torch.bfloat16)
        logger.info(f"input: {self.tokenizer.decode(inputs['input_ids'].cpu().numpy().tolist()[0])}")

        generated_ids = self.model.generate(
            **inputs,
            max_new_tokens=512,
            eos_token_id=self.processor.gen_terminator,
        )
        generated_ids_trimmed = [
            out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
        ]
        output_text = self.processor.batch_decode(
            generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
        )[0]

        return output_text

    def speech_generation(
        self,
        text,
        prompt_wav_path,
        prompt_text,
        lang='zh',
        output_wav_path='out.wav'
    ):
        waveform = self.model.generate_tts(
            text=text,
            prompt_wav_path=prompt_wav_path,
            prompt_text=prompt_text,
            patch_size=self.patch_size,
            tokenizer=self.tokenizer,
            lang=lang,
            output_wav_path=output_wav_path,
            sample_rate=self.sample_rate,
            device=self.device
        )

        return waveform

    def speech_edit(
        self,
        messages,
        output_wav_path='out.wav'
    ):
        text = self.processor.apply_chat_template(messages, add_generation_prompt=True)
        image_inputs, video_inputs, audio_inputs = self.processor.process_vision_info(messages)

        inputs = self.processor(
            text=[text],
            images=image_inputs,
            videos=video_inputs,
            audios=audio_inputs,
            return_tensors="pt",
        ).to(self.device)

        ans = torch.tensor([self.tokenizer.encode('<answer>')]).to(inputs['input_ids'].device)
        inputs['input_ids'] = torch.cat([inputs['input_ids'], ans], dim=1)
        attention_mask = inputs['attention_mask']
        inputs['attention_mask'] = torch.cat((attention_mask, attention_mask[:, :1]), dim=-1)
        for k in inputs.keys():
            if k == "pixel_values" or k == "pixel_values_videos" or k == "audio_feats":
                inputs[k] = inputs[k].to(dtype=torch.bfloat16)
        logger.info(f"input: {self.tokenizer.decode(inputs['input_ids'].cpu().numpy().tolist()[0])}")

        edited_speech, edited_text = self.model.generate_edit(
            **inputs,
            tokenizer=self.tokenizer,
            output_wav_path=output_wav_path
        )
        return edited_speech, edited_text

if __name__ == "__main__":
    model = MingAudio("inclusionAI/Ming-UniAudio-16B-A3B")

    # ASR
    messages = [
        {
            "role": "HUMAN",
            "content": [
                {
                    "type": "text",
                    "text": "Please recognize the language of this speech and transcribe it. Format: oral.",
                },

                {"type": "audio", "audio": "data/wavs/BAC009S0915W0292.wav"},
            ],
        },
    ]

    response = model.speech_understanding(messages=messages)
    logger.info(f"Generated Response: {response}")

    # TTS
    model.speech_generation(
        text='我们的愿景是构建未来服务业的数字化基础设施,为世界带来更多微小而美好的改变。',
        prompt_wav_path='data/wavs/10002287-00000094.wav',
        prompt_text='在此奉劝大家别乱打美白针。',
    )
我们之后可以使用 Python 接口来运行模型。
写在最后
在 AI 语音领域,“一体化” 是大趋势。从OpenAI的Whisper、微软的SpeechT5,再到蚂蚁的Ming-UniAudio,大家都在往多任务统一模型的方向演进。
过去我们要做一个语音相关的应用,每个环节都需要调用不同的模型或 SDK,不仅繁琐,而且在多语言、多音色、多场景下效果参差不齐。
而 Ming-UniAudio 直接把这一切融合到一个统一的端到端模型中。通过统一的连续语音分词器,它可以同时理解语义和声学特征,这意味着无论你是要“识别”“生成”还是“编辑”,模型都能在同一个空间里流畅地处理。
这种设计就像是语音领域的“多合一瑞士军刀”,一刀切掉了过去的繁琐。
我相信它会成为下一代语音应用的重要基石。无论是播客创作者、会议平台,还是 AI 初创公司,都能在它的基础上快速构建出新的产品形态。
最后一句话,语音的“Photoshop”来了。
