
 语音小管家
题目:MDPE: A Multimodal Deception Dataset with Personality and Emotional Characteristics
作者:蔡聪,梁山,柳雪飞,朱康,温正棋,陶建华,解衡,崔济舟,马一鸣,程振华,许瀚哲,傅睿博,刘斌,李永伟
主要单位:清华大学,中科院自动化所,北京理工大学,西交利物浦大学
论文链接:
数据集下载链接:https://huggingface.co/datasets/MDPEdataset/MDPE_Dataset
摘 要
该工作构建了一个多模态的人格-情感-欺诈数据集(MDPE),对欺诈数据集首次引入了丰富的人格属性与情感特征,它可以探索个体差异对欺诈行为的影响。此外,我们还进行了大量实验,为未来的欺诈检测研究提供了有价值的见解。MDPE不仅支持欺诈检测,还为人格识别和情感识别等任务提供了条件,鼓励研究者在个人差异的情感计算领域进行深入探索。
引 言
欺诈是误导他人、隐藏真相或提供虚假信息的行为,形式多样,发生在各种情境中,通常不道德且损害信任。随着欺诈在社交媒体等新领域的扩展,需要可靠的检测系统。传统方法(如测谎仪)有侵入性等缺点。视频分析能以更便宜、更快、非侵入性的方式提取行为线索(如面部表情、身体动作、微表情),成为当前研究重点。结合多种信息来源(生理、心理、视觉、语言、声学、热成像等)比单一模态(单峰)效果更好,能构建更可靠、更鲁棒的检测系统。
大量证据表明,在欺诈产生和检测能力方面存在显著的个体差异。这些差异包括认知处理、人格特征、心理特征和情感表达能力。实证研究证实,人格因素和情绪线索对被试欺诈和检测欺诈的能力有关键影响。情感是人类交流的一个基本维度,它与认知相互作用,在人际交往和人机交互中指导社会行为。这种关系与欺诈尤其相关,因为欺诈行为会引发独特的情绪状态,表现为行为线索。然而,利用情感特征来提高欺诈检测的准确性仍然具有挑战性。一个主要的复杂因素是,情绪表达本身就是欺诈的核心组成部分,因此很难辨别欺诈者表现出的情绪是真实的还是策略性的捏造。
为了解决这个问题,我们提出了一个多模态欺诈数据集MDPE。MDPE是目前最大的已发布多模态欺诈数据集,且是唯一同时包含人格属性与情感属性的欺诈数据集:
总之,我们的贡献有三方面:
1.我们提出了一种新的多模态欺诈数据集MDPE,具有人格和情感特征,由面部视频、录音和文字记录组成。研究人员还获得了一个易于复制的实验方案。
2.我们为多模态信号的欺诈检测提供了一个基准,并讨论了人格特征和情绪线索对欺诈检测的影响。
3.我们提供了新的可能性,以促进进一步的情感计算研究,鼓励开发利用个体差异进行欺诈检测的新方法,以及用于人格识别和情感识别等任务。
数据集采集流程
我们招募一些被试在实验室环境下完成数据采集,每个被试都需完成以下三个实验:人格、情感和欺诈实验。
人格特征采集:被试需要完成一份由60个项目组成的五大人格问卷——开放性、责任心、外向性、宜人性和神经质。
情感实验:数据员随机挑选16个情感诱导视频((悲伤 高兴 放松 惊讶 恐惧 厌恶 生气 中性,确保每种情绪有2个视频)供被试观看。在观看每个视频后,被试需要描述他们的感受,然后填写情感量表。
欺诈实验:面试官会对被试进行一场欺诈测试,共询问24个事先准备好的问题。
开始前,数据员会随机挑选9个必须撒谎的问题,并将其交给被试(面试官不知道是哪些问题)。被试最多有15分钟的时间进行准备,在准备过程中,他们必须记住这9个问题,并思考在即将到来的面试过程中如何欺诈。在面试过程中,当被问到这9个问题时,被试必须撒谎,当被问及剩下的15个问题时必须说实话。我们加入了奖金补偿机制,也就是被试欺诈成功次数越多,会得到越多的奖金。
在面试过程中,面试官随机问了24个问题,并对每个问题给出了他们对真实或欺诈性答案的判断。面试官填写了面试官判断量表,表明他对每个欺诈问题的判断。面试结束后,被试还需填写被试谎言信心量表,表明被试对每个欺诈问题的自信程度。
数据集统计分析
我们共采集了193名被试的数据,其中包括130名女性和63名男性,年龄从18岁到69岁不等,他们都是以中文为母语的人。每个被试对24个欺诈问题做出了回答,总共得到1737个欺诈问题和2895个真实问题。此外,每位参与者提供了16个情绪诱导视频,共3088个情绪视频记录。在数据收集之后,原始视频记录被分割。单个欺诈性视频片段的持续时间从4分钟到27分钟不等,而情感视频的持续时间则从19分钟到38分钟不等,。总共获得了1808分钟的欺诈性视频和4401分钟的情感视频,总计6209分钟的视频内容。
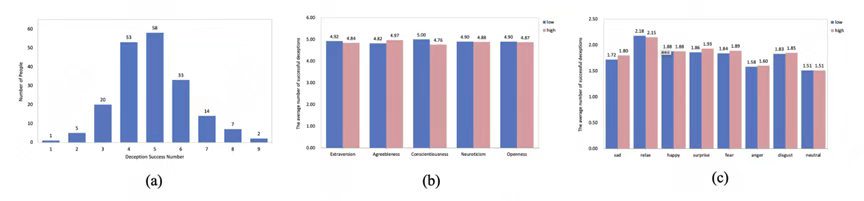
图1展示了我们对数据集的初步分析情况。图1(A)揭示了所有被试成功欺诈次数的分布情况,大多数被试的欺诈成功次数在3-6次之间。图1(b)显示了按性格类别划分的成功欺诈的平均数量。根据平均得分,被试被分为五大人格特质的高组和低组。分析表明,高/低神经质或开放性之间的欺诈成功率没有显著差异。然而,在外向性低、顺从性高和责任心低的个体中,欺诈成功率明显更高。关于低外向性的发现可能是由于人们倾向于更加谨慎,通过夸大来揭示漏洞的可能性降低。以合作和信任为特征的宜人性得分高的人可能更容易获得信任和善意,这可能会降低面试官的警惕性。同样,那些责任心低的人通常不太重视规则、义务和社会规范。这与自控理论和一般犯罪理论等学科的既定观点相一致。图1(c)显示了情绪实验中表达的每种情绪的平均强度,比较了欺诈成功率高和低的被试。表现出较高欺诈成功率的人表现出更高的情感表达能力。这可能反映出成功的骗子有更大的能力去理解和模拟他人的情绪,从而形成一个更敏感、更被动的情绪系统。这一观察结果与现有的情感和认知理论相一致。
基准实验
数据预处理:原始视频被标准化为每秒30帧。使用DLib裁剪和对齐人脸。音频统一标准化为单声道16kHZ,并提取声学特征。转录文本是使用Paraformer工具包生成的。
特征提取:对于每个模态,我们都提取了一些特征来进行基准实验。视觉特征包括CLIP、VIT;音频模态包括情感手工特征eGeMAPS、HUBERT、Wav2vec2、WavLM;文本特征包括BERT、ChatGLM2-6B、Baichuan-13B;
模型结构:对于单模态特征,我们利用全连接层来提取隐藏的表示并预测欺诈;对于多模态特征,我们计算每种模态的重要性得分,并利用加权融合来获得多模态特征。对于人格特征和情感表达特征,通过拼接实现特征融合。人格特征直接来源于人格量表得分。情绪表达特征是通过事先训练一个专用的情绪识别模型来获得的。并且用于人格识别和情绪识别任务的模型架构相同。
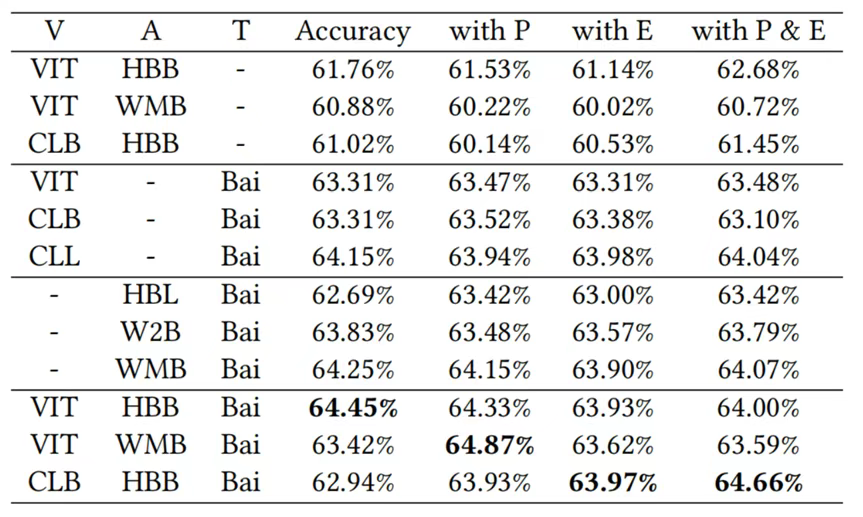
实验结果:单峰欺诈检测结果表明,文本模态明显优于视觉和音频模态。这表明,我们数据集中的文本线索提供了更突出的欺诈性指标。随后的多模态融合实验表明,整合互补模态可以持续提高性能。这一改进与欺诈行为在多个渠道中表现的前提相一致,使模型能够更好地理解视频内容并更准确地检测欺诈行为。值得注意的是,虽然大多数单峰特征都受益于融合,但结合视觉和声学特征产生的增益或性能下降可以忽略不计。这意味着文本特征稳定了模型性能,这一发现与人类的欺诈判断一致,其中基于内容的(文本)线索通常主导视觉或音频信号。有必要进一步探索视觉和听觉模态中的欺诈性指标。
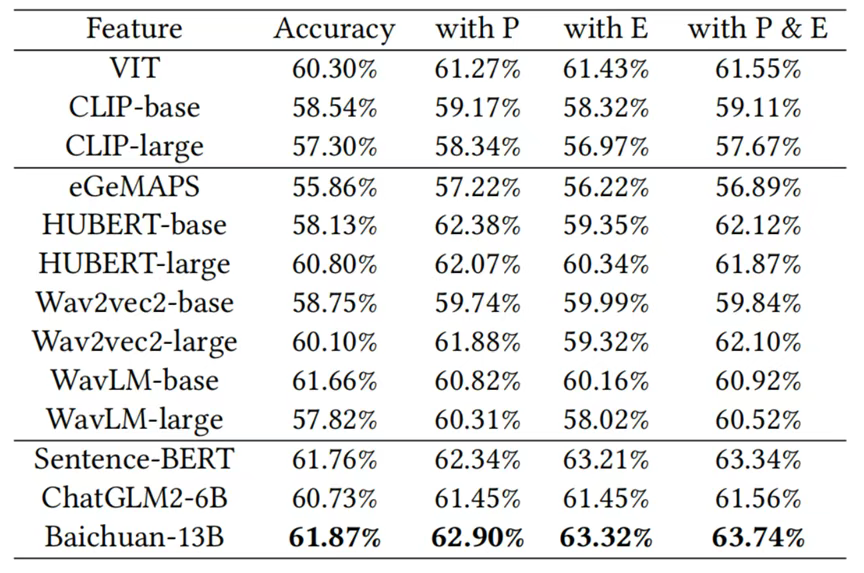
结合个性特征可以持续提高欺诈检测性能,强调了它们对任务的重要性。虽然情绪特征也能提高表现,但它们的贡献不如性格特征明显,有时甚至是有害的。这种差异可能是因为人格特征是直接特征,而情绪特征取决于上游情绪识别模型的质量。未来的工作应该探索更有效的方法来利用情感表达特征。结合人格和情感特征可以实现最高的单峰欺诈检测性能,确认了它们的相关性,并证明了基于个体差异的建模的可行性。
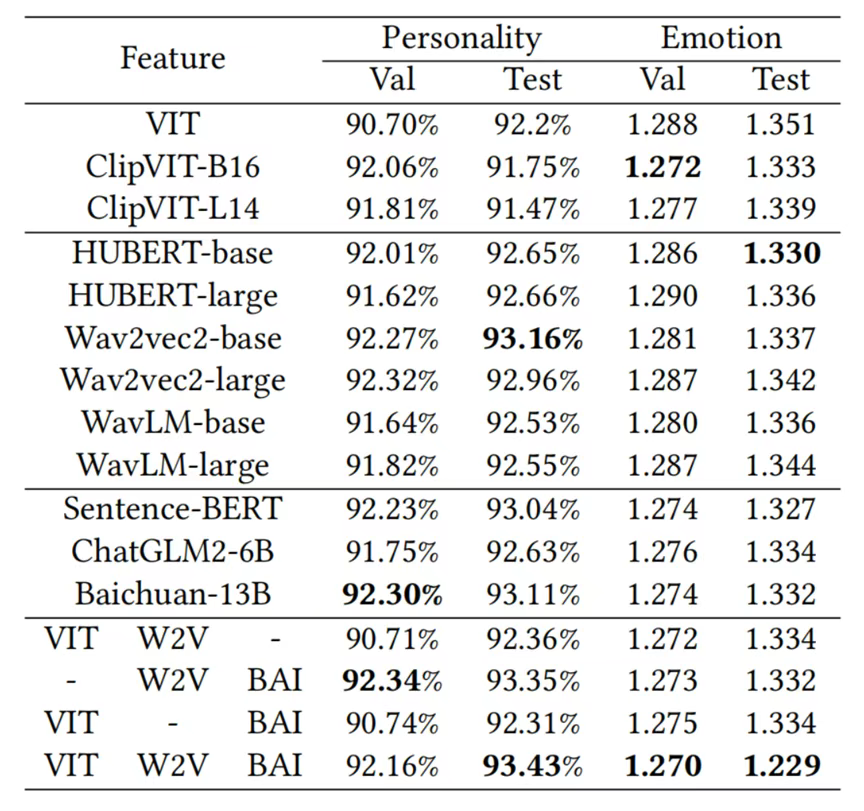
对于人格识别(表3),声学特征单独超过视觉/文本特征,突出了声音线索的预测价值。全多模态融合实现了最优性能,表明了跨模态互补性。在情感识别中,文本特征提供了最强的线索,多模态集成明显优于单峰方法,强调了跨模态融合对稳健情感理解的必要性。
结 论
我们介绍了多模态欺诈检测数据集(MDPE),包括视频、音频和文本模态,并辅以个性和情感注释。MDPE有助于研究人格特质和情绪状态对欺诈行为的影响。除了欺诈检测应用外,该数据集还支持人格和情绪识别等辅助任务,以及对人格-情感-欺诈相互作用的联合分析。提供基准实验以确保可复现性,并为未来的工作奠定基础。通过公开发布MDPE,我们的目标是促进情感计算这一关键领域的进展。
