
 语音小管家
本次分享由内蒙古大学刘瑞教授与美国约翰霍普金斯大学Berrak Sisman、美国卡耐基梅隆大学Carlos Busso、香港中文大学(深圳)李海洲教授合作发表于Interspeech 2025的语音编辑情感校正工作《Towards Emotionally Consistent Text-Based Speech Editing: Introducing EmoCorrector and The ECD-TSE Dataset》。
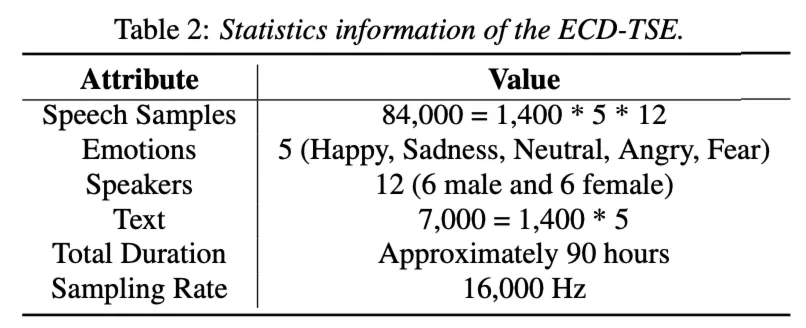
1️⃣该工作构建了首个面向语音编辑情感校正的数据集ECD-TSE,包含90个小时的音频。
2️⃣ 提出了基于检索增强生成(Retrieval-Augmented Generation, RAG)的语音编辑情感校正方案EmoCorrector。通过对比实验、消融实验,我们验证了所提出的EmoCorrector方法在ECD-TSE数据集上的有效性。
欢迎关注项目相关网址:
📍EmoCorrectorPaper:https://arxiv.org/abs/2505.20341
📍EmoCorrectorGitHub:https://github.com/AI-S2-Lab/EmoCorrector
📍ECD-TSEDataset(Huggingface):https://huggingface.co/datasets/Gaphy/ECD-TSE
0、Abstract
基于文本的语音编辑(Text-based Speech Editing, TSE)仅通过文本即可修改语音,从而无需重新录制。然而,现有的TSE方法主要关注合成语音片段的内容准确性和声学一致性,往往忽视了由于文本变化所引发的情感变化或不一致问题。为了解决这一问题,我们提出了EmoCorrector,一种用于TSE的全新后处理方案。EmoCorrector利用检索增强生成(Retrieval-Augmented Generation, RAG)机制,提取编辑后文本的情感特征,检索具有匹配情感的语音样本,并合成符合目标情感的语音,同时保持说话人的身份和音质。
为了支持TSE中情感一致性建模的训练与评估,我们首创了用于基准测试的情感校正数据集——ECD-TSE(Emotion Correction Dataset for TSE)。ECD-TSE的显著特点是包含了丰富的<文本,语音>配对数据,这些数据呈现了多样化的文本变体和情感表达。基于ECD-TSE的主观和客观实验以及全面分析表明,EmoCorrector在表达预期情感方面有显著提升,并有效缓解了现有TSE方法中的情感不一致问题。
代码和音频示例可在以下地址获取:
1、Introduction
基于文本的语音编辑(TSE)是通过编辑其底层文本而非直接修改音频信号来对语音进行调整的方法。随着数字媒体的兴起,TSE在社交媒体内容创作、游戏配音和电影配音等应用中变得越来越重要,因为它可以修正如发音错误、遗漏或口吃等问题,而无需重新录制整段音频[1]。
近年来,文本到语音(TTS)技术的进步促进了神经网络模型在TSE中的发展[1, 2, 3, 4, 5]。然而,尽管这些技术取得了一定进展,大多数TSE方法依然专注于内容修改和声学质量,却往往忽略了情感一致性的问题[6]。如图1所示,尽管编辑文本与原始文本之间仅有一个词的差别,但整句的情感表达却截然不同。虽然传统TSE模型可以成功合成词语“bad”的语音片段,但它并未表达出编辑文本应有的情感。因此,此时需要对整句的情感状态进行进一步校正,以实现情感一致性。
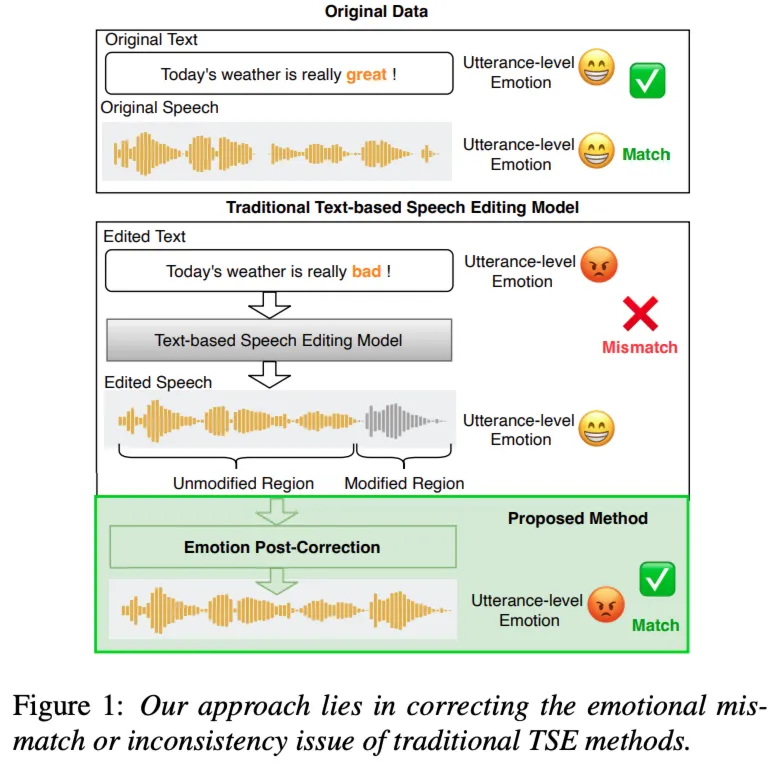
一种自然的想法是使用情感语音转换(Emotional Voice Conversion, EVC)模型[7, 8],将整句的情感状态转变为与编辑文本一致的情感,同时保持说话人身份不变。但直接使用EVC模型存在多个问题:
- 在应用EVC之前,必须识别编辑文本中所包含的情感状态,而这一过程可能引入错误;
- 即使情感识别准确,使用离散的情感标签作为EVC模型的输入,可能无法捕捉到丰富且细腻的情感信息,从而限制模型性能;
- EVC模型的输出本质上是不可控的,因此难以评估其转换结果是否达到了最佳效果。
因此,单纯依赖EVC模型进行后期校正并不能完全满足我们的需求。为了解决上述问题,我们提出了一种端到端的情感不一致校正方法,命名为EmoCorrector。该方法受启发于检索增强生成(Retrieval-Augmented Generation, RAG)[9]。具体地:
- 首先,从编辑文本中提取情感嵌入;
- 然后,从跨模态检索数据库中检索出具有相似情感嵌入的语音样本;
- 接着,利用这些样本的情感嵌入作为参考,同时保留原始编辑语音中的说话人特征以保持身份一致;
- 最后,进行TTS合成,从而实现原始语音的情感调整,达到情感一致性的表达。
为了构建跨模态检索数据库的特征,我们采用了聚焦情感特征的对比学习(contrastive learning)策略,执行语言-音频的情感对比学习,使情感特征在不同模态之间对齐。
此外,为了支持情感后校正的训练和评估,我们构建了一个新的数据集:ECD-TSE(Emotion Correction Dataset for TSE)。该数据集包含原始文本及其反映不同情感状态的编辑文本。我们使用了三种先进的TTS模型为所有文本合成情感语音。这个富含情感的语音数据库不仅包括文本编辑信息,也为情感一致性建模提供了坚实基础。
在ECD-TSE上进行的大量实验表明,EmoCorrector在保持自然语音质量的同时,显著提升了情感对齐能力。
本文的主要贡献总结如下:
- 提出了一种完整的端到端情感后校正方案——EmoCorrector;
- 该方案结合了RAG技术,设计了跨模态情感对比学习和说话人-情感解耦策略;
- 构建了首个面向TSE的情感校正数据集——ECD-TSE,推进了该领域的情感一致性建模与评估研究。
2、Dataset: ECD-TSE
为了实现TSE(基于文本的语音编辑)的情感一致性建模,我们需要一个数据库,其中的句子在表达相似词汇信息的同时,通过少量修改可以引发不同的情感。然而,现有的一些主流数据库(如ESD数据集[13]、MSP-PODCAST [14]和IEMOCAP [15])并不适用于该任务,因为它们通常是一段固定文本对应多种情感的语音。
为此,我们通过两个关键步骤开发了ECD-TSE语料库:文本变体生成和情感语音生成。
文本变体生成(Text Variant Generation):
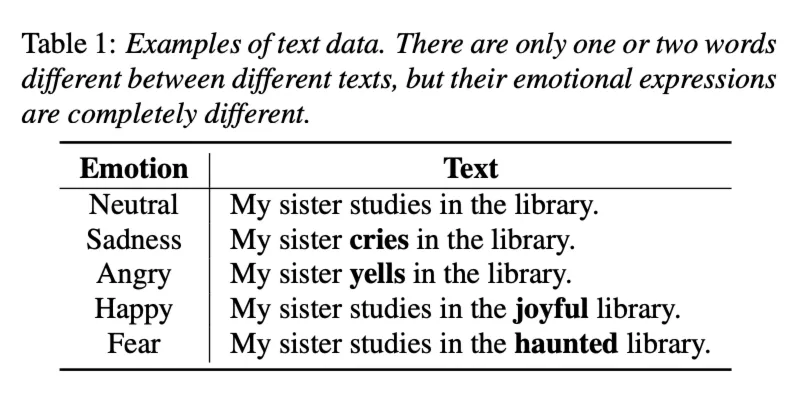
文本变体生成的过程是:首先生成带有中性情感的文本,然后对其进行一到两个词的修改,以生成表达不同情感的文本变体。
首先,我们使用ChatGPT-4来生成具有中性情感的文本。我们使用的提示词如下:
“Please help me to build a text dataset, with each sentence consisting of 4-10 words, and in English. Please write 10 sentences, and ensure the text contains words that express neutral emotions."
接着,我们让ChatGPT-4对这些中性句子进行一到两个词的修改,以引入特定的情感(如悲伤)。我们为此使用的提示词如下(以“悲伤”为例):
“Now, I will give you a sentence. Please modify only one or two words to change the emotion to sadness. Please output only one modified sentence.”
如表1所示,通过这种方式,我们获得了对应四种额外情感状态的文本,每种情感的句子与中性文本之间仅有一到两个词的差异。
情感语音生成(Emotional Speech Generation):
在情感语音生成过程中,我们使用了三种先进的表达性TTS系统作为合成器,分别是:Microsoft Azure[16]、CosyVoice2[17]和F5-TTS[18]。
对于Microsoft Azure,在为每个文本句子合成语音时,我们在引擎中直接设定对应的情感标签,随机设定说话人身份,从而合成出与该情感相匹配的高表达度语音。
对于CosyVoice2和F5-TTS,它们在进行情感语音合成时需要参考语音。因此,我们根据待合成文本的情感标签,从第三方情感语音数据集中随机选择情感标签匹配的语音样本作为参考。需要注意的是,合成语音的说话人身份与参考语音保持一致。
我们使用的第三方情感语音数据集包括ESD[13]和MEAD[19],它们为不同的说话人提供了多样的情感语音样本。
最终:
Azure系统为5位说话人合成语音,
CosyVoice2为另外5位说话人合成语音,
F5-TTS为另外2位说话人合成语音。
详细的统计信息见表2。
3、Methodology: EmoCorrector
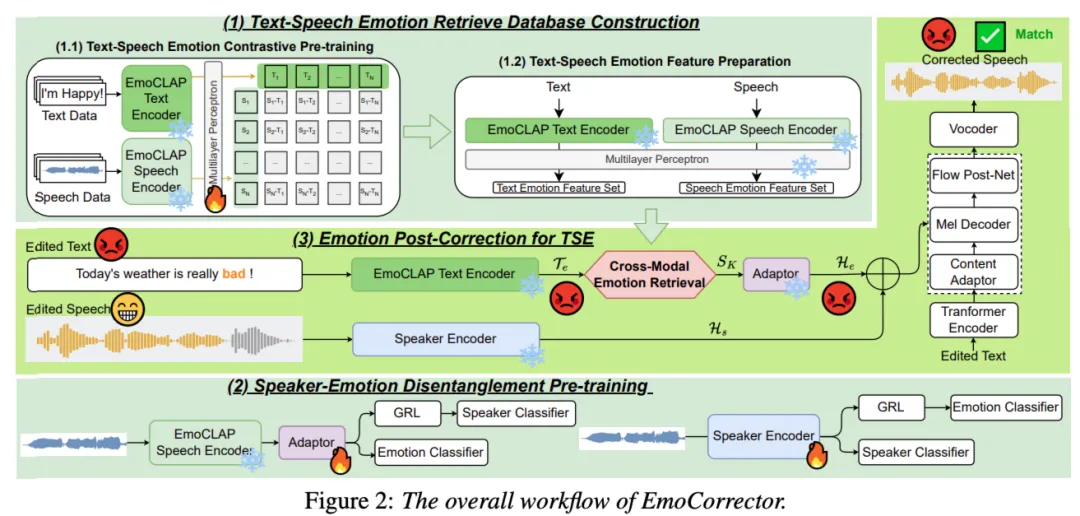
我们提出的EmoCorrector框架通过以下三个阶段实现TSE(基于文本的语音编辑)中的情感一致性,同时保持说话人身份:
1.文本-语音情感检索数据库构建(图2中的Block 1)
2.说话人-情感特征解耦预训练(图2中的Block 2)
3.TSE的情感后校正(图2中的Block 3)
其中,前两个模块需要进行预训练,第三个模块则以端到端方式进行训练。
3.1、Text-Speech Emotion Retrieve Database Construction
文本-语音情感对比预训练:
我们提出了情感对比语言-音频预训练(EmoCLAP),灵感来自CLAP [20],旨在学习一个共享的文本-语音情感表示语义空间。如图2中Block 1.1所示:
文本编码器(基于预训练的RoBERTa [21])提取文本情感特征T;
语音编码器(基于emotion2vec [22])提取语音情感特征S;
二者通过一个多层感知机(MLP)投射到共同嵌入空间中:
Ms = MLP(S),Mt = MLP(T)
为了增强文本-语音的对齐,我们使用对比学习,最大化正样本对的相似度,最小化负样本对的相似度。点积相似度矩阵B的计算公式为:
B = μ(Ms · Mtᵀ),其中μ是缩放因子
对应的对比损失函数为:
L_clap = -log(P_exp(B) / Σ_exp(B))
文本-语音情感特征准备:
对比预训练完成后,我们将冻结EmoCLAP的文本与语音编码器,用于从文本和语音中提取固定的情感嵌入(见图2 Block 1.2)。这些嵌入将组成检索数据库,支持文本与语音之间的跨模态情感检索,以及合成过程中使用的情感表示。
3.2、Speaker-Emotion Disentanglement Pre-training
为将情感表达从说话人身份中解耦,以服务于后续的情感校正,我们使用基于梯度反转层(GRL)的对抗训练机制(见图2 Block 2)。EmoCLAP的语音编码器提取情感表示He,然后通过softmax分类器Ce分类为五种情感状态:P_He = Ce(He),对应交叉熵损失为L_e = CE(P_He, emotion_id)。由于He可能也包含说话人信息,我们将其通过GRL层传入说话人分类器Cs,得到:
P_sHe = Cs(GRL(He))
对应的对抗损失为 :
L_s(e) = CE(P_sHe, speaker_id)
这样可确保He保留的仅为情感信息,而去除说话人相关属性。
同时说话人编码器提取说话人表示Hs,用于说话人分类,损失为L_s。为避免Hs捕获情感信息,同样将其通过GRL输入情感分类器,得到对抗损失L_e(s)。
最终的整体损失函数为:
L = L_s + L_e + L_s(e) + L_e(s)
3.3、Emotion Post-Correction for TSE
如图2中的Block 3所示,情感后校正的目标是对编辑语音中的情感不一致进行调整,使其与编辑后的文本表达的情感一致。
给定一个编辑后的文本Xt,EmoCLAP文本编码器提取文本情感嵌入Te。使用该嵌入作为查询向量,在跨模态情感检索模块中进行余弦相似度检索,找出最相似的Top-K个语音情感嵌入:
SK = {Ei1, Ei2, ..., EiK}
然后对SK进行平均聚合,并通过预训练的Adaptor(来自Block 2)处理,生成更精炼的语音情感嵌入He。
与此同时,编辑后的语音Xs被说话人编码器处理,得到说话人嵌入Hs。将He和Hs相加,形成联合嵌入,并输入到Content Adaptor、Mel解码器 和Flow Post-Net中,以将情感特征整合进合成语音中,最后通过Vocoder合成最终的音频波形。关于TTS合成器的更多细节参考文献[23],Block 3的损失函数也与[23]保持一致。
4、Experiments and Results
4.1、Experimental Setup
我们在ECD-TSE数据集上评估EmoCorrector的性能。我们使用Montreal Forced Aligner (MFA)[24]进行精确的强制对齐。数据集被随机划分为训练集、验证集和测试集,比例为98%、1%、1%。
EmoCLAP文本编码器提取维度为768的情感嵌入;
语音编码器提取语句级的1024维情感嵌入;
两者通过可学习的投影矩阵映射到一个多模态空间,输出维度统一为1024。
说话人编码器的配置参考自GST[25]的参考编码器,由卷积堆叠和GRU模块组成。每个卷积层使用3×3的卷积核和2×2的步长,后接BatchNorm和ReLU激活函数。六个卷积层的输出通道数分别为:32、32、64、64、128和128。
所有分类器均由一个全连接层(Linear)和Softmax层组成,使用交叉熵损失进行训练。
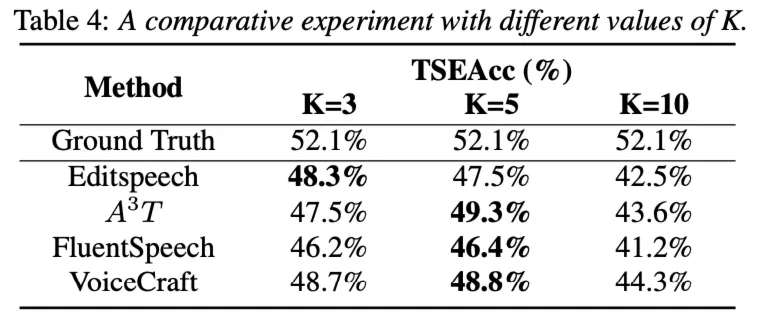
我们使用预训练的HiFi-GAN[26]作为声码器以合成最终语音波形。优化器采用Adam,学习率设为1×10⁻⁷。Top-K设置为5。
我们训练EmoCLAP 20万步(μ设为10步),接着训练说话人-情感解耦模型30万步,所有训练均在一张A800 GPU上完成。
4.2、Evaluation Metrics
主观指标:
文本-语音情感匹配主观评分(TSE-MOS):由听众判断语音情感是否与文本所表达的情感一致。
客观指标:
1.文本-语音情感匹配准确率(TSEAcc):这是一个新的由大语言模型辅助的指标。我们使用先进的语音理解模型Qwen2-Audio[27]识别语音中的情感,再与文本中的情感标签进行比对以计算准确率。由于Qwen2的输出特性,我们按分组计算准确率后再取平均。
2.情感余弦相似度(ECS):使用emotion2vec [22]提取情感特征,并与真实语音的情感特征进行余弦相似度计算,范围为[-1, 1],值越大表示越相似。
4.3、Baselines
我们将情感校正前后的语音与四个先进的TSE模型进行比较:
1.EditSpeech[28]:通过上下文生成文本,保持自然性与质量;
2.A³T[2]:引入对齐感知的声学-文本预训练,同时输入音素和部分遮蔽的频谱图;
3.FluentSpeech[1]:以扩散模型为主干,结合上下文语音预测遮蔽特征;
4.VoiceCraft[5]:使用回归型Transformer解码器以生成神经编解码器token;
我们也将结果与Ground Truth语音进行对比。
4.4、Main Results
所有的预训练均已训练至收敛状态。内部实验表明,若不进行预训练,情感校正无法获得满意的效果。由于篇幅限制,未展示该部分结果。本节主要实验校正效果,并汇报如下:
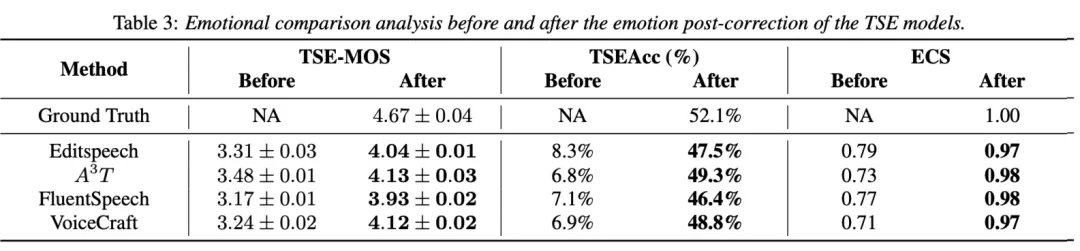
在TSE-MOS评估中,25位听众对50条语音样本的文本-语音情感一致性进行打分。如表3所示,EmoCorrector显著提升了情感表达,平均得分提高了0.73分。对EditSpeech、A³T、FluentSpeech和VoiceCraft的情感校正分别提升了0.73、0.65、0.76和0.88分。在TSEAcc评估中,EmoCorrector也显著提升了文本与语音情感的匹配准确率,平均从7.2%提升至48%。在ECS评估中,EmoCorrector使校正后语音的情感特征更接近真实情感。各模型校正后提升的ECS如下:
EditSpeech:提升0.18
A³T:提升0.25
FluentSpeech:提升0.21a
VoiceCraft:提升0.26
这些结果表明EmoCorrector有效解决了编辑语音与文本间的情感不一致问题。
4.5、Further Analysis
参数K的分析:
在跨模态情感检索中,Top-K样本的数量可能影响最终情感表达效果。我们设置K = {3, 5, 10}进行分析(因为K=1信息不足,K=5~10变化不明显)。其余配置保持不变。表4显示,K=5的TSEAcc最佳;K=3和K=10表现较差,K=10最差,可能是由于检索样本过多造成的信息冗余。
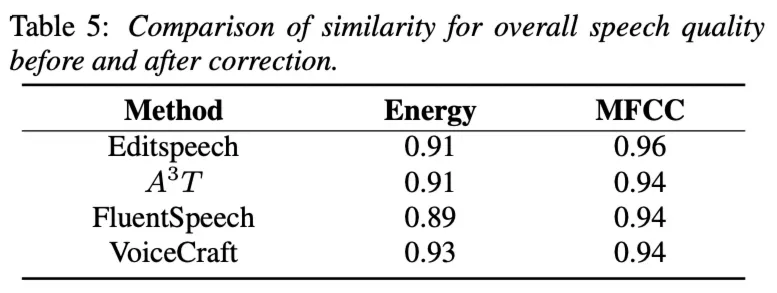
整体语音质量的影响分析:虽然我们聚焦情感校正,但并不以牺牲语音质量为代价。为验证这一点,我们随机选取了50条测试样本,分别提取校正前后的能量特征(Energy)和MFCC特征,计算其余弦相似度。表5显示,相似度均接近1,说明情感校正并未损害语音质量。
和情感语音转换效果的比较实验:
为验证EmoCorrector是否优于直接使用情感语音转换(EVC)方法,我们随机选择了50条测试样本,并采用两种先进的EVC模型(Cycle-GAN[29]和VAW-GAN[30])进行情感转换。我们将EVC转换后的样本与EmoCorrector校正后的样本在TSEAcc上进行对比,结果见表6(更多结果展示于演示网站)。
结果表明,EmoCorrector的后处理方法比EVC更能合成准确的情感语音,在情感呈现方面具有明显优势。
5、Conclusion
本论文提出了一种新颖的用于基于文本的语音编辑(TSE)任务的情感后校正方案,引入了新的基准数据集ECD-TSE,以及三阶段流程的EmoCorrector框架,包括:1.文本-语音情感检索数据库构建,2.说话人-情感特征解耦预训练,3.TSE的情感后校正。实验结果表明,该框架能够显著提升编辑语音中的情感一致性。据我们所知,EmoCorrector和ECD-TSE是首个专门面向该任务设计的方法与数据集。我们希望这项工作能为未来TSE中情感校正研究奠定基础。
