
 语音小管家
本文由清华大学与香港中文大学、腾讯AI Lab合作,提出了基于大语言模型(LLM)的通用目标音频分离方法:UniSep,实现了对任意混合音频的目标分离。与以往只针对单一领域或单一源的分离工作不同,UniSep支持任意类型音频的目标分离。通过将音频分离任务建模为离散token的序列映射建模问题,结合大规模音频数据和语言模型的建模能力,显著提升了分离复杂混合音频的能力。实验表明,在语音、音乐和环境音等多任务下,UniSep都实现了较好的分离性能。
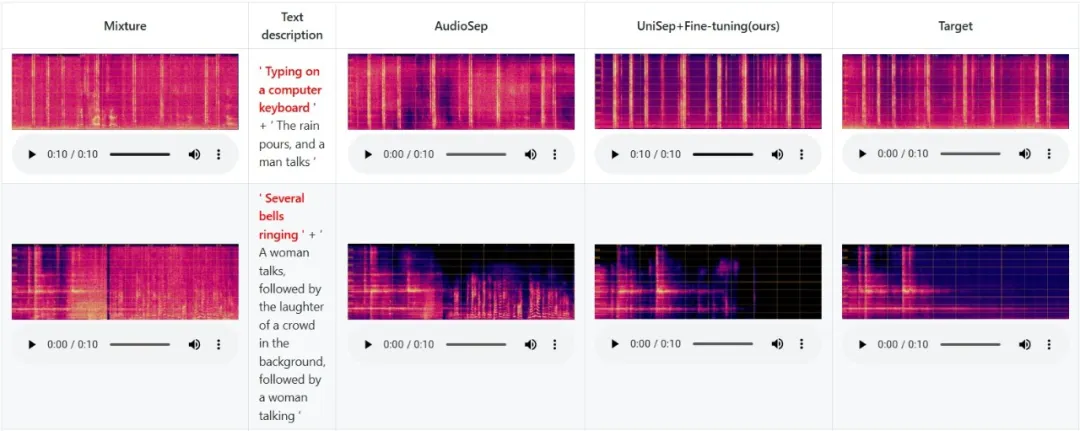
所提方法支持文本描述(上图)及音频提示的通用目标音频(语音、音乐、环境音等)提取,扫描下方二维码获取更多结果展示。
研究背景与动机
实际生活环境中的音频信号往往是由多种来源混合形成的。如何从混合音频中有效分离出目标源(即音频源分离),不仅直接关系到语音识别、语音合成、音乐信息检索、环境声音分析等下游任务的性能,也是多模态人工智能发展的基础能力之一。近年来,音频源分离技术在各种分离任务中表现出色。但这些方法通常需要为每一种音频类型、每一种分离任务单独设计网络结构和标注数据集,缺乏统一性和通用性,难以扩展到现实世界中音频种类和数量均不可预知的复杂场景。
最近,通用音频分离(Universal Source Separation, USS)成为研究前沿热点,其目标是训练出一个能够分离任意类型和数量的音频统一模型,无需区分具体任务(如语音、音乐、环境音等)。但目前大部分研究通常仅“针对环境声音的通用分离”任务,难以支持真实世界中复杂多变的多种音频类型的混合场景。此外,大规模混合音频与对应目标源的标注极其耗费人力,有标注数据集的规模也会限制模型泛化能力的提升。因此,面对真实世界中音频种类多样、数量不定的需求,如何构建一个能支持语音、音乐、环境音等不同类型的通用音频分离系统,是当前音频分离领域仍待解决的问题。
主要挑战与贡献
通用音频分离USS主要面临以下三个挑战:(1)统一建模复杂音频信号:不同类型的音频(如语音、音乐、环境音)在频率、时序等方面差异较大,如何在一个统一空间中建模所有类型音频?(2)通用分离模型的有效性:是否可以设计出性能不逊于各类特定任务模型的通用目标分离系统?(3)大规模数据对分离性能的提升:如何有效利用大规模未标注音频数据和有限标注数据进行高效训练,提升模型泛化能力?
对于第一个挑战,我们使用离散token建模的方式:不用频谱图或波形图来对音频数据进行建模,而是用多种音频类型训练的音频编解码器模型将原始音频信号转换为离散token序列,并在离散的潜在空间中对音频数据进行建模。通过使用具有大规模参数的语言模型,我们将传统的音频分离问题转化为序列到序列的建模问题,从而简化了音频分离模型的流程。
对于第二个挑战,UniSep采用多层全局与局部Transformer结合的架构,通过不同层级建模能力有效捕捉不同类型音频的全局模式与细节变化,支持多任务联合训练。与单任务模型相比,UniSep取得了颇具竞争力的主观和客观评估结果。
对于第三个挑战,我们提出了利用无标注大规模音频数据的预训练任务,将大量无标注音频数据纳入模型训练,极大降低了对人工标注混合音频的依赖,减少了模拟混合数据的构建成本,提升了模型对音频内部结构一致性和相关性的理解能力。在此基础上,我们在36k小时的多类型音频数据集(语音、音乐、环境音)上训练,验证了模型的通用分离能力。最终训练好的模型还能作为基座模型进行下游任务的微调:在新任务上通过少量数据的微调能快速适配新的分离场景(如基于文本查询的音频分离等)。
研究方案
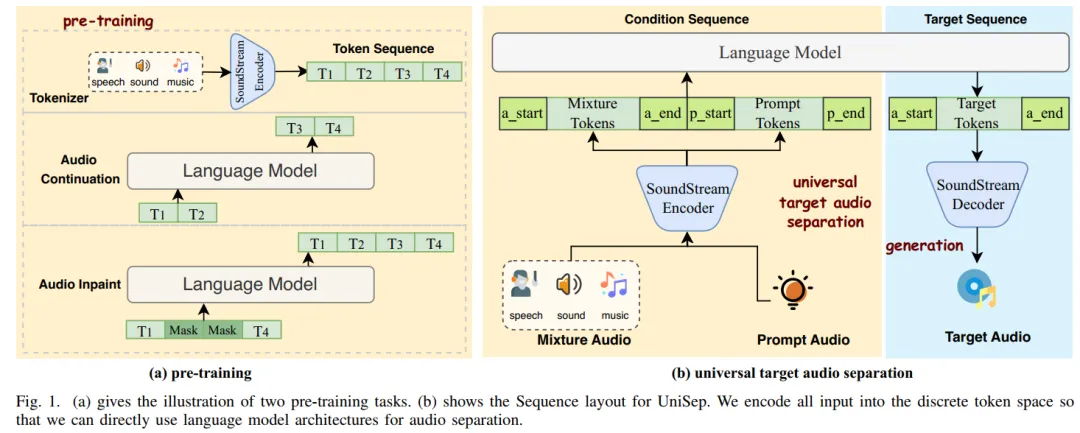
音频离散化
为实现对不同类型音频(语音、音乐、环境音)的统一建模,UniSep首先将原始音频信号通过预训练神经网络音频编解码器(如SoundStream)编码为离散token序列。该token序列可以直接输入到语言模型,摆脱了以往对波形或频谱等连续表示的依赖。
假设一个持续时间为d秒、采样率为fs的音频信号用x∈[−1,1]d×fs表示,音频codec模型包含编码器E、解码器D、量化器Q:
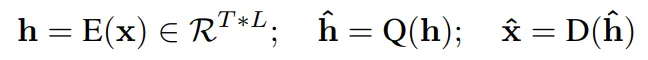
其中,T为下采样后音频帧数,L为每帧的特征维度。每个编码器输出帧h经过残差向量量化(RVQ)得到离散token序列z。为便于输入到Transformer语言模型,采用flatten操作将所有token拼接成一维token序列。这种token化方案使得语音、音乐、环境音等多种类型的音频数据均可被转化为结构统一的离散token流,实现了跨域统一建模的基础。
用于目标音频分离的语言模型
得到离散音频token后,UniSep采用自回归的解码器式语言模型(如多层Transformer)来执行目标音频分离任务,将音频分离任务形式化为条件序列生成问题,即给定混合音频与查询音频的token序列,预测目标音频的token序列。与传统分离方法常用的“嵌入特征来指导分离”不同,UniSep直接用查询音频token+混合音频token+目标音频token三者的拼接序列作为输入,构建“序列到序列”建模框架。
语言模型的序列建模框架,常见有两种建模方式:
1)Prefix-LM建模(前缀语言建模)
以查询token和混合token为条件,自回归地预测每一步目标音频token:
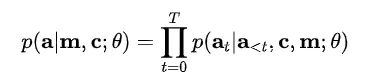
其中,a为目标音频token,m为混合音频token,c为查询音频token,θ为模型参数,T为目标token长度。
2)Causal-LM建模(因果语言建模)
将三者拼接成一个序列,训练时建模全序列的token依赖:
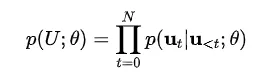
其中,U=[m,c,a]为拼接后的完整输入序列,N为总token数。推理时,将混合token和查询token作为条件,自回归生成目标token。
考虑到Causal-LM训练更难但泛化能力更强、能建模条件token间的复杂关系,实验显示Causal-LM效果优于Prefix-LM,因此本文采用Causal-LM建模。
此外,为帮助模型区分不同序列片段,我们还引入特殊token进行分割,如[a_start]、[a_end]分别标记混合和目标音频序列,[p_start]、[p_end]分别标记查询音频序列。这些token有助于模型精准理解输入结构。
预训练策略
为了突破标注混合数据稀缺瓶颈,并让模型更好理解音频token的内部规律,UniSep设计了无监督预训练任务,利用大规模原始音频数据实现更高效的知识迁移和特征抽取。具体包括:
1)Audio Continuation(音频续写)
让模型在已知部分音频token的情况下预测序列后续内容,提升模型生成连贯音频token的能力。形式上,输入一个音频的前半段token序列,目标是预测后半段所有token。
2)Audio Inpaint(音频补全)
随机mask原始token序列的若干片段(如20%的token),让模型在已知上下文条件下恢复被mask部分,增强模型对局部相关性和全局一致性的理解:
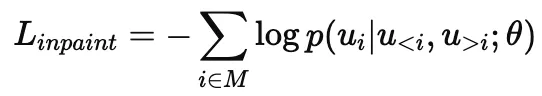
其中,M为被mask的token位置,ui为第i个token。
实验验证
数据集
UniSep在多种公开大规模音频数据集上进行训练和评测,涵盖了语音、环境音和音乐等多领域数据,总时长达36k小时。主要使用的数据集如下:
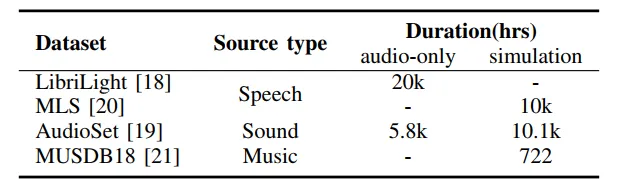
评测指标
PESQ(Perceptual Evaluation of Speech Quality):用于语音质量的客观评测。
DNSMOS(Deep Noise Suppression Mean Opinion Score):基于深度学习的非侵入式听感打分。
ViSQOL(Virtual Speech Quality Objective Listener):客观衡量音频与参考信号的感知相似性,分数区间1-5。
STFT Distance:对比参考音频与分离音频在频谱上的距离,数值越低越好。
MUSHRA(Multiple Stimuli with Hidden Reference and Anchor):主观听感打分,范围1-5分,由20名受试者对50条音频评测。
目标语音分离/提取实验
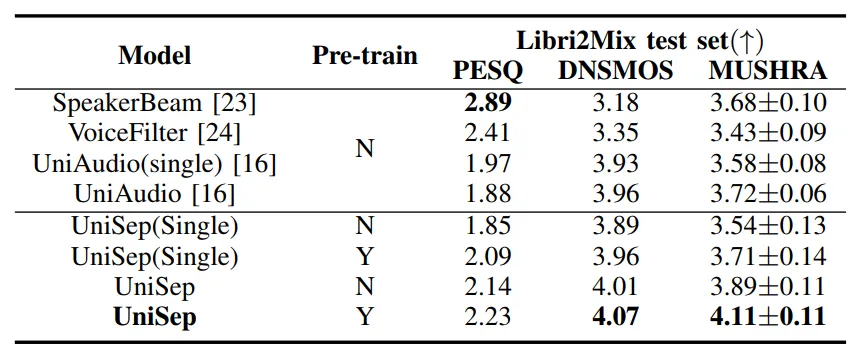
在目标语音分离任务上,UniSep使用Libri2Mix测试集进行评测。结果如上表所示。实验结果表明,UniSep的统一模型在客观(如DNSMOS)和主观(如MUSHRA)指标上均超过了单任务模型(Single),且优于现有的主流方法。其中,预训练策略能进一步提升模型性能,尤其是在DNSMOS和MUSHRA等主观感知指标上,表现尤为突出。此外,实验中还观察到,PESQ等指标对基于采样的生成模型(如自回归生成)不太敏感,这与以往工作的发现一致:即这类指标较为依赖参考音频与生成音频的严格对齐,而采样生成往往有时序漂移。不过,无论在信号质量还是听感打分上,UniSep都展现了较好的目标语音分离能力。
环境音分离实验
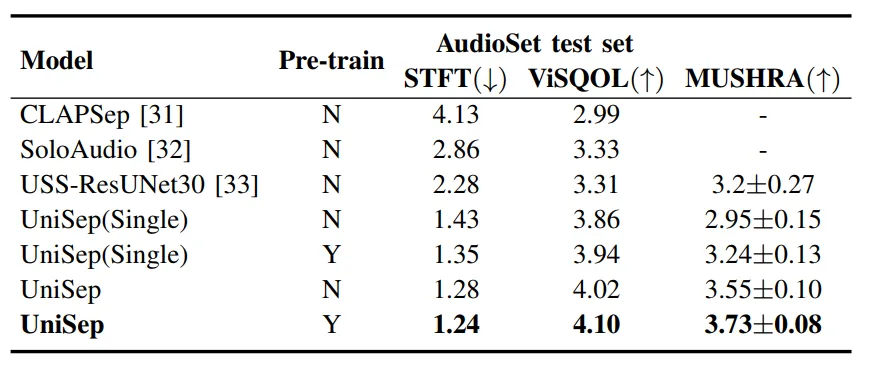
在环境声音分离方面,UniSep同样展现了极强的适应性和泛化能力。实验基于AudioSet数据集,涵盖了语音、音乐、环境音等多种音频类型。评测结果显示,UniSep(无论是否采用预训练)在ViSQOL和MUSHRA等主客观指标上,均超越目前的一些主流方法,且在STFT距离等客观度量上同样表现优越。
值得注意的是,AudioSet包含了丰富且复杂的混合场景,训练与推理阶段往往包含语音、音乐和环境音的任意组合。UniSep模型在面对如此多样化的混合类型时,依然能保持稳定和优秀的分离效果,验证了其“通用分离模型”架构的实际效用。同时,采用大规模音频数据进行预训练,显著提升了模型对不同类型音源之间关系的理解和分离能力。这些结果充分体现了UniSep在多类型、多任务音频分离领域的强大泛化和跨域能力。
目标音乐分离实验
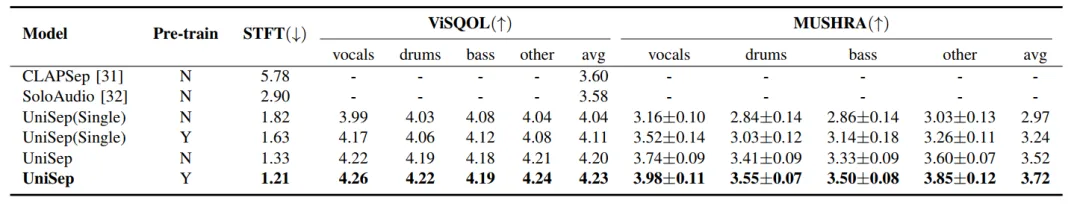
在音乐分离任务中,UniSep在MUSDB18数据集上评测了对人声、鼓、贝斯、其他等多目标源的分离性能。实验表明,UniSep无论在主观(MUSHRA)还是客观(ViSQOL、STFT距离)指标上都表现出色,并且在不同分离目标之间能够保持均衡性能。不同特征的音乐源(如人声和鼓声等)在UniSep统一token空间下均能被建模与分离,进一步证明了基于大语言模型的音频token序列建模对于复杂混合场景的广泛适应性和鲁棒性。
作为基座模型的能力分析
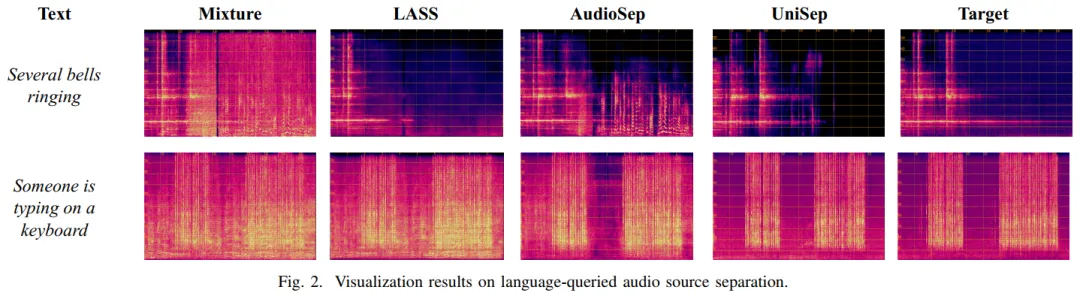
UniSep不仅可以胜任传统的音频分离任务,还支持迁移到下游任务,如文本查询音频分离(language-queried audio source separation)。通过极少量的AudioCaps文本-音频对(约16.7小时)微调,UniSep即可实现“按文本内容查询分离目标音频”这一多模态任务。
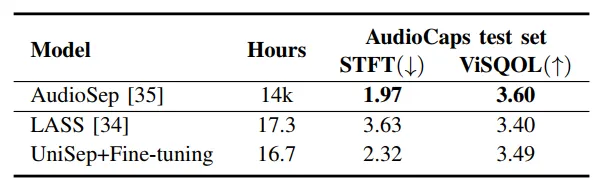
实验显示,尽管微调数据量远少于AudioSep(仅用0.12%的数据),UniSep依然能取得后者约97%的ViSQOL性能,并且在STFT等指标上也明显优于LASS等方法。这说明UniSep作为通用基础模型,具备极强的低资源迁移能力和下游任务适应性,在多模态场景下也能充分发挥大模型的泛化优势。
结 论
UniSep首次使用语言模型的方法进行通用目标音频分离,实现了对任意类型和数量音源的统一分离。将音频信号通过神经网络音频编解码器映射到离散token空间,并采用自回归语言模型对其进行序列到序列的统一建模,从而极大提升了分离建模的灵活性和通用性。通过引入离散token建模和大规模无标注音频预训练,模型不仅在语音、环境音和音乐分离上均表现优异,同时展现出作为音频基础模型的巨大潜力。
