
 语音小管家
为什么做?
语言模型的强大能力
基于语言模型的语音增强
激发语言模型在增强上的泛化能力
怎么做?
LLaMA为基础的极简架构
WavLM 编码器:负责从带噪语音中提取连续语音特征 基于 LLaMA 的语言模型:以连续语音特征作为输入,预测目标语音的Token X-codec2 解码器:根据预测的Token重建出增强后的语音信号
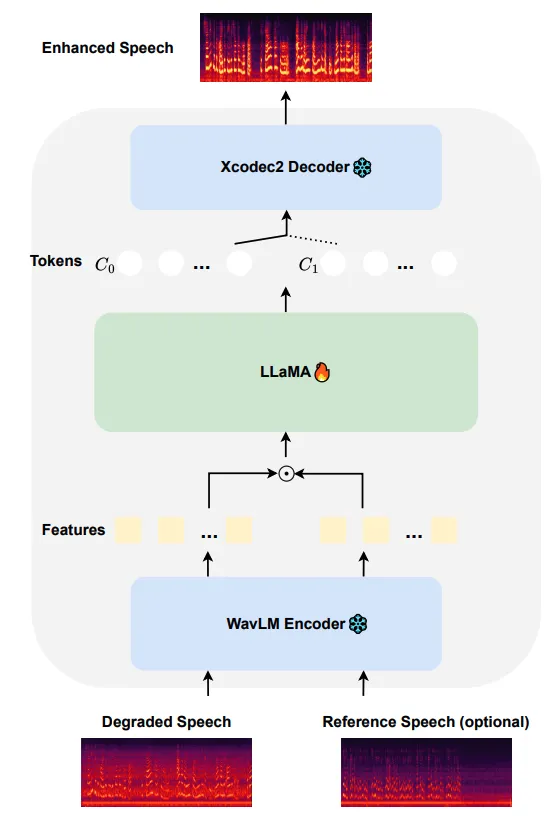
图1 LLaSE-G1 结构图
多增强任务统一
LLaSE-G1 的损失函数设计针对不同语音增强任务进行了精细化优化:在NS、PLC和AEC任务中,采用单监督学习策略,通过交叉熵损失函数直接约束模型预测结果与目标语音之间的匹配度;在 TSE 任务中,分别对干扰说话人和目标说话人进行独立建模和优化,以实现更精确的说话人分离效果;此外,我们将 SS 任务作为模型训练过程中未见过的测试场景,用以全面验证模型在零样本学习条件下的泛化能力和鲁棒性。
效果如何?
我们采用动态生成数据对模型进行训练,其中包含约5000小时的纯净语音数据,包括中文,英文,德语,西班牙语,法语等语言,噪声数据包括1000小时,覆盖街道、办公室、车站等各种场景。在测试集的选择上,我们主要采用微软公司主办的语音增强系列竞赛的官方测试集作为benchmark。具体而言,针对不同的语音处理任务,我们分别选取了最具代表性的测试集:对于NS任务,采用DNS Challenge 2020竞赛测试集;对于PLC任务,使用PLC Challenge 2022竞赛测试集;对于TSE任务,选用DNS Challenge 2023竞赛测试集;对于AEC任务,采用AEC Challenge 2023竞赛测试集;对于SS任务,则同时使用Libri2Mix和WSJ0-2mix两个广泛使用的测试集进行综合评估。在测试指标上,也采取与竞赛对齐的指标,包括微软提供的DNSMOS,PLCMOS,AECMOS等工具。同时通过基于SSL模型的SpeechBERTScore和Cosine Similarity来评估处理音频的语义和音色相似度。
SOTA的表现
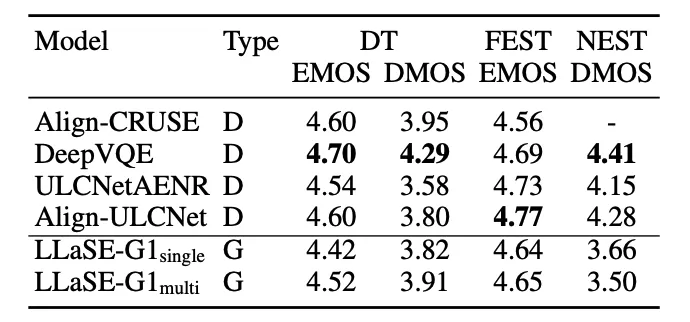
表 1 展示了提出的 LLaSE-G1 与几种最先进的判别式和生成式模型的对比结果。"With Reverb" 列表示包含混响的测试集,而 "No Reverb" 列表示不包含混响的测试集。结果表明,生成式噪声抑制模型在去噪性能上始终优于判别式模型,尤其是在混响条件下。通过单次推理,LLaSE-G1 已经超越了大多数其他系统。经过多次推理后,其性能进一步提升,在无混响测试集上取得了 3.49 的 OVRL 分数,在有混响测试集上取得了 3.42 的 OVRL 分数,达到了当前SOTA的水平。表2-4则展示了我们提出的LLaSE-G1在训练数据中包含的PLC,TSE,AEC任务上与现有SOTA模型的对比,结果表明,LLaSE-G1在其他任务上也达到了超越或者与现有SOTA模型可比的效果。
表1 DNS测试集上的结果
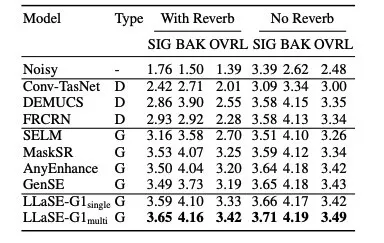
表2 PLC盲测集上的结果
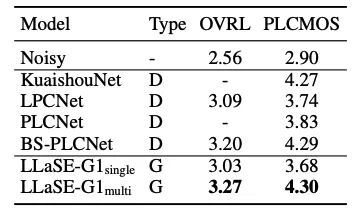
表3 TSE盲测集上的结果
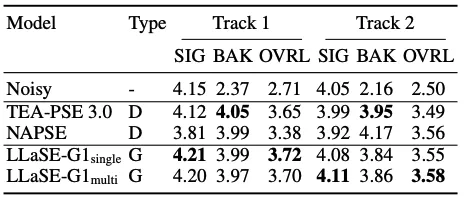
表4 AEC盲测集上的结果
良好的涌现与扩展效应
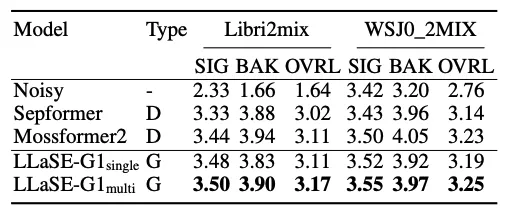
如表5所示,SS任务并未包含在训练数据中,我们使用它来测试LLaSE-G1的涌现能力。与其他判别式方法相比,我们基于LLaMA的LLaSE-G1展现了显著的涌现能力。通过多次推理,我们的生成模型在测试集上的OVRL分数分别达到了3.17和3.25,优于判别式方法,展示了LLaSE-G1超越任务特定优化并无缝适应新任务的潜力。
表5 Zero-shot的语音分离任务结果
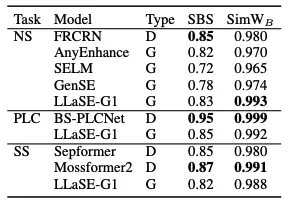
如表 6 所示,我们对比了基线系统和 LLaSE-G1 在语义和说话人相似性方面的表现。需要注意的是,TSE和AEC任务是在盲测集上测试的,这些数据集中没有真实的目标语音作为参考,因此我们仅对噪声抑制NS、PLC和SS任务进行了评估。LLaSE-G1 在生成式语音增强模型中表现优异,尽管在语义相似性(SBS)得分上相比判别式模型略低,这表明 LLaSE-G1 能够有效保留语音内容。此外,LLaSE-G1 在 NS 任务中取得了最高的说话人相似度(SimWB) 分数,在 PLC 和 SS 任务中也表现出具有竞争力的 SimWB 分数,展示了其卓越的声学保留能力。
表6 在各种任务语义和说话人相似度上的结果
如图 2 所示,增加推理时间几乎在所有任务中都提升了模型性能。对于AEC和TSE任务,性能在第二次推理后达到峰值,其中EMOS从4.42提升至4.52,DMOS从3.82上升至3.91。相比之下,PLC任务在增加推理时间后表现出显著的性能提升,PLCMOS从3.67上升至4.30,OVRL从3.03提升至3.27,增幅高达25%。对于NS任务,OVRL分数在no_reverb数据集上从3.42增加至3.49,在with_reverb数据集上从3.33上升至3.42。这些结果表明,增加测试时的计算资源最初会提升性能,但随后由于声学失真的累积,性能会有所下降。
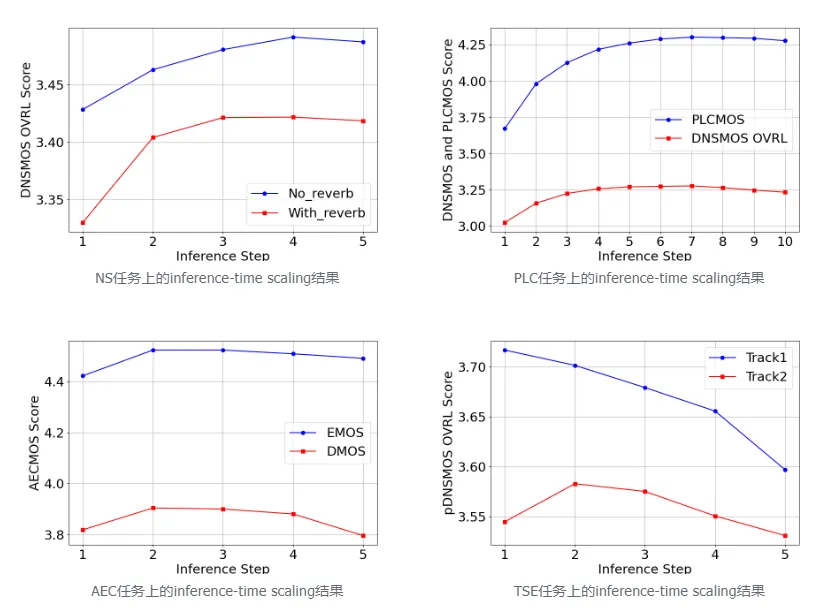
图2 在各种任务上的inference-time scaling结果
失败的尝试
在实验设计过程中,我们原本计划基于语言模型的泛化能力,通过单一输出通道实现多任务统一输出。这种设计理念旨在利用LM的自主判断能力,使其能够识别任务类型并确定相应的输出目标。然而,在具体任务实施过程中,我们发现AEC和TSE任务中参考音频的功能存在本质性差异:在TSE任务中,参考音频作为目标语音的音色参考,而在AEC任务中,参考音频则用于引导模型消除与之相似的噪声成分。这种功能上的对立性导致模型在训练过程中产生显著的混淆,特别是在LM能力相对有限的情况下,模型难以实现有效收敛。
为解决这一问题,我们最终采用了双通道Token输出策略。具体而言,我们定义通道1为与参考音频相关联的音频输出通道,通道2则为与参考音频无关的音频输出通道。通过这种策略,TSE任务的输出被明确分配至通道1,而AEC、NS、PLC和SS等任务的输出则统一分配至通道2。这种分通道输出策略不仅有效解决了不同任务间参考音频功能的冲突问题,同时实现了多任务输出的系统化统一。
完整样例请查看Demo Page:https://submission-papers.github.io/LLaSE-G1-demo-page/
参考文献
[1] OpenAI. 2024. Gpt-4 technical report. Preprint, arXiv:2303.08774.
[2] Michael Tschannen, Cian Eastwood, and Fabian Mentzer. 2024. Givt: Generative infinite-vocabulary transformers. Preprint, arXiv:2312.02116.
[3] Zhen Ye, Xinfa Zhu, Chi-Min Chan, Xinsheng Wang, Xu Tan, Jiahe Lei, Yi Peng, Haohe Liu, Yizhu Jin, Zheqi DAI, Hongzhan Lin, Jianyi Chen, Xingjian Du, Liumeng Xue, Yunlin Chen, Zhifei Li, Lei Xie, Qiuqiang Kong, Yike Guo, and Wei Xue. 2025. Llasa: Scaling train-time and inference-time compute for llama-based speech synthesis. Preprint, arXiv:2502.04128.
[4] Jixun Yao, Hexin Liu, Chen Chen, Yuchen Hu, EngSiong Chng, and Lei Xie. 2025. Gense: Generative speech enhancement via language models using hierarchical modeling. ICLR2025, arXiv:2502.02942.
[5] Ziqian Wang, Xinfa Zhu, Zihan Zhang, YuanJun Lv, Ning Jiang, Guoqing Zhao, and Lei Xie. 2024. Selm: Speech enhancement using discrete tokens and language models. ICASSP2024, arXiv:2312.09747.
