为促进最新研究成果的传播与交流,CCF语音对话与听觉专委在专委会微信公众号启动论文导读栏目,定期分享最新语音、对话与听觉相关研究方向论文。本期分享一篇被NeurIPS 2024接收的语音翻译方面的文章。本导读论文栏目持续征稿中,欢迎踊跃投稿,投稿方式请参见文末指南。
论文标题:TransVIP: Speech to Speech Translation System with Voice and Isochrony Preservation论文作者:乐辰阳, 钱瑶, Dongmei Wang, 周龙, 刘树杰, Xiaofei Wang, Midia Yousef, 钱彦旻, Jinyu Li, Sheng Zhao, Michael Zeng论文单位:Microsoft Research, 微软亚洲研究所,上海交通大学作者邮箱:nethermanpro@sjtu.edu.cn; yaoqian@microsoft.com; Dongmei.Wang@microsoft.com; Long.Zhou@microsoft.com; shujliu@microsoft.com; Xiaofei.Wang@microsoft.com; midiayousefi@microsoft.com; yanminqian@sjtu.edu.cn;jinyli@microsoft.com;nzeng@microsoft.comDemo链接:https://www.microsoft.com/en-us/research/project/transvip/
论文亮点:
TransVIP 提出了一种新颖的框架,通过级联方式利用不同数据集,并通过联合概率促进端到端推理,确保翻译过程中保留说话者的声音特征和源语音的等时性。该模型引入了两个独立的编码器,一个保留语音特征,另一个保留等时性信息,使其特别适合于视频配音等需要严格控制语音时长的场景。通过特征解耦,模型能够在生成过程中同时处理语义、声学和等时信息,优化了生成音频的质量,并且能够在无文本干预的情况下生成高质量语音。在翻译质量、语音相似度、长度控制等指标上,TransVIP 超越了目前的最先进系统。TransVIP 展示了在语音长度和停顿数控制方面的卓越性能,确保生成的目标语音与源语音在时长上高度匹配,提升了语音的自然度和一致性。该论文表明,TransVIP 不仅提高了翻译性能,还在保持语音和等时性上取得了显著进步,具有广泛的应用前景,特别是在自动视频配音等领域。
端到端语音到语音翻译的研究兴趣和趋势日益高涨。然而,大多数端到端模型都难以超越级联模型,即通过串联语音识别、机器翻译和文本到语音模型的层级式框架。主要挑战来自直接翻译任务的内在复杂性和数据的稀缺性。在本工作中,我们介绍了一种新颖的模型框架 TransVIP,它以级联方式利用各种数据集,并通过联合概率促进端到端推理。此外,我们还提出了两个独立的编码器,以在翻译过程中保留说话者的语音特征和源语音的等时性,使其非常适合视频配音等场景。我们在实验证明,我们的模型优于目前最先进的语音到语音翻译模型。
近年来,语音翻译(ST)已从松散耦合的级联系统转变为更加集成,甚至是端到端的系统。传统上,级联系统由自动语音识别 (ASR)、机器翻译 (MT) 和文本到语音 (TTS) 的独立组件组成。最近的研究成功地将自动语音识别和机器翻译集成到一个统一的端到端语音到文本翻译(S2TT)系统中。此外,整合 TTS 以形成语音到语音翻译(S2ST)系统已成为一个日益重要的研究领域。开发端到端 S2ST 系统的主要挑战在于性能问题。S2TT 和 TTS 都涉及多种合理输出的高可变性。同时执行这些任务会成倍增加学习的复杂性。此外,端到端 S2ST 数据非常稀缺。大多数可用数据都是弱监督数据,是通过合成或互联网爬取获得的,这使得任务更加复杂。另一个重大挑战是保留说话者的身份,因为几乎不可能获得由同一说话者用两种语言说出的具有地面实况配对语音的大规模数据集。在视频配音等实际应用中,还需要控制生成的目标语音的长度,确保其与源语音的长度紧密匹配。然而,大多数现有的 S2ST 系统都不具备这种等时控制能力。为了解决这些问题,我们提出了 TransVIP,这是一种具有语音和等时性保留功能的语音到语音翻译框架。TransVIP 采用连续生成方法,将复杂的 S2ST 任务简化为两个连续任务,同时保持端到端的框架。目标语音的生成不仅取决于传统 S2ST 模型中的语义信息,还取决于从源语音中获得的等时性和声学信息。一、基于特征解耦的文本-语音连续自回归生成框架
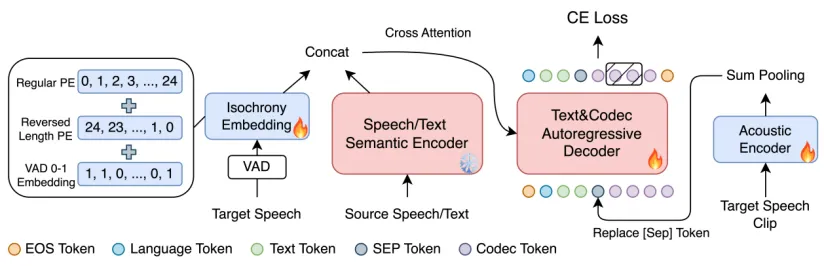
图1 TransVIP联合自回归生成框架图
图1为TransVIP的联合自回归生成部分架构图,其包含3种特征的输入:(a)语义信息。是使用预先训练好的语音编码器从编码器-解码器语音/文本-文本翻译模型中提取的,其中包含较多的语义信息以及较少的有关说话人的声学信息。在训练过程中,我们冻结了两个预训练编码器。(b)声学信息。这一部分信息用于说话者声音的独特声学特征。我们使用由从头开始学习的变换块组成的声学编码器来提取声学信息。这些信息会编码成一个单一的特征表示,然后在自回归解码阶段代替分隔符的词向量,并最后控制生成音频的音色。(c)等时信息。我们的等时控制模块包含三种嵌入:常规位置嵌入、反向位置嵌入和语音活动检测(VAD)0-1 嵌入。反转位置嵌入为模型提供了时长信息,即自回归推理阶段未来需要生成的token数。VAD 0-1嵌入提供了说话的停顿信息。这三种特征各自通过一个编码器输入到模型之中。其中语义信息和等时信息由交叉注意机制输入到自回归解码器中,而声学信息通过单个特征向量方式输入。在自回归解码中我们采用第一层语音Codec作为生成语音的离散表征,并且文本与语音连续生成。这整个架构通过语音-文本,文本-语音等多任务训练的方式进行优化。
SpeechTokenizer[1]提出将N层codec编码解耦为一层语义层和N-1层声学层以更好地契合自回归和非自回归阶段生成的特性。我们在其基础上进一步改进,加入了DAC[2]中解耦与L2正则化的量化模块。我们采用MMS[3]替代Hubert[3]作为语义teacher模型以更好适应多语种。我们将我们的codec命名为SASC(语义感知的语音codec)。基于SASC的这些特性,其声学非自回归生成不再需要文本的介入也可以做的同样好。同时无文本介入还可以提供两项优势:1)可以有效地利用大量无标注音频数据进行训练,2)无需获得输入语音的文本,可以简化推理流程。此外我们还采用了创新的基于采样的在层level的beam search算法来改进生成质量。
三、实验结果
翻译性能方面,与 Seamless 基线相比,我们的 TransVIP 取得了极具竞争力的结果。在法语到英语的翻译方向上,我们的模型取得了 32.60 的 BLEU 分数,比 SeamlessM4T 中级高出 3.65 分,比较大的Expressive 高出 1.75 分。在英语到法语的方向上,我们的模型比 M4T medium 高出 6.22 分。此外,我们的模型的 ASR-BLEU 性能与 Expressive 不相上下。
表1 实验比较
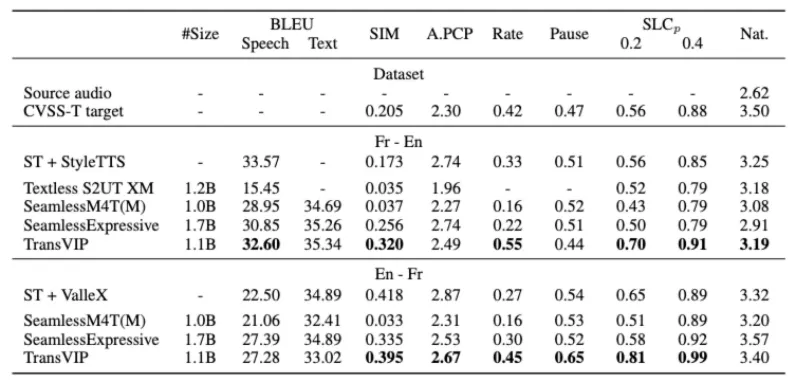
音色保持方面,我们在的 SIM 一栏中评估了说话者的相似性。无文本 S2UT 模型和 M4T 中型无法有效保留说话者的身份,其相似度得分接近零就是证明。相比之下,我们的 TransVIP 模型在 fr-en 和 en-fr 方向的得分都优于 Expressive 基线。在等时控制方面, 我们通过几个指标来评估等时性控制:语音长度符合性(SLC)、语音速率符合性和停顿数符合性。1) TransVIP 展示了卓越的长度控制能力与未采用长度控制策略的基线模型相比由显著提升。2) TransVIP 在所有基线模型中实现了最高的语音速率符合性,这得益于将速率信息纳入模型的声学编码器。3) 关于停顿数,TransVIP 在 En-Fr 中得分最高,而在 Fr-En 中与 SeamlessExpressive 相比则略逊一筹。在查看样本后,我们认为这是因为 TransVIP 在语音中添加了新的停顿,以调整总时长。语音自然度方面,我们注意到,根据 NISQA 分数衡量,语音Prompt的质量对生成语音的自然度有很大影响。例如,在处理低质量的真实法语数据(Fr-En)时,Expressive 的得分最低,仅为 2.91 分。相反,在输入高质量的合成英语数据(En-Fr)时,Expressive 获得了 3.57 的最高分。因此,一个好的模型需要有足够的鲁棒性应对带噪的输入,我们的 TransVIP 模型表现确实十分稳定。
本文中,我们开发了一种语音到语音的翻译框架,它能保留说话人的声音和等时性,生成高质量的翻译语音,既适用于日常交流,也适用于自动视频配音。我们的框架可以端到端方式进行推理,在推理阶段联合考虑文本和语音概率,并在训练阶段充分利用各种数据。在实验中,TransVIP 超越了当前最先进的模型,其翻译性能相当,语音和等时性保持方面也有显著改善。
 语音小管家