
 智能语音新青年
0、摘要
1、引言
诸如推特和微博这样的社交媒体平台允许人们向互联网贡献大量内容。然而,这些内容往往充斥着谣言,这可能会导致重大的社会问题。例如,在2020年的前三个月,近6000人因新冠病毒的错误信息而住院,而COVID-19疫苗的错误信息和虚假信息估计每天造成5000万至3亿美元的损失。
人类通常容易受到错误信息或者谣言的影响,并且可能在无意间传播它们。由于人工谣言检测的覆盖率低、延迟较高,建立谣言自动检测模型是十分必要的。先前基于文本模态的谣言检测模型侧重于探索传播、用户信息和写作风格。
此外,Jin等人的报告指出,带有图片的微博的访问次数是没有图片的微博的11倍,这体现出多模态内容在谣言检测中的重要性。具体的,一些研究通过直接连接图像和文本的表征来研究不同模态的融合。然而,直接连接两种模态(即文本模态和视觉模态)可能无法捕捉他们深层的语义交互。为了解决这个问题,协同注意驱动的谣言检测模型旨在提取两种模态之间的一致性。然而,目前的多模态谣言检测模型通常忽略了不完全模态的问题,例如在给定的帖子中缺少图像或文本,这使得它们在处理这种情况的时候效率比较低。
为了解决上述问题,我们提出了一个新的方法,对比学习和知识蒸馏的不完全模态谣言检测。事实上,监督对比学习能够有效地拉近相同类别的表征,同时推远不同类别的表征,并且在揭穿谣言的过程中,知识蒸馏能够有效地解决不完全模态的问题。更具体地说,我们首先构造了一个教师模型,包括多模态特征提取、多模态特征融合,以及对比学习。然后,我们采用知识蒸馏来构建学生模型,以解决不完全模态(即图像或者文本缺失)。实验结果和可视化证明我们的CLKD-IMRD在英文和中文的社交媒体谣言检测数据集上表现出SOTA的结果。
这篇论文主要做出了三点贡献。
(1)我们提出了一个新的谣言检测框架,该框架将监督对比学习应用到了我们的教师网络这个框架能够提取原始文本、图像和用户评论之间的深层语义交互。
(2)我们提出了一个知识蒸馏驱动的谣言检测模型,该模型可以处理社交媒体上常见的不完全模态(即图像或者文本缺失)。
(3)我们进行了丰富的实验和可视化,来验证提出的CLKD-IMRD模型与众多强baseline模型相比,在四个基准谣言语料库上的有效性。
2、相关工作
2.1、基于单模态的模型
一般来说,传播模式是很好的谣言检测指标,因为不同类型的用户(如普通用户和意见领袖)之间的互动或原始博文及其后续反应可以帮助检测谣言。如Wu所述,一个谣言首先由普通用户发布,然后一些意见领袖支持它。最后被大量普通用户转发。然而,正常信息的传播与假新闻的传播模式大不相同。正常的消息是由意见领袖发布的,许多普通用户直接转发了这条消息。Ma等人也提出了一种基于传播路径的模型来揭穿谣言。Lao等提出了一种基于传播的谣言检测模型,同时提取线性时间序列和非线性扩散结构。
此外,用户信息也是一个很好的谣言检测指标,因为权威用户不太可能发布谣言,而正常用户则有很大的概率产生或转发谣言。具体来说,Mukherjee和Weikum基于如下因素评估用户可信度,包括社区参与指标(例如,回答的数量、给出的评价、评论、收到的评价、不同意和评分者的数量)、用户间协议、典型观点和专业知识,以及互动。Yuan等提出了一种基于整合发布者和转发用户声誉的假新闻检测模型。Li等人提出了一种基于用户信用驱动的多任务学习框架,可以同时进行谣言检测和姿态检测。
此外,写作风格是谣言检测的一个关键因素,因为谣言与非谣言在词汇和句法上往往存在明显差异。具体而言,Rubin等人提出了一种基于修辞结构的新闻核实框架。修辞结构是语篇分析中广泛使用的一种理论,它描述语篇的组成单位如何按照一定的关系组织成连贯完整的语篇。根据修辞结构理论,语篇单位之间的关系大多表现为核-卫星关系。与作者的交际意图相比,核心位置的语篇单位是相对重要的位置,核心语篇单位与卫星语篇单位之间存在不同的语篇关系。Potthast等人采用了一些词汇特征(如字符单字、双字和三字、停用词、词性、可读性值、词频、引用词和外部链接的比例、段落数和文本的平均长度)来检测假新闻。Przybyla提出了一个基于写作风格的假新闻检测框架来验证情感词汇的有效性。
2.2、基于多模态的模型
Wang等提出了一种基于GAN的多模态假新闻检测模型,采用VGG (Visual Geometry Group)提取视觉特征,同时采用CNN(卷积神经网络)提取文本特征。他们还整合了事件的不变性特征,以方便对假新闻的新到达事件的检测。Khattar等人提出了一种基于变分自编码器的假新闻检测模型,以捕捉文本和视觉模式之间的共享表征。他们新颖的解码器能够利用从变分自编码器中提取的多模态表征。Zhou等提出了一种基于相似度的假新闻检测模型,用于联合计算多模态和跨模态特征之间的相似度。此外,Dhawan等人提出了一种基于图注意力的假新闻检测框架,将文本词信息与图像局部视觉对象之间的交互考虑在内。Wei等人提出了一种基于图卷积网络的谣言检测模型,通过贝叶斯模型研究传播结构中潜在关系的可靠性。Yuan等人提出了一种基于图的谣言检测模型,将局部语义和全局结构信息的编码同时结合起来。Zheng等人提出了一种基于GAT的谣言检测模型,将文本、视觉和社交图整合在一起。
尽管近年来出现了许多多模态谣言检测模型,但它们往往忽略了具有相同或不同类型标签的样本的差异化特征。此外,这些模型没有考虑到不完全模态的情况,在这种情况下,图像可能无法加载,这在互联网上很常见。为了解决这些差距,我们提出了一个基于对比学习和知识蒸馏的新框架,以有效地揭穿不完全模态的谣言。
3、方法
3.1、任务制定
定义P={p1,p2,…,pn}作为一组帖子。每个帖子pi由{ti,vi ,ci }组成的,ti其中表示原始文本,vi表示图片,以及ci表示评论。我们将谣言检测作为一个二分类任务,目标是学习一个函数f(pi)→y,其中表示给定的多模态帖子,y表示分配给这个帖子的标签,其中y=1表示谣言,y=0表示非谣言。
3.2、CLKD-IMRD的框架
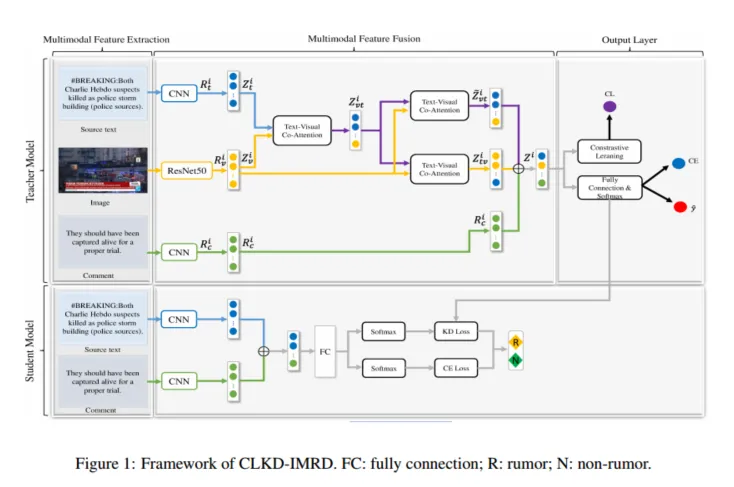
图1展示了我们提出的用于谣言检测的CLKD-IMRD框架。具体来说,我们采用多模态特征提取模块从给定的帖子中获取原始文本、图片和评论的表征。对于教师模型,提取的多模态特征被输入到多模态融合模块。在多模态融合过程中,我们使用视觉特征来增强文本特征,使用跨模态联合注意力机制从文本和视觉表征之间来获取增强特征。之后,在输出模块,我们整合来自不同模态的特征到监督对比学习框架中。对于缺少视觉模态的学生模型,我们直接拼接原始文本和评论的表征,并且采用知识蒸馏的方式来获取相应的分类结果。
3.2.1、教师模型
教师模型由三个模块组成:多模态特征提取,多模态特征融合,以及输出层。
多模态特征提取:对于文本特征提取,我们采用CNN从原始文本和评论中获取文本表征。给定一个帖子pi中的文本ti,我们首先获取它的表征Oi(1:t)={oi(1),oi(2),...,oi(Lt)}其中oi(j)表示文本ti中第j个单词的词向量,并且o∈Rd其中d被定义为词向量的维度尺寸。之后,词向量度量O被输入到CNN框架中来获取特征映射Si={Si1,Si2,...,Si(Lt-k+1)}其中k是感受野的大小。之后,我们对Si进行最大池化来获得S`l=max(Si)
并且从源文本ti中提取最终的表征为
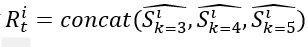
通过串联不同感受野。相似的,我们提取评论Ci的表征
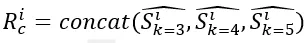
我们使用ResNet-50来提取图片vi的表征。具体来说,我们首先提取ResNet-50倒数第二层的输出,并将其表示为vi(r),将其输入到一个全连接层中,以获得最终的视觉特征
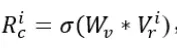
维度大小与文本特征相同。
多模态特征融合:为了提取不同模态之间的相互作用并加强跨模态特征,我们采用了协同注意力机制。对文本和视觉模态,我们首先采用多头自注意力来增强特征内表征。例如,给定文本特征Ri(t),使用以下方式,来分别计算矩阵Q、K和V。
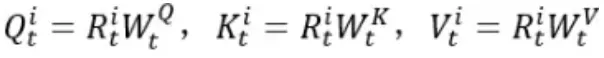
其中WQ(t),WK(t)和WV(t)∈R^{d*(α/H)}是线性变换,其中H是总头数。
我们通过公式1获取文本模态的多头自注意力特征。
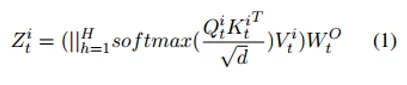
其中“||”表示串联操作。表示第h个头,以及wo(t)∈Rd*d表示线性变换的输出。
类似的,我们通过公式2来获取视觉模态的多头自注意力特征。
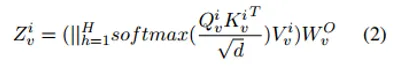
为了提取文本和视觉模态之间的协同注意力,我们执行了类似的自注意过程,将Ri(t)替换为zi(v),Ri(t)替换为zi(t)来分别生成Qi(v),Ki(t)和Vi(t),并且利用公式3最终获得利用视觉特征增强后的文本特征zi(vt)。
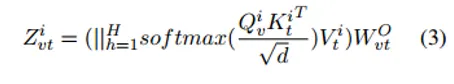
之后,我们分别利用公式4和公式5进行Zi(vt)和Zi(v)之间的第二次协同注意力来获取跨模态特征Z`i(vt)和Zi(tv)
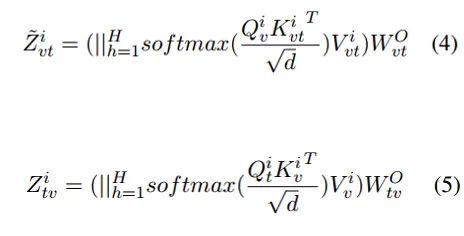
最后,我们对两个增强后的特征以及初始的评论特征进行串联来获得最终的多模态特征
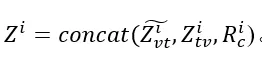
输出层:一直监督对比学习能够有效地拉近相同类别的表征,同时能够推远不同类别的表征。我们引入监督对比学习函数到我们的谣言检测总损失中,如公式6所示。为了增强提出模型的鲁棒性,我们在每次训练迭代中计算文本特征的梯度时,将投影梯度下降法引入到文本嵌入中,并采用它来计算对抗性扰动。之后,我们再次计算已更新的文本特征的梯度,重复这个过程m次,并且采用球面空间限制扰动范围。最后,我们将上述对抗梯度累加到原始梯度中,并将其用于参数平差。
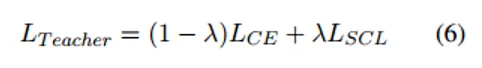
其中λ∈{0,1}是超参数。CE是交叉熵损失(公式7),以及SCL是监督对比学习(公式8)。
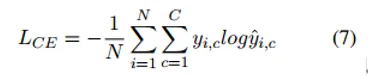
其中C是标签类别(即谣言和非谣言),yi,c是类别c的真实标签, y`i,c表示类别c的预测结果。
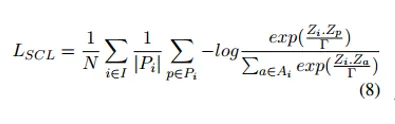
其中I定义为训练样本编号的集合,pi为正样本序列的集合,Ai表示剩余样本的指标,Zi表示正则化,T表示控制不同类别的温度系数。
3.2.2、学生模型
如引言部分所述,现有的谣言检测模型忽略了不完全模态问题。在给定的多模态帖子中,图像无法加载是很常见的。由于缺乏视觉信息,只能使用文本信息进行谣言检测。为了解决这个问题,我们采用知识蒸馏,基于我们预训练的教师模型执行不完全谣言检测。知识蒸馏背后的动机是利用教师网络预测的软标签来指导学生网络的学习,提高其性能。通过最小化学生和教师模型的软概率分布之间的距离,如KL损失(公式9)所测量的,我们的目标是使学生模型的预测与教师模型的预测保持一致。从本质上讲,知识蒸馏的目的是将与教师网络相关的软目标(具有复杂但优越的预测性能)纳入整体损失函数。这有利于学生网络的训练,简化后的网络复杂度较低,更适合部署在推理场景中。最终目标是实现有效的知识转移。
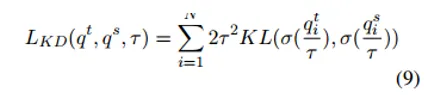
其中qt和qs分别表教师网络和学生网络的输出,σ表示softmax,τ表示两个分部的平滑度的尺度温度。较低的值将使分布锐化,导致两个分部之间的差异扩大。它将蒸馏集中在教师网络预测的最大输出上。另一方面,较高的τ值将使分布变平,缩小教师和学生网络之间的差距。这种更广泛的分布将蒸馏集中在整个产出范围内。学生模型的总损失如公式10所示。
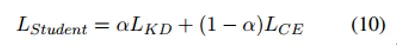
其中CE表示交叉熵损失,α为超参数。
4、实验
4.1、数据集描述
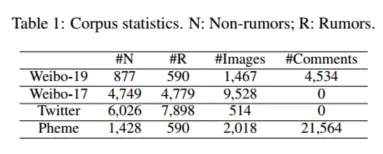
我们使用了四个基准多模态语料库:两个中文数据集(例如,Weibo -19,Weibo -17)和两个英语语料库(例如,Twitter,Pheme)。每个数据集包括源文本和图像。Weibo-19和Pheme有评论,而Weibo17和Twitter没有评论。表1给出了四个基准语料库的统计数据。我们采用四种流行的评估指标:即准确性,精度,召回率和F1-Score,来调查我们提出的框架和其他比较方法的性能。
Baselines:我们设置了7个baseline模型作为说明在附录A.1。
超参数设置:按照现有baseline系统的方法,我们将数据集分别以7:1:2的比例划分为训练集、验证集和测试集。对于词向量,我们采用了Yuan等人提出的word2vc风格嵌入。自注意力中头h个数设为8。我们采用Adam来优化我们的损失函数。学习率设置为0.002,批量大小设置为64。dropout的值设置为0.6。知识蒸馏中的τ设为5.0。有监督对比学习中的T设为0.5。源文本Lt和Lc注释的长度设置为50。α设为0.7,λ设为0.5。对抗性扰动中m的个数设为3。我们在所有实验中进行了5次运行,并报告了平均结果和标准差结果。
4.2、结果和分析
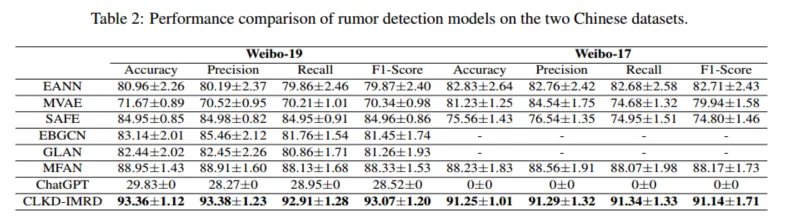
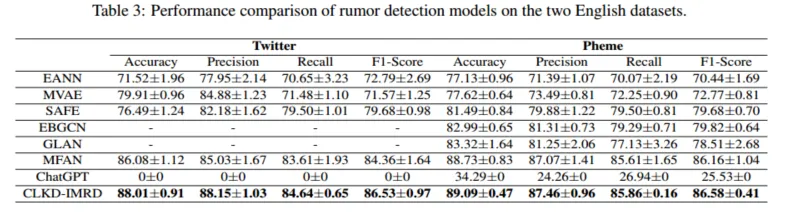
模型对比:表2和表3给出了在中文和英文数据集上五次执行的平均性能和标准差。在Pheme和Weibo-19数据集上,由于我们使用了相同的训练集、验证集和测试集作为baseline系统,我们直接将我们的结果与他们的结果进行比较。此外,我们在Twitter和Weibo-17数据集上执行来自这些baseline的公开可用源代码。由于EBGCN和GLAN通过使用源帖子中的评论构建传播图,因此我们不报告它们在没有评论信息的Weibo-17和Twitter数据集上的性能。从表2和表3中可以明显看出,我们的CLKD-IMRD在准确性、精度、召回率和F1Score度量方面优于其他模型。这突出了多模态特征融合和对比学习在我们的方法中的重要性。虽然ChatGPT在各种NLP任务中被证明是有效的,但它在谣言检测中的表现并不令人满意。在Weibo17和Twitter数据集上,只使用了短的源文本,没有补充评论,导致ChatGPT在谣言检测任务上的性能不佳。根据表2和表3的观察,我们可以得出以下见解:
(1)在三个多模态baseline(EANN、MVAE和SAFE)中,SAFE在正确率、精密度、召回率和F1-Score四项指标上的表现都是最高的。另一方面,MVAE在Weibo数据集上的所有四个度量指标中表现最差,这突出了MVAE中文本和视觉模式的肤浅结合的有效性。相反,在EANN模型中加入事件信息对辟谣是有益的。值得注意的是,SAFE模型成功地融合了文本和视觉模式之间的深度交互,从而产生了卓越的性能。
(2)在EBGCN、GLAN和MFAN三种基于社交图的baseline模型中,它们比简单的EANN和MVAE模型表现出更好的性能。EBGCN和GLAN都实现了相当的性能,因为它们包含了结构信息。然而,MFAN结合了文本、视觉和基于社交图表的信息,在所有四个方面都优于其他方法:准确性、精确度、召回率和F1-Score。
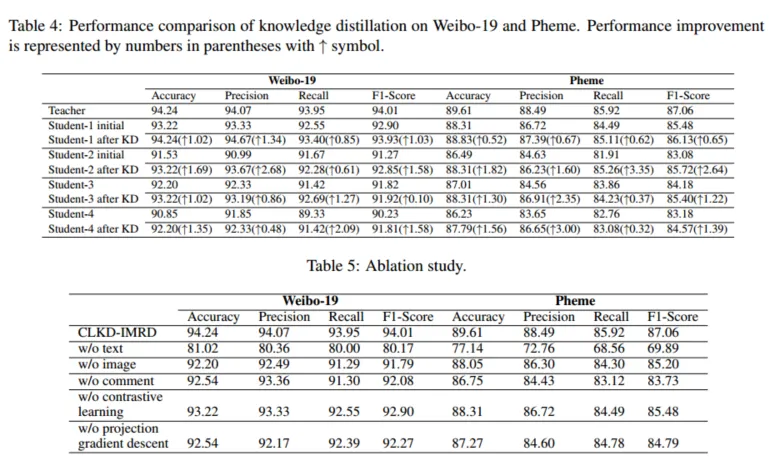
知识蒸馏的性能:CLKD-IMRD包括采用多模态对比学习模型作为教师模型,采用多模态和不完全模态模型作为学生模型。这种师生框架允许我们将知识从多模态教师模型转移到多模态和单模态学生模型。我们探索了四个学生模型,每个模型都只使用交叉熵损失作为损失函数。
Student-1:该模型结合了所有的模式,包括源文本、可视信息和用户评论
Student-2:该模型侧重于文本(源文本)和视觉模态。
Student-3:该模型依赖于文本形态,同时考虑源文本和注释。
Student-4:该模型完全依赖于源文本模态。
由于篇幅所限,在Weibo-19和Pheme数据集上的知识蒸馏结果如表4所示,这表明在教师模型的指导下,所有学生模型都有所提高。即使是只包含源文本情态的Student-4,准确率和F1-Score也提高了1.0%和1.7%。在其他三个学生模型(Student-1、Student-2和Student-3)中也观察到类似的改进。其中,利用所有模式(源文本、视觉信息和用户评论)的Student-1在所有四个测试中都取得了最佳表现。一般来说,Student-2的表现优于Student-3,因为它结合了文本和视觉形式,而Student-3只依赖文本信息。
消融实验:由于篇幅所限,表5给出了在Weibo-19和Pheme数据集上的消融分析性能,其中我们通过考虑五种情况来检验各成分的影响
w/o text: 我们排除使用源文本。
w/o image: 我们忽略了对图像信息的利用。
w/o comment: 我们不考虑包含评论。
w/o contrastive learning: 我们消除了对比学习的应用。
w/o projection gradient descent: 我们不使用投影梯度下降。
根据表5的发现,可以得出几个结论。1)源文本在谣言检测中起着至关重要的作用。当排除源文本时,性能显着恶化,强调了文本情态在识别谣言中的重要性。2)图片和评论都有助于辟谣,因为没有图片和评论会导致识别效果下降。3)有监督对比学习的整合增强了模型区分语料库中正负样本的能力,这对模型的性能产生了积极的影响。4)在对抗扰动训练阶段加入投影梯度下降,提高了模型的鲁棒性。
协同注意力设置的影响:我们进一步分析了不同协同注意力数量的性能比较,如附录A.2所示。
4.3、评论数量的影响
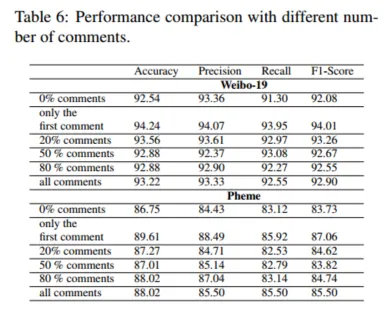
我们进一步分析了不同评论场景的表现,考虑了如下六种情况:
0% comment: 在这种情况下不使用评论。
only the first comment: 只考虑第一个评论。
20% comments: 我们按时间顺序包含20%的评论。
50% comments: 我们以时间顺序的方式包含50%的评论。
80% comments: 我们以时间顺序的方式包含80%的评论。
all comments: 包括所有评论。
篇幅所限,在Weibo-19和Pheme数据集上,评论数对结果的影响见表6。根据表6的发现,我们可以得出结论,增加评论的数量对辟谣没有显著的帮助。事实上,随着评论数量的增加,噪声的引入变得更加突出。有趣的是,第一条评论被证明在谣言检测的背景下更有价值,因为它携带了更多的相关信息来区分谣言和非谣言。
可视化实验:图2和图3分别显示了Weibo-19和Pheme测试数据的T-SNE可视化。可视化清晰地描述了大多数样本成功分类为不同的组,证明了我们提出的模型的有效性和强大的表示能力。
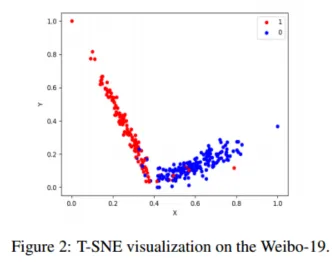
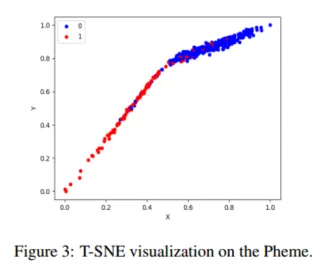
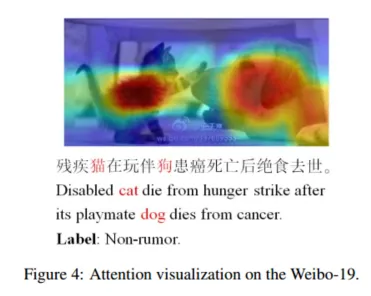
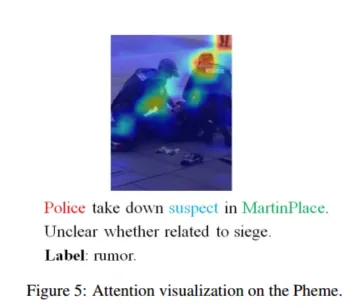
图4和图5分别展示了来自Weibo-19和Pheme的标签为“非谣言”和“谣言”的注意力可视化样本,可以深入了解文本信息和视觉信息之间的交互,以及增强的功能如何有助于辟谣。在图4中,用红色突出显示的单词“Cat”和“Dog”显示出较高的注意力权重,并且与相应图像中的特定区域很好地对齐。这种精准的对齐有助于将样本预测为非谣言。相反,在图5中,单词“suspect”和“MartinPlace”未能与各自的图像区域对齐,这表明对齐不良,并正确地将样本预测为谣言。这些观察结果突出了我们提出的模型中文本和视觉模式之间的深层语义交互。
5、结论
在本文中,我们提出了一个结合监督对比学习和知识蒸馏的谣言检测框架。我们的框架利用分层协同注意力来增强文本(源文本和评论)和视觉模态的表征,使它们能够有效地相互补充。事实证明,利用对比学习在揭穿谣言方面是成功的。此外,知识蒸馏在处理谣言检测的不完全模态方面已经证明了它的有效性。展望未来,我们未来的工作旨在将图结构(如社交图)整合到我们提出的框架中,以进一步改进。
