
 智能语音新青年
0、Abstract
1、Introduction
基于自监督学习(SSL)的预训练模型,如 BERT、GPT、ALBERT 和 data2vec,在通过精心设计的预训练任务从大规模无标记数据中获取上下文信息方面发挥了重要作用。SSL 模型最初用于自然语言处理(NLP),现在已扩展到语音领域。事实证明,将这些模型作为特征提取器获得的表征非常有效,将其应用到语言和语音处理下游任务上时效果极佳。原始语音信号包含丰富的声学和语言信息,善于传达说话者的特征、情感甚至意图。然而,从对数梅尔频谱图、梅尔频率倒频谱系数或波形等表面特征中提取这些高级属性是一项重大挑战。自监督建模提供了一种从这些表面特征中提取高级表示的解决方案,使下游任务可以轻松获取原始语音信号中蕴含的潜在知识。
语音情感识别(SER)是人机交互的重要组成部分。随着深度学习的发展,一些研究旨在利用神经网络从音频信号中学习情感表征。然而,与自动语音识别(ASR)等其他常见的下游任务相比,SER 数据集相对较小。因此,利用自监督预训练模型从大量未标注的语音数据中学习表征,然后将这些模型用作特征提取器或直接微调整个模型,已成为一种常见的解决方案。
在过去几年中,许多研究人员都在深入研究自监督模型,以获得包含更丰富信息的高级表征。例如,Mockingjay提出了不依赖任何标签学习语音表征的无监督训练方法:通过采用多层变压器编码器和多头自注意来实现双向编码的。它提出的掩码声学建模被用来促进语音表征的无监督学习。另一方面,非自回归预测编码(Nonautoregressive predictive Coding,NPC)依靠语音的局部依赖性,以非自回归的方式学习语音表征。这是通过引入掩码卷积块来实现的。HuBERT采用离线聚类步骤,为类似 BERT 的预测损失提供对齐的目标标签。该模型的一个关键要素是仅在掩码区域应用预测损失,从而迫使模型在连续输入上学习声学和语言模型的组合。Wav2vec 2.0在潜空间中掩码语音输入,并处理联合学习的潜表征量化所定义的对比任务。
虽然自监督模型已经取得了成功,但现有方法往往忽略了在预训练过程中纳入与情感相关的信息。情感在人类交流中起着至关重要的作用,利用情感感知表征可以显著提高情感相关任务(如 SER 任务)的性能。具体来说,语音中的情感强度知识已被认为是一个有价值的因素,可以进一步丰富对情感的理解。我们相信,包含情感知识的预训练任务将有助于更好地理解整个语音中的情感,从而提高 SER 任务的表现。
在 NLP 领域,一些研究致力于将文本知识和情感知识整合到预训练模型中。例如,SentiLARE利用标签感知掩码语言模型预训练任务注入词级语言知识,如句子标签和情感极性,以构建知识感知语言表征。受著名的掩码语言建模启发,eMLM引入了新颖的情感相关预训练目标。它不是不加区分地屏蔽同一输入序列中的单词,而是利用词汇信息,为更有可能在情绪或情感语境中起关键作用的词分配更高的屏蔽概率。在语音领域,Vesper模型引入了增强型情感特定预训练编码器。它基于 WavLM对语音数据集进行预训练,同时考虑情感特征。为了提高对情感信息的敏感度,Vesper采用了情感引导的掩码策略来识别需要掩码的区域。然而,上述工作并没有引入强度知识,而强度知识可以帮助预训练模型获取更精细的情感信息。
在自我监督预训练模型中引入情感强度知识面临两个难题:
情感强度知识获取:使用模型从带有情感的语音中获取帧级别的情感强度。 预训练任务设计:将获取的情感强度信息纳入自我监督模型的预训练。
我们提出了一种新颖的情感感知语音 SSL 表示学习方案。 我们从语音中提取了细粒度的情感强度先验信息,并提出了情感掩蔽策略。 我们选择了两个经典的 SSL 模型:Mockingjay和 NPC 作为研究对象。
实验证明,在 SER 任务和其他相关任务中,我们提出的方法所得到的表示优于原始模型。
2、Proposed Method
在本节中,我们将首先介绍任务定义,并概述提出方法的整体工作流程。随后,我们将深入探讨知识获取和训练任务部分。最后,我们将阐明如何将 EMS 应用于Mockingjay和NPC模型。
2.1、Task Definition and Overall workflow
我们的任务定义如下:给定由T帧组成的语音序列X=[x1,...,xT],我们的目标是获得整个序列的高级表示,表示为 H=(h1,h2,…,hn)T∈Rnxd其中 d 代表表示向量的维度。我们的目标是同时捕捉上下文知识和情感知识。
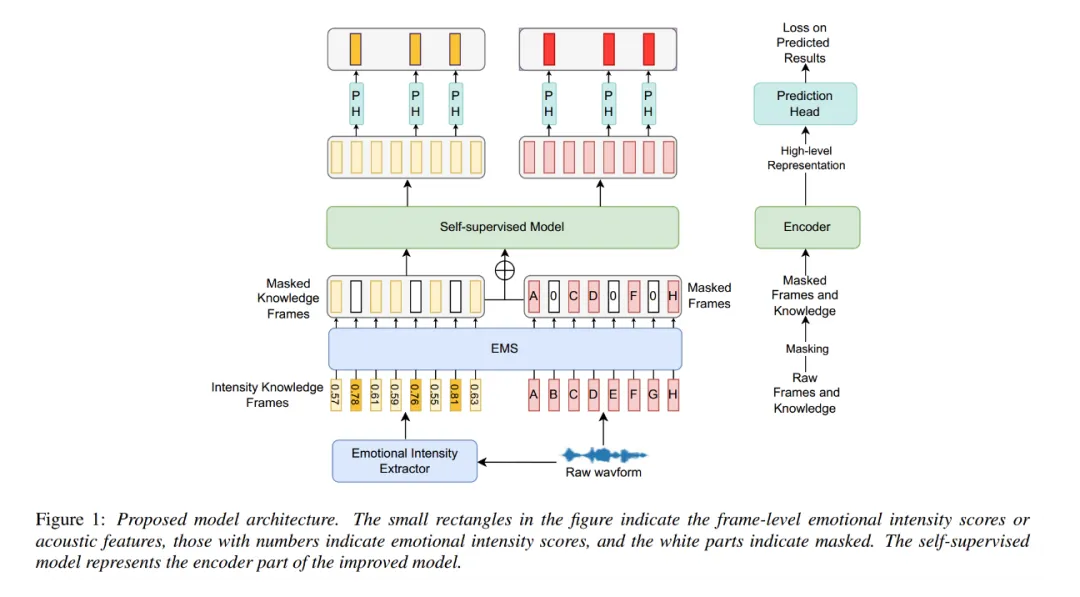
如图 1 所示,我们提出的方法由两个主要部分组成。首先,我们使用情感强度提取器来获取原始音频的情感强度分数。然后,我们使用 EMS 对声音帧和情感强度进行掩码。然后,将掩码结果输入自监督预训练模型。在训练过程中,声学帧和情感强度得分的总和被输入到模型中,由此产生的高级表示通过预测头用于预测。考虑到情感强度和情感强度与原始帧之和的预测误差,采用 L1 损失对模型进行优化。总损失的计算公式如下:
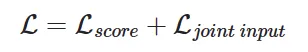
2.2、Knowledge Acquisition and Pre-training Task
2.2.1、Knowledge Acquisition
该模块用于获取输入音频中每一帧的情感强度得分。为此,我们采用了由声学编码器、强度预测器和情感预测器组成的 Strengthnet模型。
声学编码器由 12 个卷积层组成,可从给定的输入梅尔频谱图序列 X中提取高级特征 H,然后将高级特征 H输入两个预测器:一个用于预测情感强度得分,另一个用于预测情感类别。强度预测器包括一个 BiLSTM 层、两个全连接层(FC)和一个平均池化层,该层读取高级特征表示来预测情绪强度得分。与强度预测器类似,情绪预测器也包括一个 BiLSTM 层和一个额外的 softmax 层。利用编码器的输出,情绪预测器可以预测情绪类别。
由于预训练的自监督模型的特征提取层所预测的情绪强度得分和提取的声音帧可能会出现不对齐的情况,因此我们在掩码前应用线性层来对齐它们,以解决这一问题。
2.2.2、Pre-training Task
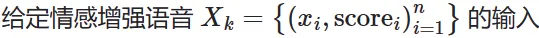
序列,预训练任务的目标是构建情感感知表征向量 H=(ℎ1,ℎ2,⋯,ℎn)⊤,以促进下游的情感相关任务。我们设计了一种名为 “情绪掩码策略”(EMS)的新型监督预训练任务。该模型在预训练阶段纳入了帧级情感强度得分,以捕捉语篇级高层表征与单个帧之间的依赖关系。
传统的屏蔽策略,如 Mockingjay 提出的掩码声学建模 (MAM)使用统一概率(15%)随机屏蔽声学帧,但 EMS 采用了非随机掩码方法。我们为情感强度得分较高的帧分配较高的概率。在计算出每个帧的强度得分后,我们对其进行排序,并选择一个概率值 k 来掩蔽与帧的前 k% 相对应的位置。关于 k值的选择将在实验部分详细说明。
2.3、The pre-training model
我们选择了 Mockingjay 和 NPC 作为预训练模型,它们的核心框架分别是 Transformer 和 CNN。如果我们的方法在不同的框架下都能提高 SER 任务的性能,我们认为这可以说明我们方法的有效性。
2.3.1、Mockingjay with EMS
Mockingjay 模型采用了带有多头自注意的多层变压器编码器进行双向编码。每个编码器层由两个子层组成:第一个是多头自注意网络,第二个是前馈层。每个子层都包括残差连接和层归一化。Mockingjay 中的预训练类似于 BERT 中的屏蔽语言建模。在预训练阶段,编码器输出的连续时间步被随机掩码。在训练过程中,模型会添加一个由双层前馈网络组成的预测头,根据左右上下文信息预测所选的帧。
我们对 Mockingjay 的屏蔽策略进行了修改。在训练过程中,我们选择情感强度得分最高的 k% 帧进行屏蔽。与 BERT 类似,我们引入了一个子随机过程以解决训练与推理之间的不匹配问题来改进训练。这一过程包括三个步骤:1) 在 80% 的时间里,我们将选定的帧屏蔽为零;2) 在 10% 的时间里,我们用随机帧替换选定的帧;3) 在剩余的 10% 时间里,我们保持帧不变。与 Mockingjay 模型类似,为了防止模型利用声学帧的局部平滑性,我们使用了额外的连续屏蔽。这就迫使模型对全局结构进行推断,而不是依赖局部信息。
2.3.2、NPC with EMS
NPC 模型为了在没有全局依赖性或自回归特性的情况下提取时间t的高级表示 ℎt,将自身限制为只依赖于大小为R=2r+1的感受野(xt-r,...,xt,...,xt+r)。在NPC中,
堆叠卷积块用于构建表征提取模型。为了确保高级特征 ℎt 确实是 xt的表示,需要将其线性变换为 yt,以预测 xt。在线性投影之前,会使用一个向量量化层 作为信息瓶颈,以获得更好的表征。NPC 的目标是最小化所有时间步长内表面特征 xt 与基于 ℎt 的预测值 yt 之间的 L1 损失:
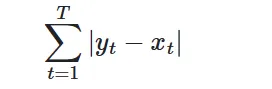
为了实现所需的限制,NPC 引入了掩码卷积块(Masked ConvBlock),其中内核卷积操作可以写为:
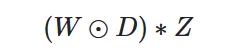
其中Z∈RT×d表示序列长度为 T、维度为 d的模型的中间特征,W∈RT×d 表示大小为k 的可学习卷积核权重,
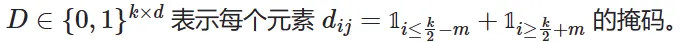
同样,我们对 NPC 模型的掩码策略进行了修改。在获得每帧的情感强度得分后,我们会确定较高的情感得分主要出现在卷积核的哪个部分。具体来说,对于卷积核大小的声学帧的每次迭代,我们都会记录卷积核遍历的每个位置的情感得分。完成遍历后,我们会找出卷积核中平均情感强度得分最高的位置,并将其对应的权重设为 0。
3、Experiments and Results
3.1、Dataset
我们使用交互式情感动作捕捉(IEMOCAP)数据集对修改后的模型进行了微调,该数据集包含约 12 个小时的数据,由 10 名专业演员表演的 5 个情感对话环节组成。其中一个会话涉及两个说话人之间的对话。
在 SER 评估过程中,我们使用广泛使用的 SER 数据集 IEMOCAP,遵循 SUPERB 提出的通用评估协议。我们排除了不平衡的情感类别,只关注中性、快乐、悲伤和愤怒类别。评估采用交叉验证的方式在标准拆分的五层数据集上进行。
3.2、Experimental Setup
3.3、Results on the SER Task
表 1 比较了 Mockingjay 在不同微调概率的 IEMOCAP 数据集上的性能。括号中的数字代表屏蔽概率。从表中可以看出,屏蔽概率在 15%到 40%之间的结果优于 Mockingjay 的 SER 结果。具体来说,使用 25% 的屏蔽概率进行微调的模型表现最佳,比原始模型结果提高了 7.14%。
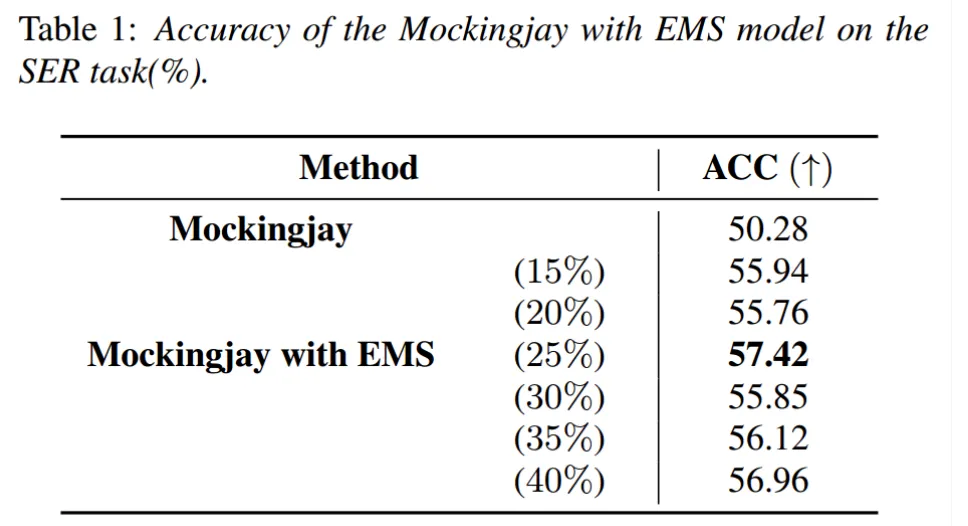
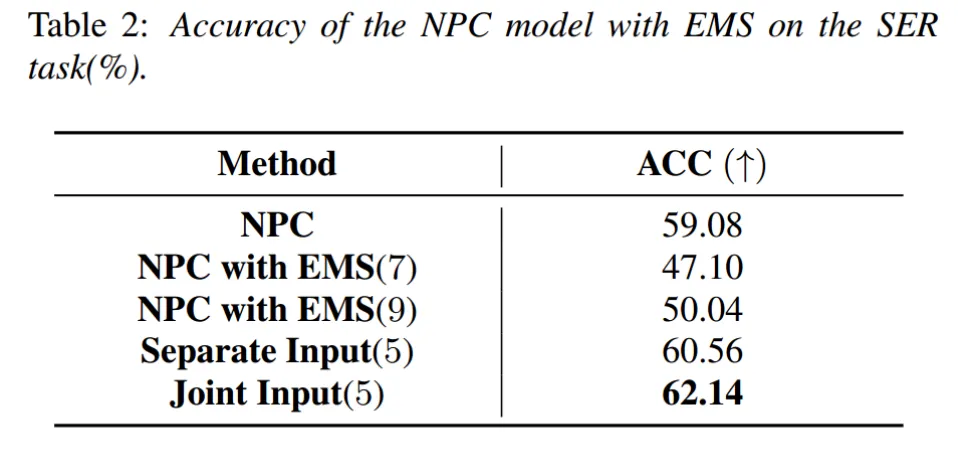
表 2 比较了 NPC 在 IEMOCAP 数据集上的性能,微调过程中使用了不同大小的掩码卷积核。括号中的数字代表掩码卷积核大小。此外,我们还比较了微调期间不同输入对模型的影响。“Separate Input”不将情感强度得分和声音帧相加,而是将它们分别输入自监督模型。“Joint Input”表示将两者相加,并将合并结果和情感强度得分分别输入自监督模型。从表中可以看出,在 SER 任务中,联合输入和单独输入都提高了 NPC 的准确性。其中,联合输入的效果最好,比原始模型的结果提高了 3.06% 的准确率。当掩码卷积核大小为 7 和 9 时,SER 任务的准确率有所下降。我们认为,更大的掩码卷积核可以捕捉到更多的情感信息,但可能会导致大量声学信息的丢失。
3.4、Analysis on Generalization Ability
4、Conclusion
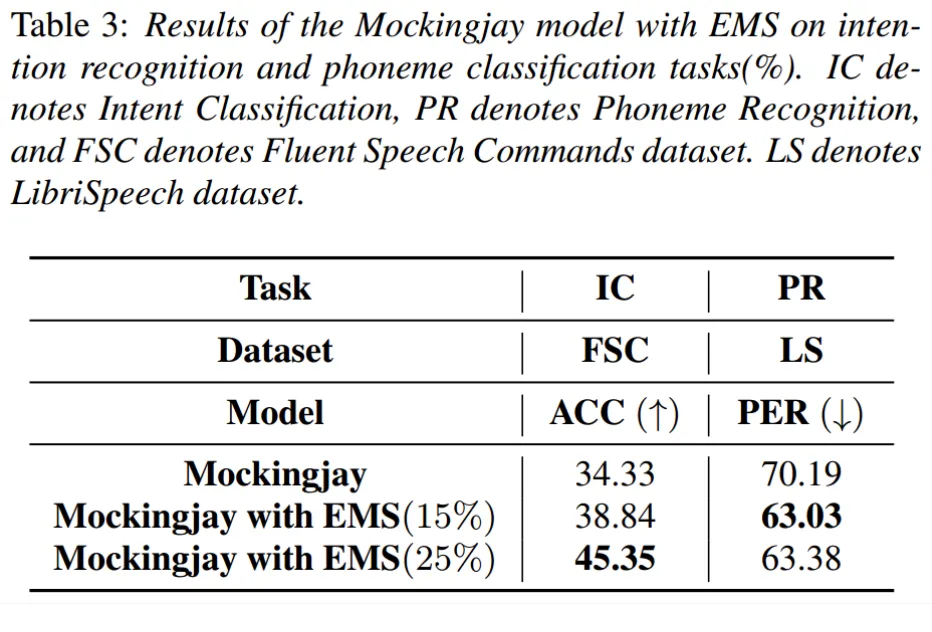
本文介绍了一种基于强度知识的情感感知表征学习方法,称为 EMS。通过提取情感强度得分并设计一种新颖的预训练任务,将情感知识注入高级表征中,我们增强了表征中的情感信息。通过这种方法,我们的方法在 SER 任务中取得了显著的性能提升,在其他下游任务中也表现出了明显的增强。在未来的工作中,我们将考虑将其他粒度的情感知识纳入高级表征中。
论文翻译:内蒙古大学计算机学院2022级硕士生马泽宁(导师:刘瑞研究员))
