
 语音小管家
AudioCC交我学
语音增强正朝着“轻量化、高效率、低延迟”的方向快速发展。随着移动设备、实时通信和嵌入式系统对语音前端处理要求的提升,轻量级语音增强模型已成为推动技术落地的关键力量。本文将介绍轻量级模型的典型结构、设计思路与代表性方法,带你了解如何在有限资源下实现清晰、高效的语音增强。
一、背景
轻量级语音增强模型有什么特点?
参数量小(通常 1M 以下)、计算量小(通常 MACs 每秒 1G 以下)、实时因子小、延时小,在此基础上性能尽可能高。
为什么需要轻量级语音增强模型?
首先大量应用场景能提供的资源有限,且对实时性有要求;再者语音增强常作为音频处理流水线的前端,如果开销、延时过大,则会对系统整体表现产生很大影响。
轻量级语音增强模型面临的挑战体现在哪里?
较小的参数量限制了模型的建模能力,需要设计参数高效的结构,以尽可能少的参数量实现尽可能高的性能。
二、关键结构
在后续分享的论文中大量使用了 U-Net 结构、双路建模结构、深度卷积和逐点卷积,这里先简要对它们进行介绍。
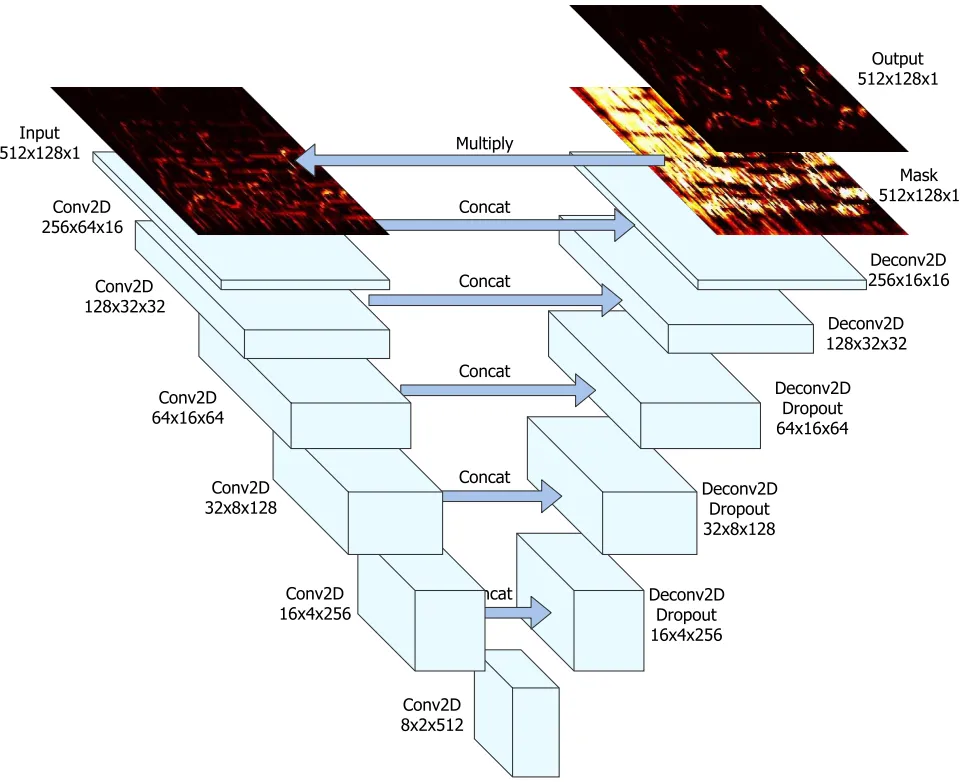
U-Net 结构:语音增强中广泛采用的结构,主要分为 Encoder 和 Decoder 两部分。Encoder 逐步压缩时频谱的时间、频率维度,扩展通道维度,对各种尺度的局部特征进行建模。Decoder 跟 Encoder 对称,同时还包含来自 Encoder 的跳跃连接。采用U-Net 结构可在频率维度上逐步降维,从而压缩开销。
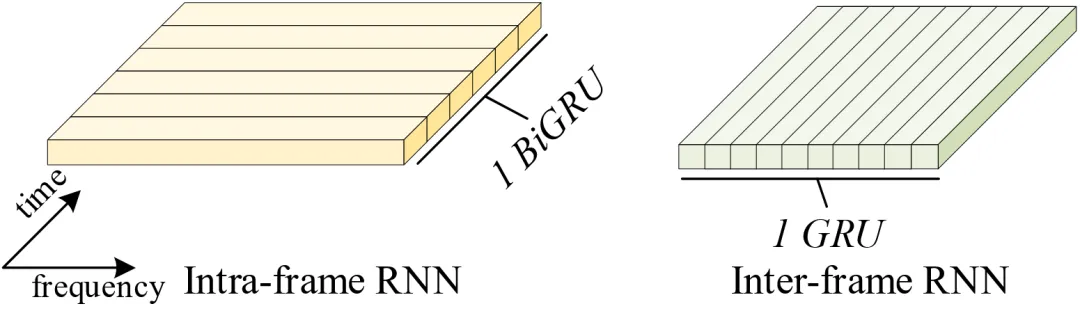
双路建模结构:在时频谱上交替地沿频率维度和时间维度分别进行帧内建模和帧间建模,可对音频特征进行较细致的建模。
深度卷积和逐点卷积:深度卷积单独处理每个通道,用于建模局部信息;逐点卷积则采用 1x1 卷积核,用于改变通道数量。将它们组合起来即可替换普通的卷积以减少参数量和计算量。
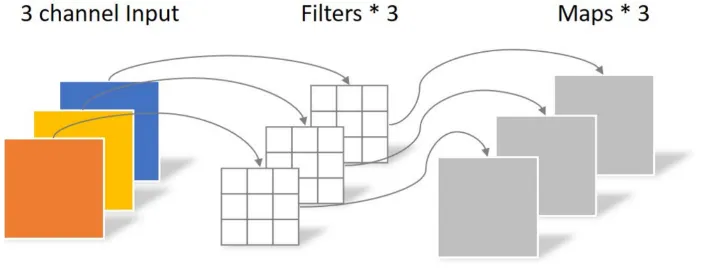
深度卷积
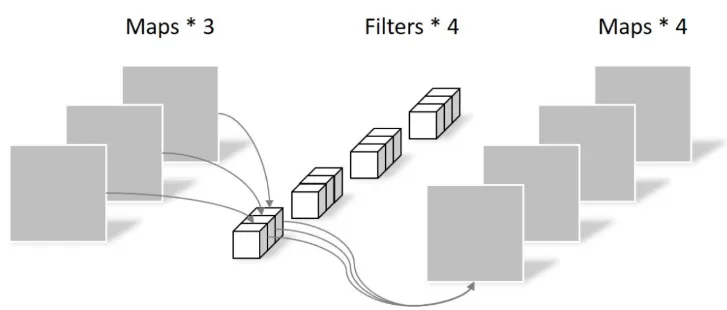
逐点卷积
三、TRU-Net
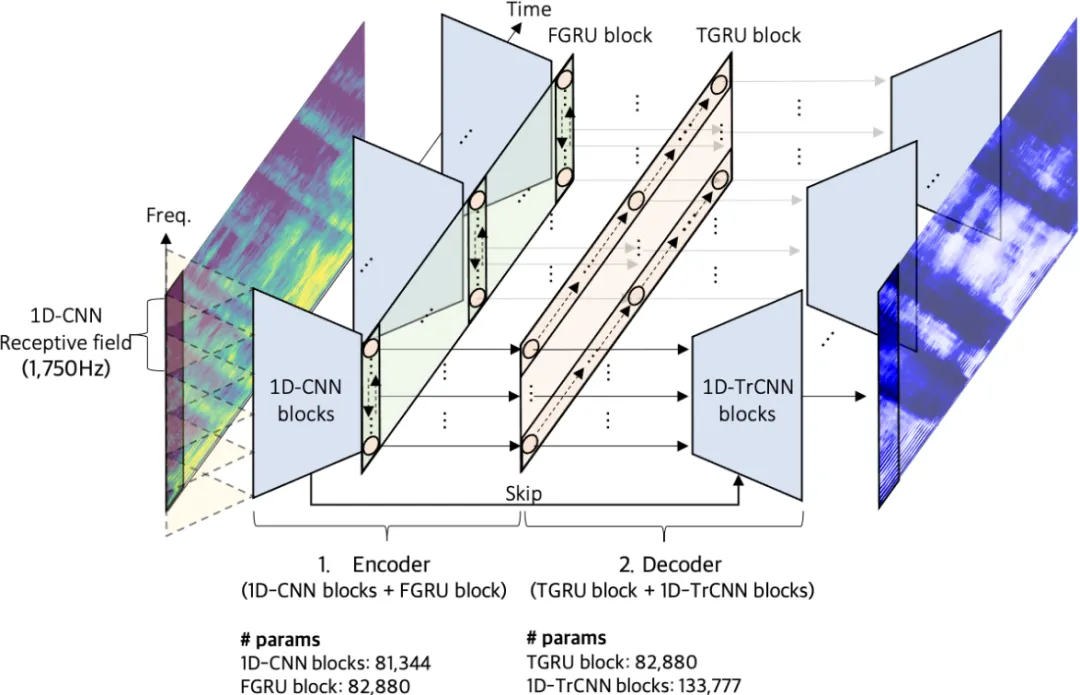
模型结构
特点
TRU-Net 是较早的轻量化语音增强工作,只关注了参数量,没有关注计算量
基于 U-Net,其中卷积块在时间维度上的核大小为 1,在卷积块之后添加了沿频率维度建模的 GRU,同时在卷积块中使用了深度卷积和逐点卷积
将 PCEN(Per-channel energy normalization)特征作为输入的一部分,输入还包括对数幅度谱和相位谱
提出了 PHM(Phase-aware β-sigmoid mask),同时对干净语音、噪声和混响的时频谱复数 mask 进行估计
多尺度的时域和时频域上的损失函数
使用量化
模型轻量化策略
U-Net 结构对频率维度进行压缩
使用卷积块的数量较少,因此使用频率维度上的 GRU 弥补感受野
Encoder 中采用深度卷积和逐点卷积
在 Bottleneck 的建模中各频带共享同一个 GRU
Decoder 中转置卷积层处理前先降低拼接特征的通道维度
四、FSPEN
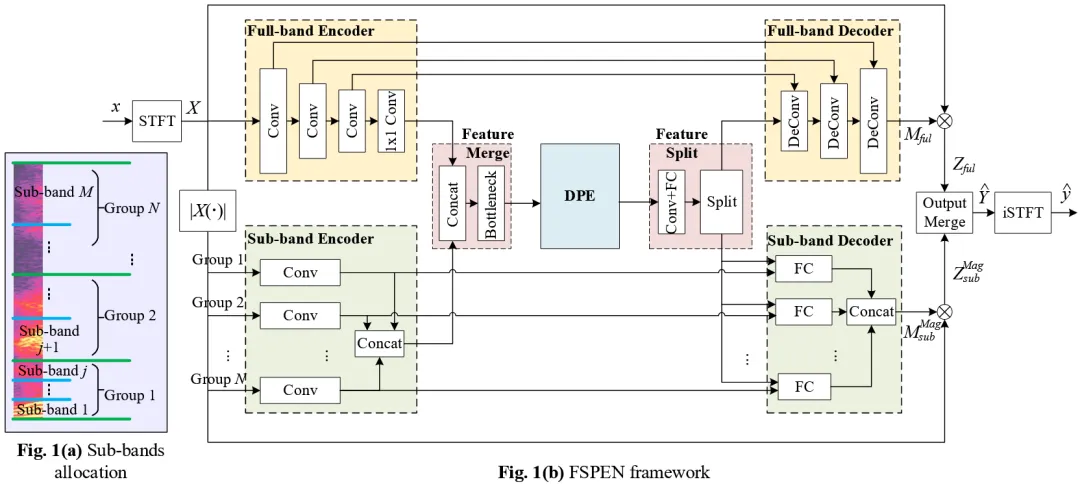
模型结构
特点
以复数时频谱作为输入,预测复数值的 mask,基于 U-Net 和双路建模结构
引入 Full-band Encoder,Sub-band Encoder 分别对全局信息和局部信息进行建模,对应的 Full-band Decoder 和 Sub-band Decoder 分别生成一个 mask 并融合成最终的 mask
双路建模模块引入 path extension,缓解过小的通道维度带来的性能下降问题
多尺度的时频域 MSE loss
模型轻量化策略
U-Net 框架对频率维度进行压缩
Encoder/Decoder 限制卷积层的数量,用 Full-band, Sub-band 建模一定程度上弥补性能
Sub-band 只处理幅度谱输入,且频带划分时同一组频带采用共享的模块
双路建模过程中采用较少的模块数和极小的通道数,用 path extension 弥补性能损失
Decoder 中转置卷积层处理前先降低拼接的特征的通道维度
五、GTCRN
模型结构
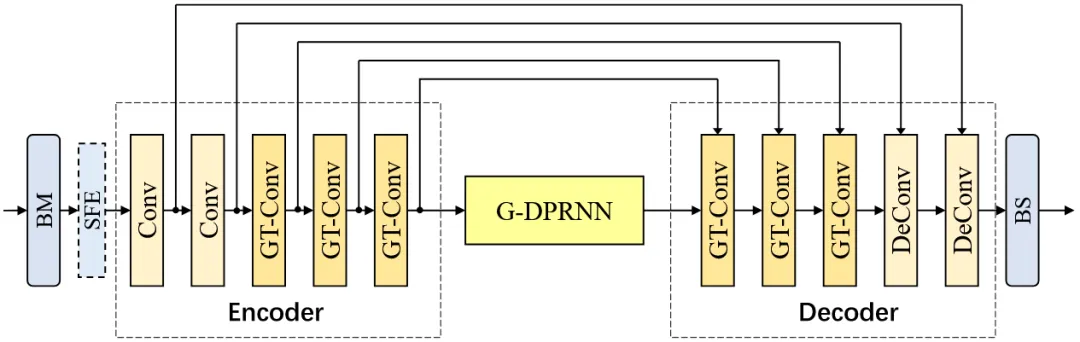
整体结构
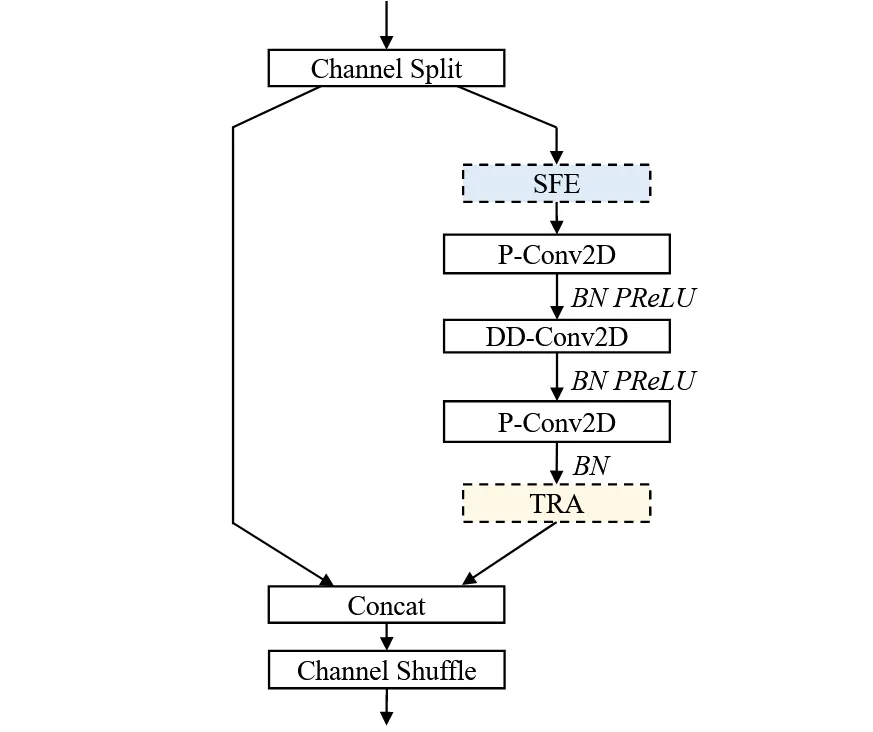
GT-Conv(Grouped temporal convolution block)
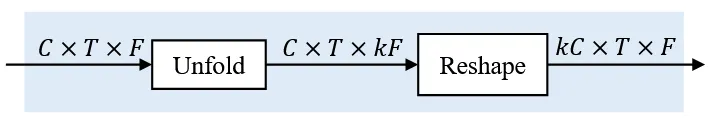
SFE(Subband Feature Extraction)
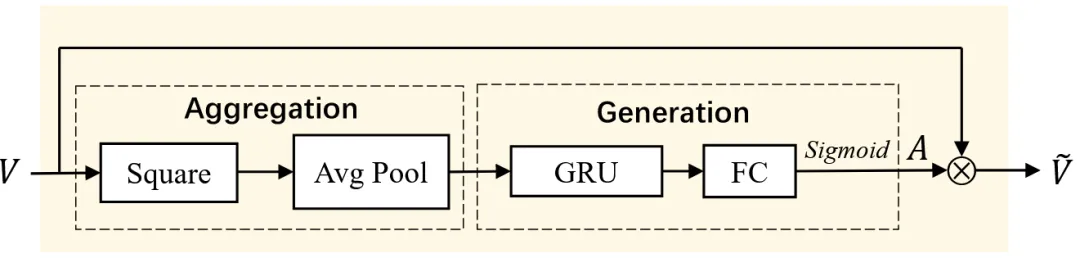
TRA(Temporal Recurrent Attention)
特点
基于 U-Net 框架和双路建模结构,输入复数时频谱和幅度谱,学习目标为复数时频域上的 mask
在最开始的 BM 模块对高频进行压缩,在最后的 BS 模块恢复高频维度
在 Encoder/Decoder 部分采用 GT-Conv 捕获时间维度上的局部依赖关系,同时采用了深度空洞卷积和逐点卷积减少开销
引入 SFE、TRA 以进一步提升性能
时域上的 SI-SNR 损失 + 时频域上的幅度谱、复数谱 MSE
模型轻量化策略
BM 模块压缩高频的操作直接将频率维度大小减少了一半
U-Net 框架对频率维度进行进一步压缩
使用 Group RNN 和 Group Conv
GT-Conv 采用深度卷积和逐点卷积,并且每次只处理一半通道
各个 Conv 模块的输出通道都很小,双路建模处理的通道数也很少
六、LiSenNet
模型结构
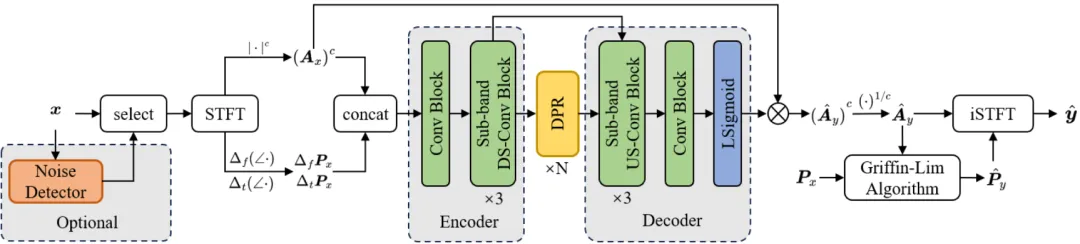
整体结构
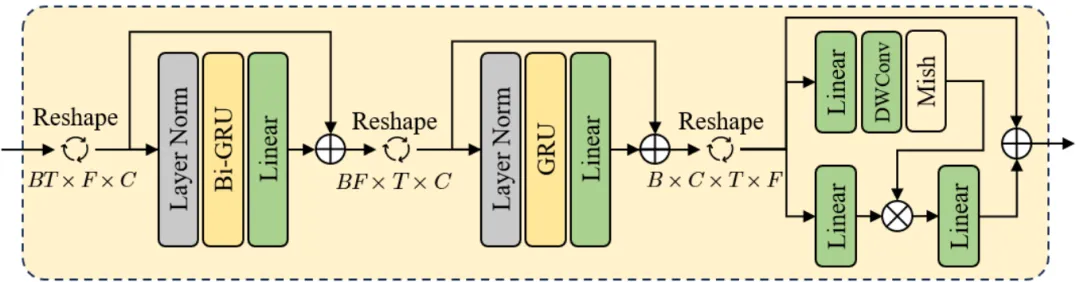
DPR (Dual-Path Recurrent)模块
特点
基于U-Net框架和双路建模结构,以 Phase Difference + 动态范围压缩的幅度谱作为输入,学习的目标是动态范围压缩后的幅度谱 mask
只估计幅度谱,相位由 Griffin-Lim 算法得到
输出 Mask 时采用可学习的 sigmoid,为各个频率学习合适的参数
双路建模模块通道维度过小,使用 ConvGLU 补充通道间的信息交互
可选的噪声检测器
幅度谱和复数谱上的 MSE loss + 可导的 PESQ loss,若引入噪声检测器,还要加上对应的 BCE loss
模型轻量化策略
使用卷积块 3 次压缩高频,将频率维度从 257 压到 32
各个模块采用极小的通道数,并添加额外的模块弥补性能损失
可选的噪声检测器,在稀疏噪声的场景下能大幅降低开销
双路建模模块的数量、GLA 算法的轮数都仅为 2,限制了开销
七、FastEnhancer
模型结构
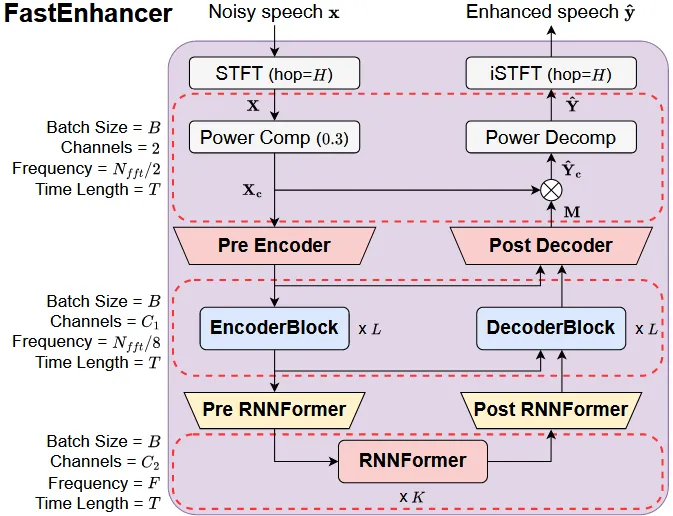
特点
基于 U-Net 框架和双路建模结构,以动态范围压缩后的复数谱作为输入,学习的目标为动态范围压缩后的复数谱 mask
更关注真正的 RTF,而不是参数量和计算量的数值
双路建模中在沿时间维度时采用 RNN ,在沿频率维度时采用多头自注意力
规避了流式 Conv 和自注意力对过往帧进行缓存所需要的 memory 操作,降低了 RTF
采用 BatchNorm 并在推理时把它融合进相邻的层内
幅度谱、复数谱上的 MSE loss + 一致性 loss + 波形信号上的 MAE loss + 可导的 PESQ loss
模型轻量化策略
U-Net 框架对频率维度进行压缩
在双路建模模块前再次对频率维度和通道维度进行压缩
避免复杂 memory 操作,并采用简单的结构,没有在双路建模模块和频带划分这些部分添加过于复杂的操作
八、Lightweight DNN for Full-Band Speech Denoising on Mobile Devices: Exploiting Long and Short Temporal Patterns
模型结构
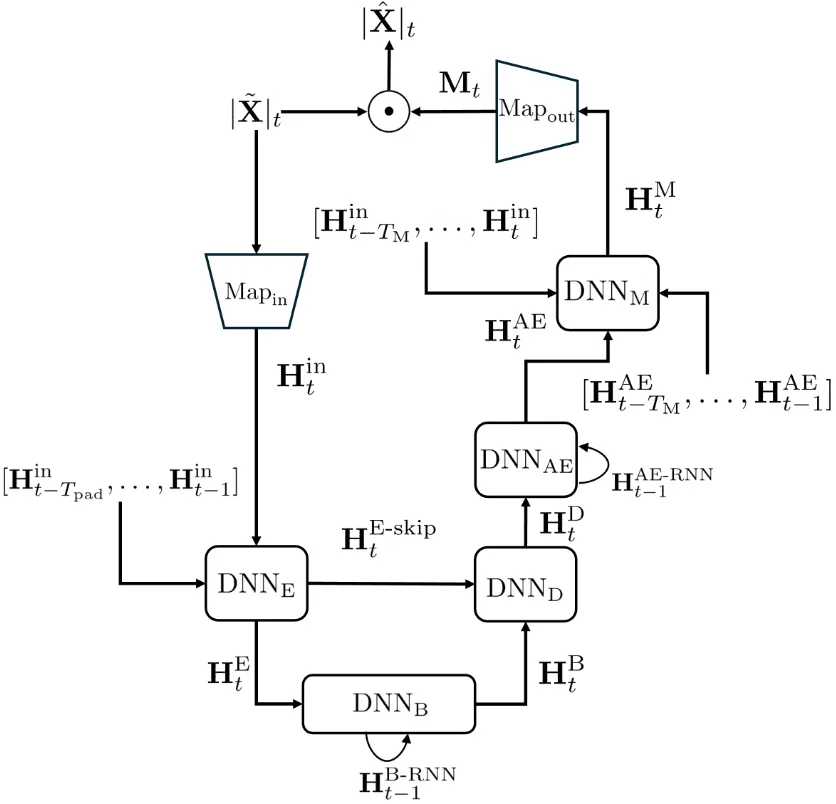
特点
基于 U-Net 框架,输入、输出均不考虑相位,学习的目标是幅度谱的 mask
针对 48 kHz 音频,不会利用任何未来信息
会利用过往帧的信息,对短程时间上文进行建模
Bottleneck 中直接压缩掉频率维度,规避双路建模
在模型最前面用 FNN 暴力地将频率维度压缩 10 倍以上
Bottleneck 部分和 autoencoder 部分对长程时间依赖关系进行建模
计算量很小,只有 6M
采用 SI-SDR loss
模型轻量化策略
在模型最开始的 MAPin 模块直接使用 FNN 将频率维度压缩 10 多倍
U-Net 框架对频率维度进行进一步压缩,又压缩了 16 倍
不会利用未来信息,因此延迟低
Bottlebeck 部分 GRU 处理前先压缩掉频率维度
九、总结
轻量级语音增强模型以其小巧、高效、低延迟的特性,逐步成为端侧音频智能的基石。无论是面向移动设备、嵌入式系统,还是实时通信场景,轻量化不仅是技术的必然趋势,更是用户体验的重要保障。上述模型通过各种方式达成了轻量化的目标,能为新模型的设计与工程实践提供有价值的参考。
供稿 | 周鑫,编辑 | 方楠,审核 | 韩冰
