
 语音小管家
ACL(Annual Meeting of the Association for Computational Linguistics)是计算语言学与自然语言处理(NLP)领域最具影响力的国际学术会议之一,每年汇聚全球顶尖学者、研究机构与工业界专家,共同探讨自然语言处理领域的最新研究成果。本研究由上海交通大学听觉认知与计算声学实验室(AudioCC Lab)联合 VUI Labs 完成,已被ACL 2026 Findings正式接收。本文主张将情感语音合成从「句子级标签」推进到「上下文感知」建模:通过引入说话人的个人经历与对话上下文,让模型理解情感表达背后的因果逻辑,在情感表达的自然度与准确度上取得显著突破。
Beyond Sentence-level Labels: Integrating Conversational Context and Personal Experience for Natural Emotional Expression
作者列表:Haiyang Sun, Chenyang Le, Wei Wang, Leying Zhang, Chuang Li, Bing Han, Chenda Li, Mengxiao Bi, Yanmin Qian
合作单位:上海交通大学,宇生月伴
论文原文:https://huggingface.co/Insects/Emotional-Context-Speech
研究背景与动机
情感文本转语音(Emotional TTS)的目标,是合成出像真人一样自然、富有表现力的语音。然而当前方法对「情感」的定义太粗:要么是单类别离散标签,要么是一句简短指令,都只盯着孤立的一句话,导致模型难以推断情感表达背后的因果逻辑。
相比上面的定义,人类真实情感要复杂得多。认知评价理论(如 Arnold、Lazarus)早已指出:个体对环境的认知,决定了其情感反应——情感从不孤立产生。 比如一个人收到好消息,却碍于场合强作镇定,声音听着平静、底层情感却是开心。看不到上下文,模型就读不懂这种真实表达。
核心视角
🔍 核心视角
不同于以往在「指令/标签」上做文章,本文从认知视角切入,把抽象的「环境认知」重构为两个核心维度:
个人经历(Personal Experience):说话人的历史认知基线——他是谁、有怎样的背景。
对话上下文(Context):当下的交互环境——这句话是在什么情境下说出的。
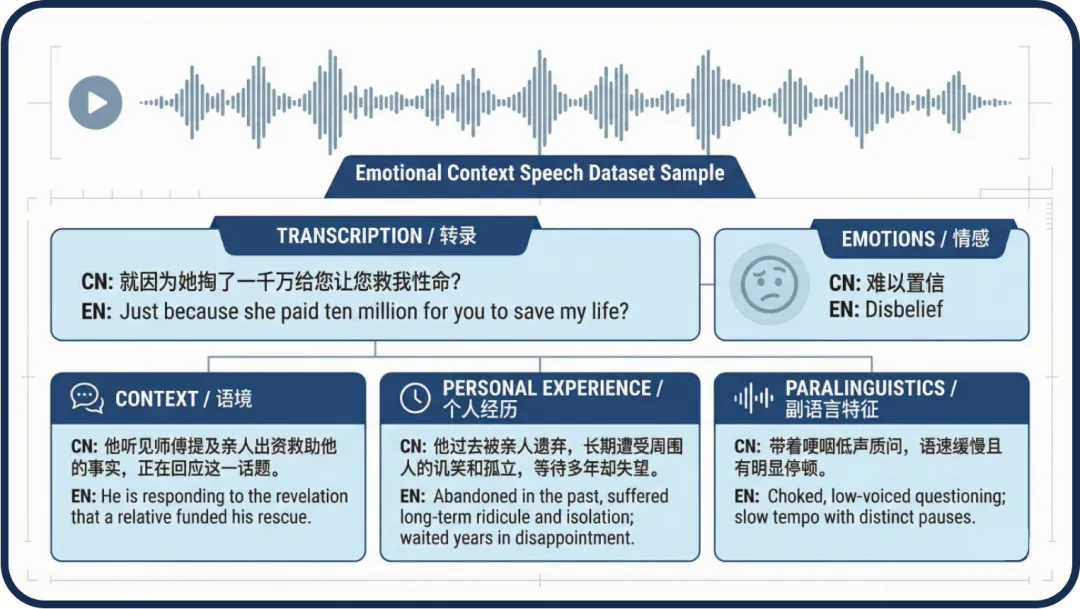
基于此,团队从多说话人广播剧中构建数据集:配音表现力强,且对应的原著小说能提供丰富的人物背景与对话场景。数据样例同时给出对话上下文、个人经历、开放词表情感(OV-Emotion)与副语言描述。
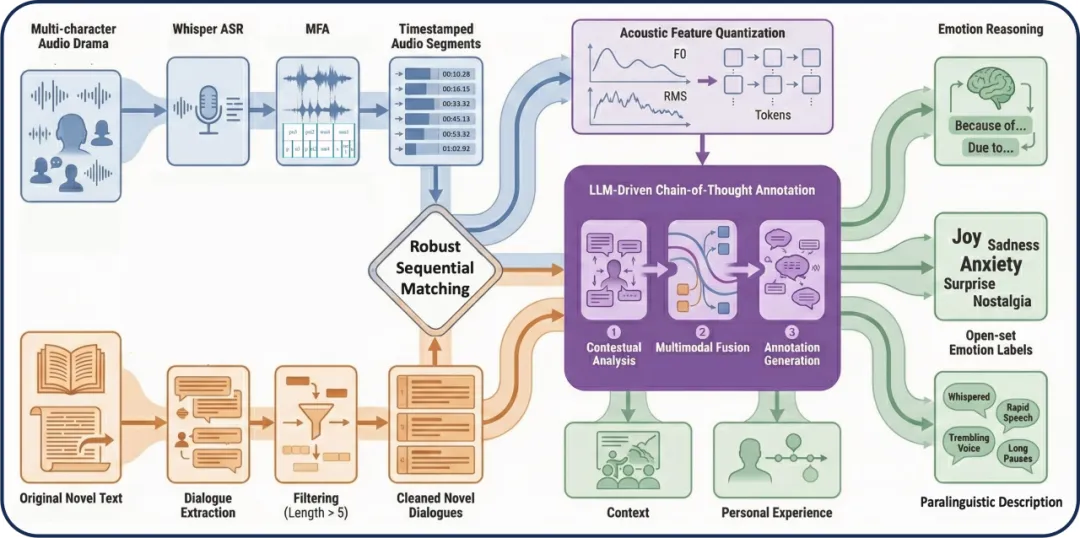
图 1:Emotional-Context-Speech 数据样例,在转写文本之外提供上下文、个人经历、开放词表情感与副语言标注。
数据集:Emotional-Context-Speech
难点在于:LLM 看不到音频里的声学细节,而音频大模型又抓不住情感的因果逻辑。团队设计了一条自动化标注流水线,把可量化的声学特征与文本上下文一起喂给 LLM:
数据对齐:用 Whisper 转写 + MFA 强制对齐获得词级时间戳,再在拼音音素层级把广播剧音频与小说对白做鲁棒顺序匹配。
声学特征量化:将 F0、语速、停顿、谱质心、RMS、HNR 等连续特征离散成整数 token,使文本 LLM 也能「读懂」声学变化。
思维链标注:以 DeepSeek-V3.2 触发 CoT,按「上下文分析 → 多模态融合 → 生成标注」三步,输出情感成因、副语言描述与开放词表情感标签。
最终构建出约 730k 条样本(1335 小时)、覆盖 3359 个情感类别的大规模语料。
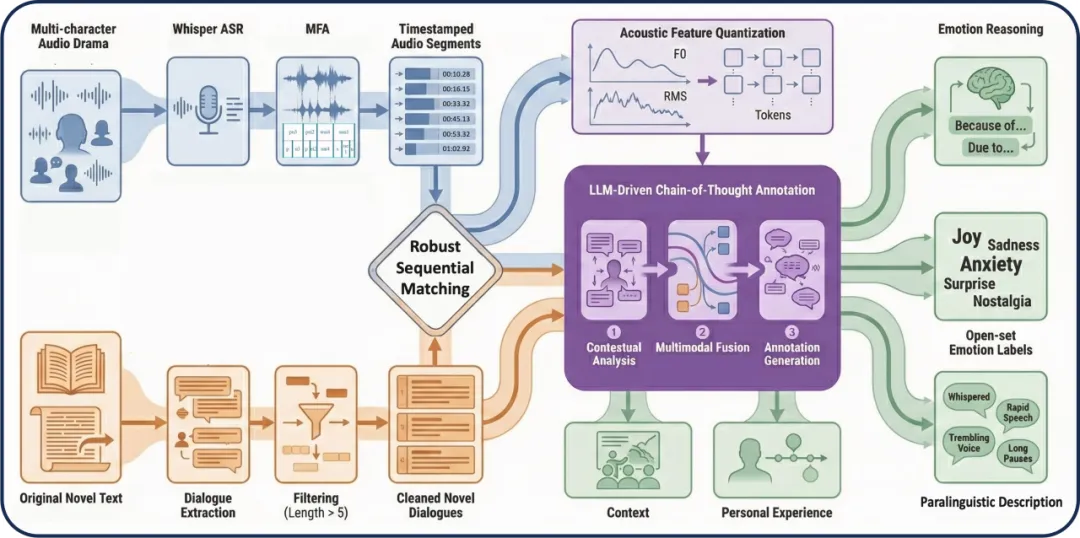
图 2:自动化标注流水线。对齐语音与小说文本后,LLM 结合量化声学特征与叙事上下文生成标注。
模型:Emotional-Context-TTS
传统 TTS 只看文本或一句情感指令,等于逼模型在不懂「情感成因(上下文)」与「主体认知(个人经历)」的情况下硬猜语气。本文基于 CosyVoice2,把生成任务从「仅以文本为条件」扩展为「以文本 + 增强条件集为条件」——将个人经历、上下文、副语言描述、开放词表情感一并作为条件,引导 LLM 预测语义 token,再由原 CFM 解码器与 HiFi-GAN 还原高保真波形。
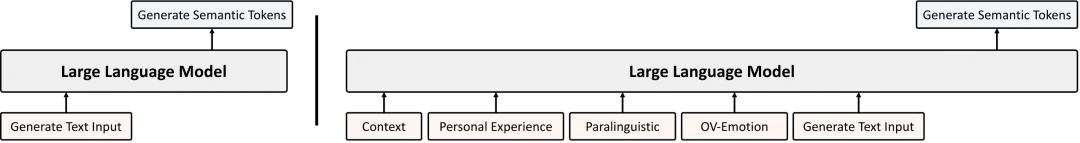
图 3:与传统 TTS 输入方式的对比。引入个人经历、上下文、副语言与开放词表情感后,模型得以捕捉情感表达的底层逻辑。
实验结果
团队在情感表达评测中对比了商业闭源(Gemini 2.5、GPT-4o Audio)与主流开源系统(CosyVoice 2/3、IndexTTS v2、StepAudio、Higgs Audio),采用 Gemini 3 Pro 评分 + 10 名母语者主观打分(1–100)+ 人机辨别率(HA)。
🔍核心发现:
全面领先:Emotional-Context-TTS 人类主观分达 63.9 居首,人机辨别率 51.8% 同样第一,显著超越各基线。
上下文 + 经历确实有效:逐步加入个人经历、上下文、副语言后,自然度、情感准确度与拟真度上升,直接印证核心观点。
评测启示:LLM 评分普遍偏高、方差小,与人类评分存在明显落差——仅靠 LLM 评测不足以衡量情感语音的细腻自然度,严格主观测试不可或缺。
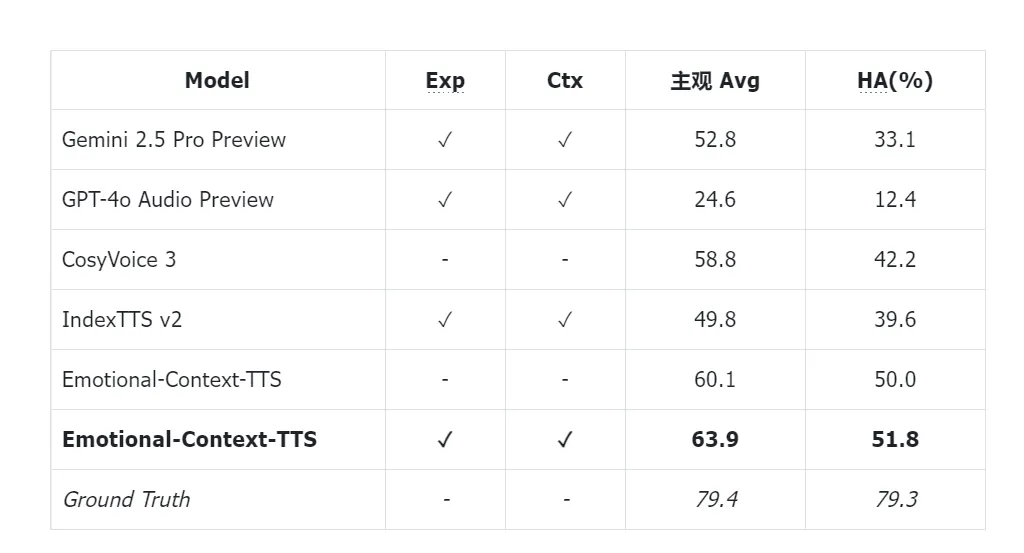
表 1:情感表达自然度评测(主观分与人机辨别率)。最优结果加粗。
此外,声学特征量化在英文IEMOCAP数据集上也为DeepSeek文本模型带来 +2.3% 的情感分类增益:人工验证显示——给标注者提供上下文后,情感标注主观评分显著上升,再次印证「环境认知信息既是 AI 生成的关键,也是人类准确判断情感的前提」。
本文总结
不同于以往在模型架构与算法优化上的迭代,深挖诱发情感的底层逻辑正在成为重塑情感交互的关键。本论文通过设计标注方案,实现了对情感数据资源的深度挖掘。这种向数据中心范式的深刻转变,为构建高性能、高泛化的语音情感大模型提供了全新的探索思路。
参考文献
[1] Du et al. 2024. CosyVoice 2: Scalable Streaming Speech Synthesis with Large Language Models.
[2] Lazarus et al. 1991. Emotion and Adaptation. / Arnold, M. B. 1960. Emotion and Personality.
供稿 | 孙海洋,编辑 | 方楠、张乐莹,审核 | 张王优、钱彦旻
