
声浪

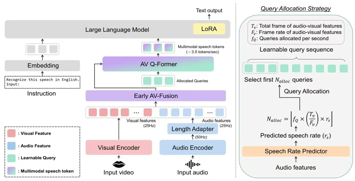
【交我学-18】让机器 “看懂” 声音:AVSR技术如何提升嘈杂环境下语音识别性能

大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…
13 0 0
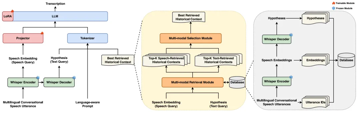
AAAI 2026|MARS:基于多模态检索和选择增强的对话LLM语音识别
随着以智能助手为代表的人机语音对话系统和会议转录与纪要等应用的爆发,对话语音识别(Conversational ASR) 技术变得愈发重要。对话语音(Conversational Speech)具有高度的上下文(Context)相关性,而擅…
23 0 0
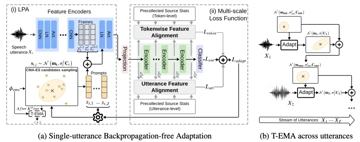
NeurIPS 2025|E-BATS:首个无需反向传播的高效语音 Test-Time Adaptation 框架
⏩背景:真实场景中的语音模型为何会“失灵”? 当前的大型语音基础模型(Speech Foundation Models, SFMs),如Wav2Vec2、HuBERT,在干净数据上表现极佳,但在真实世界中经常碰到噪声、口音、麦克风差异等“声…
28 0 0
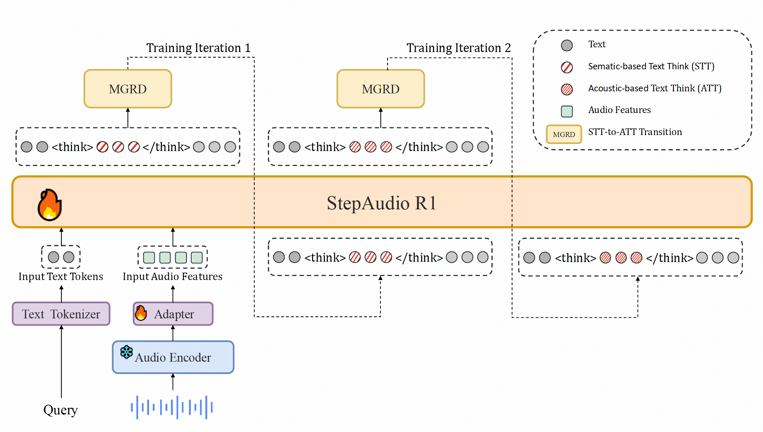
Step-Audio-R1:比肩 Gemini 3 Pro,StepFun 开源首个音频深度推理模型
近年来,以思维链(Chain-of-Thought)为代表的扩展推理技术,在文本和视觉领域取得了巨大成功。然而,在音频领域,一个令人困惑的现象始终存在:音频语言模型似乎无法从思维链中受益,甚至表现出“想得越多,错得越多”的“反常缩放”现象。…
19 0 0
JEDIS-LLM — 短音频训练、长音频流式推理解决说话人日志问题
论文题目:《Train Short, Infer Long: Speech-LLM Enables Zero-Shot Streamable Joint ASR And Diarization On Long Audio》 arXiv链接:…
20 0 0
字节联手港中大,打造TTS语音自然度评估系统,让机器懂人类觉得“自然”的语音
标题:《SpeechJudge: Towards Human-Level Judgment for Speech Naturalness》 论文地址:https://arxiv.org/pdf/2511.07931 项目地址:https:/…
26 0 0
巨人与清华、西工大发布 “视频 x 音乐” 多模态生成新进展
多模态生成技术在图像、视频、语音等方向的快速突破,使 “音乐 × 视频” 的多模态生成变成新的研究热点。然而在真实业务场景中,仍然存在诸多未被充分解决的技术空白,例如: 在音乐驱动的视频生成中,仍缺乏对长时序一致性、音画节奏对齐与镜头运动的…
17 0 0
使用Auden-Voice语音编码器同时捕捉说话人身份与副语言信息
题目:《Auden-Voice: General-Purpose Voice Encoder for Speech and Language Understanding》 地址:https://arxiv.org/pdf/2511.1514…
22 0 0