
 语音小管家
本期分享在刚刚揭晓录用结果的信号处理领域旗舰会议ICASSP 2026上华南理工大学数字孪生人重点实验室的3篇论文,论文方向涵盖了零样本语音合成、指令语音合成、以及非言语发声识别数据集等前沿领域。ICASSP是由电气与电子工程师协会(IEEE)组织的信号处理领域的顶级会议之一,也是全球范围内展示语音、音频及信号处理最先进科技成果的年度盛会。
1.BridgeCode: A Dual Speech Representation Paradigm for Autoregressive Zero-Shot Text-to-Speech Synthesis
论文作者:邢静远,杨茗茹,李志鹏,邢晓芬,徐向民
论文单位:华南理工大学,佛山大学
论文亮点:本文提出了BridgeTTS框架,旨在解决零样本语音合成中生成速度与质量的固有矛盾及监督信号失配问题。核心创新在于提出了双语音表示范式BridgeCode,包含稀疏离散Token与稠密连续特征,并通过SparseBridge与DenseBridge模块实现两者的高保真双向转换。 BridgeTTS利用AR模型以极低的10Hz帧率预测稀疏Token以大幅提升推理速度(RTF仅0.37),随后通过DenseBridge重构富含信息的连续特征以确保合成的高保真度。此外,论文改进了训练范式,联合优化Token级交叉熵损失与特征级MSE损失,提供了细粒度的声学层级监督,有效解决了传统离散Token预测中的声学相似性忽略问题。
论文简介:自回归(AR)框架最近通过利用离散语音标记和大型语言模型技术,在零样本文本到语音(TTS)领域取得了显著进展。尽管取得了成功,现有的基于 AR 的零样本 TTS 系统仍面临两个关键限制:(i)固有的速度–质量权衡,因为顺序生成标记要么以降低帧率为代价牺牲表现力,要么以增加标记的丰富度为代价降低效率;(ii)面向文本的监督不匹配,因为交叉熵损失对标记错误的惩罚是均匀的,没有考虑相邻标记之间细粒度的声学相似性。为了解决这些挑战,本文提出了 BridgeTTS,这是一种基于双语音表示范式 BridgeCode 的新型 AR-TTS 框架。 BridgeTTS 通过预测稀疏标记同时重建丰富的连续特征来减少 AR 迭代次数,从而实现快速且高质量合成。联合优化标记级和特征级目标进一步提升了自然度和可懂度。
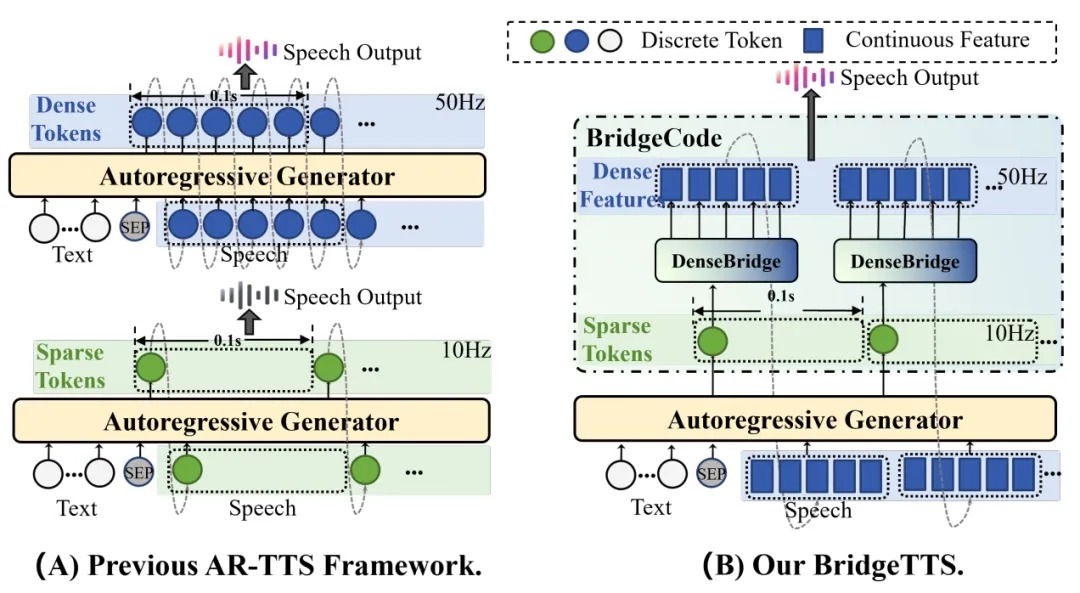
图1 BridgeCode模型与先前AR-TTS范式对比
2.HD-PPT: Hierarchical Decoding of Content- and Prompt-Preference Tokens for Instruction-based TTS
论文作者:聂思航,邢晓芬,邢静远,刘柏基,徐向民
论文单位:华南理工大学,趣丸科技,佛山大学
论文亮点:本文将指令式TTS重构为层次化解码任务,核心在于通过自研编解码器提取受ASR和CLAP监督的“内容偏好”与“提示偏好”token,再用于指令TTS过程,有效弥合了单一文本指令与复杂语音token间的模态鸿沟。该架构实现了语义捕获与风格控制的精准统一,配合“语义-风格-声学”的层次化推理策略,在指令遵循度与语音自然度上均达到SOTA水平。
论文简介:基于大语言模型(LLM)的语音合成(TTS)模型已经达到了极高的自然度,然而TTS推理的精确控制仍然具有挑战性。尽管目前已提出基于指令的语音合成(Instruct-TTS)模型,但由于单层文本指令与多级语音token之间的模态间隙,这些模型仍缺乏细粒度的控制能力。为了解决这一局限性,本文提出了HD-PPT,这是一个将语音合成转化为结构化、层次化任务的框架。为了实现细粒度控制,我们引入了一种新型语音编解码器,在自动语音识别(ASR)和跨语言音频文本预训练(CLAP)目标的监督下,从复杂的语音token中提取出独特的“内容偏好”和“提示偏好”token。为了弥补这些token间的模态鸿沟,我们提出了一种层次化解码策略,引导LLM按结构化顺序生成token:先确立语义基础,再渲染细粒度风格,最后生成完整的声学表示。实验结果表明,这种层次化范式在指令遵从能力和自然度上均达到了SOTA水平,验证了本文所提出的精确且可控TTS方法的有效性。
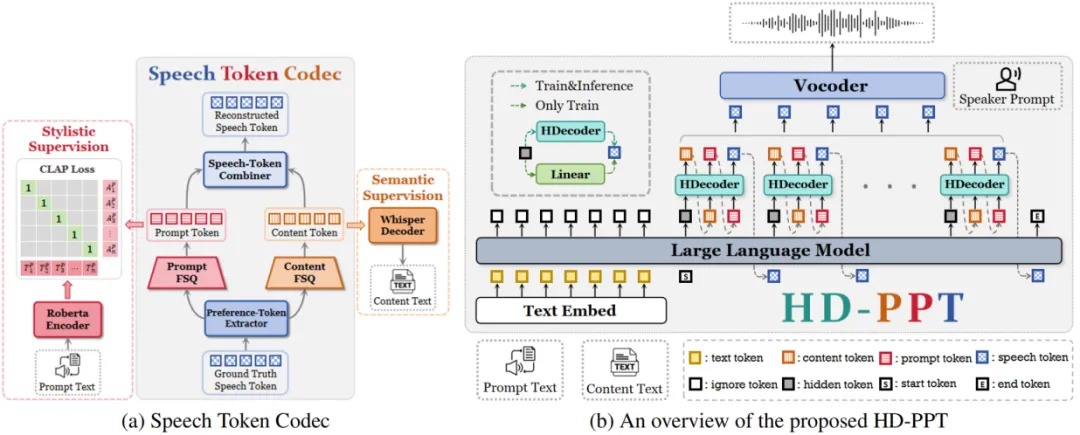
图2 HD-PPT模型框架图
论文:https://arxiv.org/abs/2509.19001
Demo:https://xxh333.github.io/
3.MNV-17: A High-Quality Performative Mandarin Dataset for Nonverbal Vocalization Recognition in Speech
论文作者:麦家龙,季金鑫,邢晓芬,杨晨,陈炜东,邢静远,徐向民
论文单位:华南理工大学,香港理工大学,同济大学,上海交通大学,香港中文大学,佛山大学
论文亮点:MNV-17作为首个高质量、类别丰富的中文非语言发声数据集,通过表演式构建方法,为解决当前ASR系统无法感知NV的问题提供了关键资源。我们的实验证明,我们能够在不损害原有能力的情况下,在ASR系统中集成NV识别能力。我们的模型能够在NV-ASR领域实现跨域、跨语种的泛化识别。
论文简介:尽管自动语音识别(ASR)技术已日趋成熟,但在理解叹气、笑声等非语言发声(Non-Verbal vocalizations, NVs)方面仍存在显著短板,导致人机交互缺乏“人情味”。现有研究受限于数据稀缺、自动挖掘数据的低质量及严重的类别不平衡问题。为了解决这些痛点,本文提出了 MNV-17——首个高质量、类别丰富且分布均衡的中文NV数据集。
MNV-17 采用“表演式构建”范式,通过 Gemini 2.5 Pro 辅助生成自然语境脚本,并由49位专业录音环境下的发音人录制,涵盖了目前公开数据集中最广泛的 17种NV类别(如咳嗽、轻笑、鼓掌等)。该数据集通过严格的脚本设计与多模态大模型辅助切分,实现了极佳的类别平衡性。在 SenseVoice, Paraformer, Qwen2-Audio 及 Qwen2.5-Omni 等四种主流架构上的实验表明:(1) 大型自回归模型(如 Qwen2.5-Omni)在文本与NV联合识别任务中表现卓越;(2) 多任务预训练是激活模型NV感知能力的关键;(3) 引入NV识别任务不仅未损害ASR的纯文本转写性能,反而通过上下文协同效应实现了性能增强。
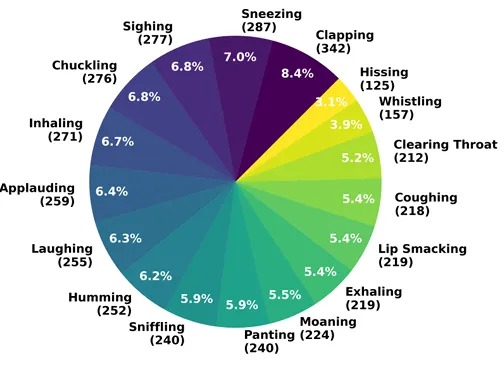
图3 MNV-17的NV类别分布图
