
声浪

字节吴永辉&王雨轩联合署名:首个端到端语音大模型副语言评估基准与调优框架 ParaS2S

论文标题:ParaS2S: Benchmarking and Aligning Spoken Language Models for Paralinguistic-aware Speech-to-Speech Interaction 论文地…
15 0 0
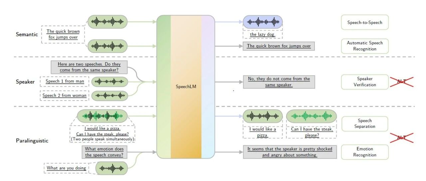
超越级联系统:端到端语音大模型设计解析
虽然文本大语言模型最近取得了很多的关注,但是对于人类而言,语音交互是更自然的方式。在语音交互常见中一个直接的方法是直接级联ASR-LLM-TTS这三个模型,然而这种直接的方式存在诸多问题。为了解决级联系统的问题端到端的语音大模型(Speec…
29 0 0
AAAI 2026丨NPU-ASLP实验室3篇轮用论文分享
AAAI 2026(AAAI Conference on Artificial Intelligence)将于2026年1月20-27日在新加坡举行,会议重点聚焦人工智能领域的前沿进展与跨学科应用,旨在为全球学术界与产业界的研究者提供一个深…
21 0 0
如何给AI一双“懂节奏”的耳朵?
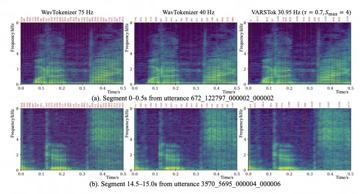
如何将一段连续的、信息密度不均的波形,变成一串 AI 能够理解和处理的“密码”?关键在于语音分词器——它就像是 AI 的“语音耳朵”,负责将声音信号转换成离散的符号序列。 然而,现有的语音分词器大多采用固定帧率,比如每秒生成 75 个 to…
19 0 0
复杂场景语音识别新突破:SAP²技术精准剪枝,提升长上下文场景ASR性能
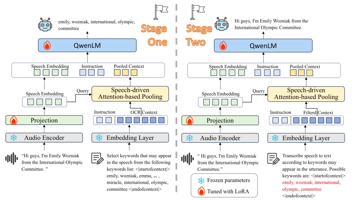
来源丨乐百一家 论文题目:《Speech-Aware Long Context Pruning and Integration for Contextualized ASR》 论文地址:https://arxiv.org/pdf/2511.…
11 0 0
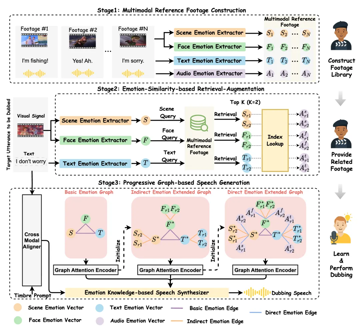
AAAI2026丨IMU语音理解与生成实验室最新表现力视频配音工作分享
近日,人工智能领域的顶级国际会议——AAAI 2026(The 40th Annual AAAI Conference on Artificial Intelligence)正式公布了论文录用结果。IMU语音理解与生成实验室最新表现力视频配…
9 0 0
开源!MeanVC — 基于平均流的轻量级流式零样本语音转换
零样本语音转换(Zero-shot VC)旨在保留语音语言内容的同时,将源说话人音色迁移至任意未见过的目标说话人。日益丰富的应用场景对模型的流式推理能力提出迫切需求,亟需兼具快速、轻量与高保真特性的解决方案。然而现有流式方法依赖自回归(AR…
20 0 0