
 语音小管家
标题:Synthetic Singers A Review of Deep-Learning-based Singing Voice Synthesis Approaches
链接:https://arxiv.org/pdf/2601.13910
作者单位:浙江大学
发表日期:2026年1月20日
说明:Accepetd by IJCNLP-AACL 2025(Oral)
01、引言:先搞懂SVS是啥,发展到哪了
02、SVS的四大核心任务:每类都有代表性模型
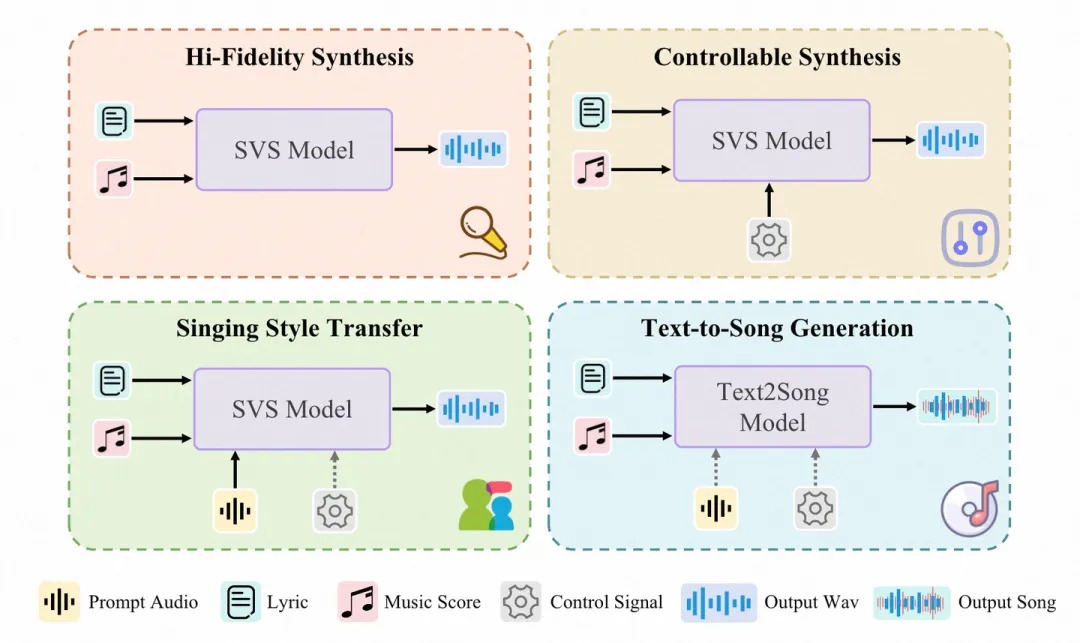
XiaoiceSing(2020):把TTS里的FastSpeech架构改了,加了“音符时长”、“音高”约束,保证跟乐谱对齐;
HiFiSinger(2020):又把XiaoiceSing的vocoder换成了Parallel WaveGAN,一下子把音质提上去了;
DiffSinger(2022):用了“浅层扩散DDPM”技术,解决了Transformer模型常见的“过平滑”问题——合成的歌声频谱细节更多,更自然;
RMSSinger(2023):专门优化音高(F0),用扩散模型做音高建模,F0轨迹更准;
SiFiSinger(2024):加了个“源模块”,能生成受F0控制的激励信号,音高控制更精细;
还有用“一致性模型”的(比如Ye等人2023):兼顾效率和质量,生成速度快还保真。
MuSE-SVS(2023):支持多歌手,还能选情感,比如“欢快”、“悲伤”,音色切换很自然;
Song等人(2022):专门控颤音,能调颤音的频率、强度,让歌声更有表现力;
SinTechSVS(2024):用“注意力局部评分模块”建模演唱技巧,比如滑音、转音,控得更细;
PromptSinger(2024):靠自然语言prompt控制——比如输入“像王菲一样轻柔的音色,中等响度”,就能生成对应效果,不用调复杂参数;
TechSinger(2025):用“无分类器引导”技术,把技巧控制得更精准,比如指定“弱起音”,误差率比之前低30%;
还有特定风格模型:比如FreeStyler专门生成说唱,SongSong做古典艺术歌曲,风格辨识度很高。
早期用“残差向量量化(RVQ)”抓风格(Shen等人2024),但稳定性一般;
TCSinger(2024):换成“聚类向量量化(CVQ)”,风格压缩更稳,还加了语言模型(LM)一起建模韵律和风格,迁移后歌声更连贯;
ExpressiveSinger(2024):用“级联扩散控制模块”,表现力更强,比如迁移“哭腔”风格,情感还原度更高;
语音转歌声(STS):因为歌手数据少,就用语音数据转——Li等人2023先做了基础框架,Dai等人2025又优化了,音乐性和风格保真度提升了25%;
TCSinger2(2025):用对比学习+混合专家(MoE)架构,把“可控合成”和“风格迁移”整合到一个框架里,不用分开训,效率高还省数据。
SongGen(2025):用单阶段自回归Transformer,直接从文本出歌,不用分步;
YuE(2025):基于LLaMA2,加了“结构渐进条件”,解决长音频生成的“断连”问题,能生成3分钟以上的歌;
DiffRhythm/MuDiT(2024-2025):用DiT(扩散Transformer)做非自回归生成,速度比自回归快5倍;
Levo(2025):加了“混合token”和“直接偏好优化(DPO)”,能对齐用户偏好(比如“更欢快的节奏”),音乐性评分高18%。
03、SVS的两大架构:级联vs端到端
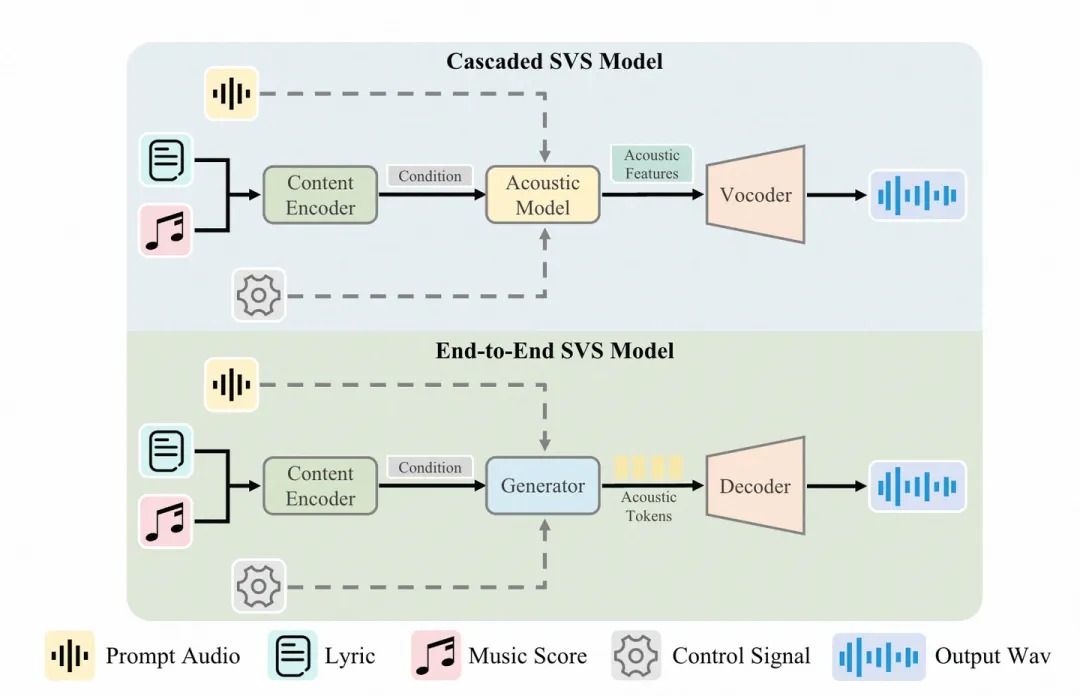
声学模型:负责把乐谱转成声学特征,关键创新点:
早期:HiFiSinger用非自回归,ByteSing用Tacotron式自回归;
DeepSinger(2020):用前馈Transformer,还训了大量网上的歌声数据,泛化性好;
WeSinger(2022):加了数据增强,把Mel谱换成LPC特征,音准准确率提了10%;
扩散模型:DiffSinger用“条件扩散”从高斯噪声重建Mel谱,保真度高;RMSSinger用扩散做音高预测,F0误差降了25%;
流匹配:TechSinger(2025)用流匹配做声学模型,生成速度比扩散快3倍,还更稳。
Vocoder:把声学特征转成波形,早期是Griffin-Lim、WORLD,现在都用神经vocoder:
自回归:WaveRNN(常用,但慢);
非自回归:HiFi-GAN、BigVGAN(最常用,保真度高,速度快);
定制化:Huang等人2021做了SVS专属vocoder,能更好还原演唱技巧(比如颤音)。
VISinger(2022):第一个把VITS(端到端TTS架构)用到SVS,实现全端到端;
VISinger2(2023):加了DSP技术,把采样率提上去,音质比VISinger高一个档次,MOS评分从4.2涨到4.6;
SiFiSinger(2024):扩展VISinger,加了“源模块”生成F0控制的激励信号,音高控制更准;
UniSyn(2023):用多条件VAE,能灵活控音色、风格,比如“换歌手但保留原风格”;
CSSinger(2025):做了半流式框架,基于VAE做流式合成,延迟从500ms降到100ms,适合实时场景;
神经编解码器方案:Hwang等人2025(HiddenSinger)、Wu等人2024(TokSing),用离散token做中间表征,兼顾效率和保真。
04、核心技术:表征建模+控制技巧
内容表征(唱什么、什么时候唱):
基础:用G2P(拼音转音素)得到音素序列,再融合乐谱信息(MIDI音高、音符时长); 解决痛点: 节奏映射/花腔:用“外部强制对齐”(He等人2022)、“可学习单调对齐+随机时长预测”(VISinger)、“可学习上采样”(RMSSinger); 稳定性:最近用RL优化感知目标(Li等人2025)、“掩码token”稳定对齐(TCSinger2),对齐误差降了30%。
声学表征(谁来唱):
传统:级联模型用Mel谱、F0、UV(有声/无声标记)这些手工特征,好优化但细节少; 现在用“学习到的latent表征”: 离散latent:用RVQ做神经编解码器,比如HiddenSinger用堆叠RVQ,token更紧凑;TokSing融合VQ-VAE、RVQ和SSL嵌入,细节更多; 连续latent:用VAE/RQ-VAE做多层级结构,比如UniSyn用多条件VAE解耦“歌手”和“风格”,切换歌手时风格不跑偏; 新方向:加对比学习做“风格感知的声学token”(TCSinger2),风格迁移准确率提了20%。
语义表征(怎么唱):
早期:用SVM、HMM+手工特征,效果差; 现在用预训练语音编码器:wav2vec 2.0(抓情感)、HuBERT(抓韵律)、WavLM(抗噪声,效果最好); 新方向:LLM接口,比如SeCap(2024)用Q-Former把语音转成风格感知token,给LLaMA用,能理解更复杂的语义(比如“像歌剧一样的咬字”)。
基于音频的风格迁移(用参考音频调风格):
早期:GST(2018)解耦韵律,Attentron(2020)用注意力提韵律,Li等人2021用多尺度参考编码器抓音素级风格; 非自回归:Styler(2021)解耦风格组件,Mega-TTS(2024)用latent LM建模韵律分布,风格迁移更自然; SVS专属:加“风格适配器”“自适应解码器”(Zhang等人2024b),多歌手迁移时音色更准; 歌声转换:解耦参考音频的“内容/节奏/音色”,再融合做零样本迁移(Li等人2023、Dai等人2025),迁移相似度MOS从3.5涨到4.3。
基于文本的风格控制(用文字/prompt调):
拼接特征:PromptSinger在多尺度Transformer里拼风格特征,控音色、情感、响度; 注意力模块:SinTechSVS加“注意力局部评分模块”,控技巧更细; 交叉注意力:Lyth等人2024用交叉注意力建模歌手风格/情感,不用参考音频; 自适应归一化:调制中间激活信号,轻量还能跟注意力结合(Versband); CFG控制:TechSinger用“无分类器引导”, inference时能调风格强度(比如“风格权重0.8”); MoE控制器:TCSinger2用MoE选“风格专家”,控制精度高还不影响保真度。
05、资源支撑:数据集、标注工具、评估指标
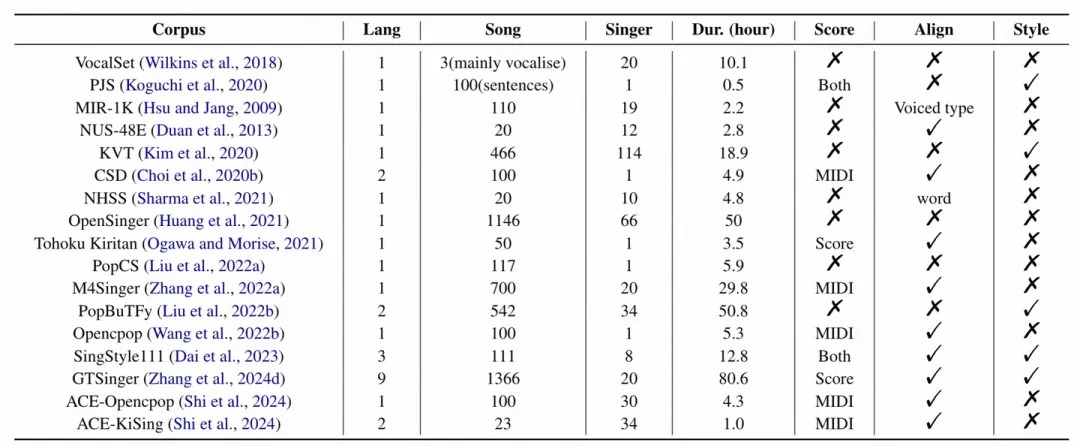
VocalSet(2018):早期波形拼接用的,只有孤立音素,不适合自然SVS;
MIR-1K(2009)/PopBuTFy(2022)/NHSS(2021):研究语音-歌声关系,适合做STS任务;
NUS-48E(2013):第一个有音素对齐的,启发了后来的中文数据集;
带乐谱标注的:PJS(2020,日文)、Tohoku Kiritan(2021,日文)、M4Singer(2022,中文,29.8小时)、Opencpop(2022,中文,MIDI标注);
定制化数据集:
KVT(2020):114个歌手,音色多样,适合多歌手模型; SingStyle111(2023):3种语言+风格标注,适合风格迁移; GTSinger(2024):9种语言、80小时,带乐谱,目前最适合多语言SVS;
合成数据集:ACE-Opencpop/ACE-KiSing(2024),用合成数据做增强,解决真实数据少的问题。
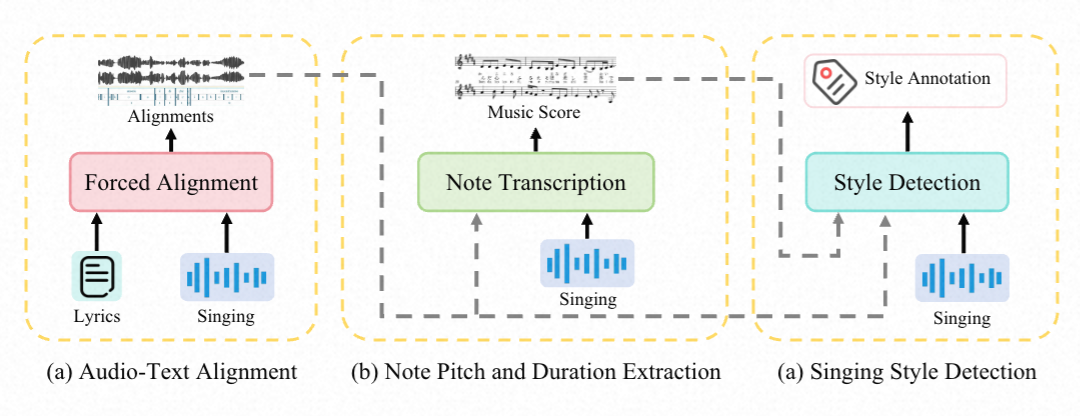
(a) 音频-文本对齐:手动用Praat,自动用MFA(HMM-based,干净 vocals 效果好),更优的是SOFA(CTC损失的对齐器,准确率比MFA高15%);
(b) 音符音高/时长提取:基础用Parselmouth,高精度用ROSVOT(Conformer backbone,音高误差降20%)、MusicYOLO(用YOLO检测音高+时长,一起出结果,效率高);
(c) 歌声风格标注:早期手动,现在用端到端多任务框架(Guo等人2025c),能自动标“风格类型”、“情感强度”,标注效率提3倍。
准确性:
歌词:用CER(字符错误率),比如PromptSinger的CER低于5%; 音高:FFE(F0帧错误率,RMSSinger低于8%)、RMSE(均方根误差,DiffSinger低于5Hz)、F0相关系数(WeSinger高于0.92); 时长:Duration RMSE/MAE(VISinger2低于10ms)、时长预测准确率(高于90%)。
表现力&自然度:
主观:MOS(HiFiSinger 4.5,VISinger2 4.6); 客观:SingMOS数据集训预测器(Tang等人2024)、VoiceMOS挑战(测SVS质量)、MLLM评估(用LLaMA评情感还原度)、RL奖励(Levo用DPO对齐偏好)、歌声深度伪造检测(Zhang等人2024a,越难检测说明越真实)。
音质:
PESQ(HiFiSinger 3.8,比传统模型高0.5)、SNR(高于25dB); 频谱差异:MCD(DiffSinger低于10dB)、BFCC(WeSinger低于8dB)。
相似度:
主观:MOS-S(风格迁移相似度,TCSinger2 4.4)、AXY测试(选更像参考的样本,TCSinger2准确率75%); 客观:说话人嵌入余弦相似度(用x-vector/d-vector,HiddenSinger高于0.85)。
可控性:
主观:MOS-C(控效果评分,PromptSinger 4.3); 客观:属性预测模型的准确率/F1(比如情感识别准确率,ExpressiveSinger高于88%)。
06、创新点:这篇综述的核心价值
分类体系清晰:任务分4类,架构分2种,核心技术拆“表征+控制”,比以前的综述更系统,能快速定位研究方向;
挖深核心技术:比如“离散vs连续latent”的对比、“MLLM的作用”,这些是最新的研究热点,以前没人总结过;
资源全且新:数据集表1覆盖到2024年的GTSinger,标注工具包含MusicYOLO这种新工具,评估指标连“深度伪造检测”都包含了;
附录补全细节:附录讲了训练策略(数据增强、预训练微调、多阶段训练)和推理加速(DDIM、DPM-Solver、流匹配积分器),还专门讲了MLLM对SVS的6大贡献(数据标注、内容生成、表现力引导、歌曲生成、跨模态对齐、评估),这是最亮眼的——比如MLLM能自动标风格、写歌词、评歌声质量,直接推动SVS往“智能定制”方向走。
07、结论&声明
数据授权:用公开数据集要遵守许可证,爬网上的歌声要授权; 模型滥用:别用SVS模仿歌手做未授权内容,建议加水印保护歌手权益。
