
声浪

性能比肩Gemini 3 Pro!昨晚,阿里千问最强模型来了

来源丨机器之心 1 月 26 日深夜,阿里千问旗舰推理模型 Qwen3-Max-Thinking 正式上线。 该模型在科学知识(GPQA Diamond)、数学推理(IMO-AnswerBench)、代码编程(LiveCodeBench)等…
28 0 0
基于深度学习的歌声合成方法综述
标题:Synthetic Singers A Review of Deep-Learning-based Singing Voice Synthesis Approaches 链接:https://arxiv.org/pdf/2601.13…
19 0 0
ICASSP 2026丨华工数字孪生人重点实验室3篇录用论文分享
本期分享在刚刚揭晓录用结果的信号处理领域旗舰会议ICASSP 2026上华南理工大学数字孪生人重点实验室的3篇论文,论文方向涵盖了零样本语音合成、指令语音合成、以及非言语发声识别数据集等前沿领域。ICASSP是由电气与电子工程师协会(IEE…
20 0 0
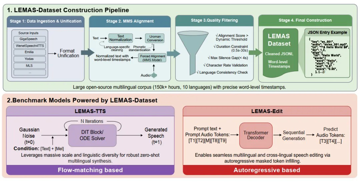
IDEA研究院开源LEMAS:15万小时多语言数据集与两大生成模型,解决多语言语音生成痛点
标题: LEMAS: A 150K-Hour Large-scale Extensible Multilingual Audio Suite with Generative Speech Models 链接: https://arxiv.o…
20 0 0
ICASSP2026丨西工大音频语音与语言处理研究组8篇录用论文分享
近日,IEEE 国际声学、语音与信号处理会议(ICASSP 2026)公布了论文录用结果。本期分享西工大音频语音与语言处理研究组(ASLP@NPU)中稿的8篇论文,涉及智能语音处理领域的众多研究方向。以下是本届会议发表论文的相关信息,附带论…
32 0 0
从开源VibeVoice-ASR看语音模型的设计、数据、幻觉和未来
最近,微软开源了VibeVoice-ASR,我也第一时间进行了体验。首先,对微软团队开源这个模型表示感谢。尽管在测试过程中发现了一些问题,但任何开源工作都值得尊重。作为开源工作,我们没有任何理由要求太多,这些问题也都是可以解决的,况且微调代…
23 0 0
听力和智商只能选一个?TARS对齐框架解决语音大模型降智问题
论文题目: Closing the Modality Reasoning Gap for Speech Large Language Models 论文链接: https://arxiv.org/abs/2601.05543 从 GPT-4…
27 0 0
ICASSP 2026丨智能语音信息处理团队18篇录用论文分享
近日,IEEE 国际声学、语音与信号处理会议(ICASSP 2026)公布了论文录用结果。本期分享语音及语言信息处理国家工程研究中心智能语音信息处理团队中稿的18篇论文,论文方向涵盖语音识别、语音合成、话者识别、语音增强、情感识别、声音事件…
31 0 0