
 语音小管家
数秒克隆语音早已不新鲜,但能覆盖600+语种的语音克隆 TTS 模型,今天终于来了! 此前,音色克隆 TTS 的多语言支持最多停留在几十种语言,低资源小语种始终难以覆盖。小米 AI 实验室新一代 Kaldi 团队重磅推出 OmniVoice,用创新的极简 TTS 架构解决了这一行业痛点,在中英文上达到顶尖性能的同时,在多语言任务上展现出超越商用系统的实力,以及对低资源小语种极强的泛化能力。OmniVoice 的训练、推理代码以及模型权重已全部开源,欢迎大家体验。
论文:https://arxiv.org/abs/2604.00688(了解技术细节) Github:https://github.com/k2-fsa/OmniVoice(含完整训练、推理代码) 语音样本展示:https://zhu-han.github.io/omnivoice(直观感受语音合成效果) Huggingface Demo Space:https://huggingface.co/spaces/k2-fsa/OmniVoice(无需代码一键试用) Huggingface Model:https://huggingface.co/k2-fsa/OmniVoice(模型权重直接调用)
下面将对 OmniVoice 进行详细拆解。
⏩一、极简的超强非自回归 TTS 架构
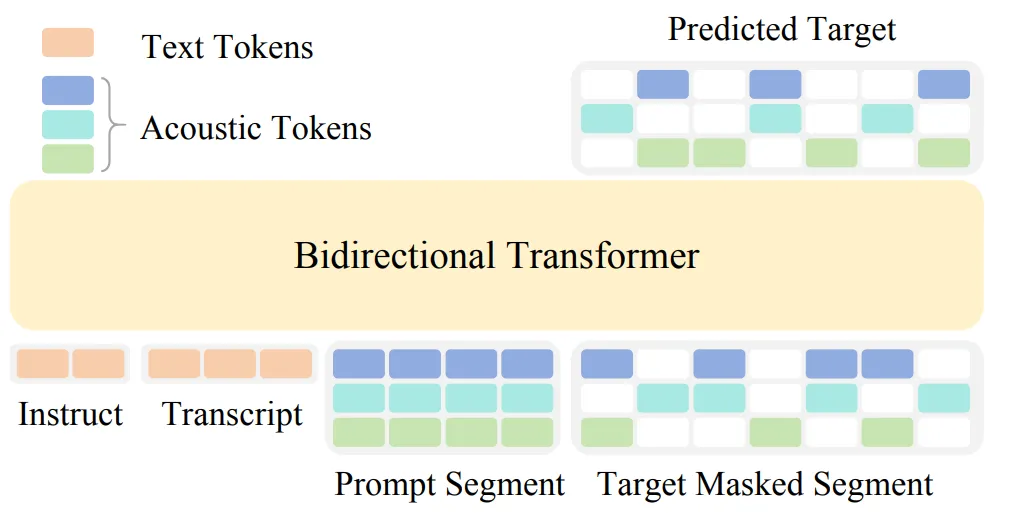
如图1所示,OmniVoice 的模型架构极为简洁,仅包含一个双向的Transformer 网络,模型输入为按顺序排列的文本 token 和多码本声学 token,训练方式就是对多码本声学token进行随机 mask,然后预测被 mask 掉的 token。这可能是目前最简单的非自回归 TTS 模型架构,没有对文本的单独建模,没有 CNN+Transformer 的混合结构,也没有文本到语义 token 再到声学 token 的层级预测。看到这么简单的架构,大家可能会疑惑:这么简单,真的能训出顶尖性能的TTS模型吗?答案是肯定的。
为了严谨地验证这一架构的有效性,团队在学术领域常用的 Emilia 中英数据集(10万小时)上训练了 OmniVoice 模型,并在应用最广泛的三个中英文测试集上与现有的 SOTA 模型进行对比。
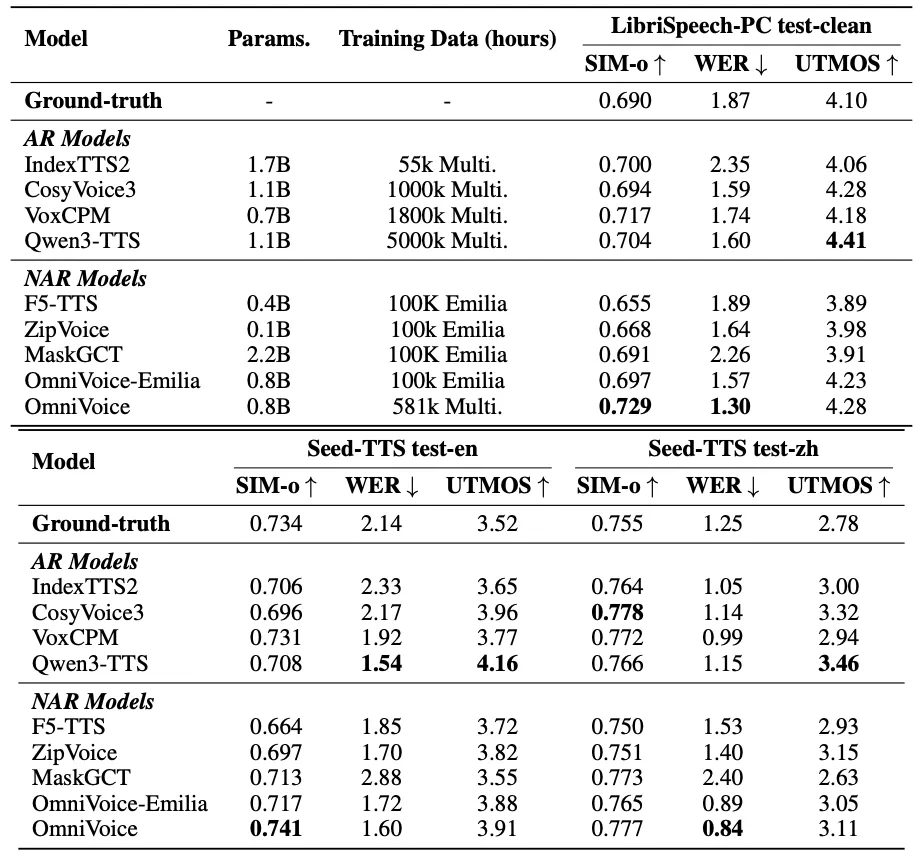
结果如表1所示,首先团队来看几个同样在 Emilia 数据集上训练的非自回归模型,不难看出,OmniVoice 的架构展示出了显著强于现有非自回归 TTS 架构的能力,OmniVoice-Emilia 几乎在所有指标上都优于此前的非自回归 TTS 模型。而在多语言数据集(58万小时)上训练的OmniVoice 更进一步提升了所有指标,相较其他的所有的 SOTA 模型,OmniVoice 展示出更优的综合能力。
除了语音质量外,OmniVoice 的架构优势还体现在训练和推理速度上,在8张 H800 GPU 上,仅需1.33天就可以完成10万小时 Emilia 数据集的训练。在 H20 GPU上用 PyTorch 推理,RTF 可以低至0.025。
说完了这些优势,下面来介绍一下 OmniVoice 为什么可以用极简的架构实现这么强的性能。
OmniVoice 是一个基于离散语音 token 的非自回归 TTS 模型,此前这一类模型通常需要采用两阶段建模 [2],即先预测单码本的语义(semantic)token,再预测多码本的声学(acoustic)token,这种级联方案可以简化每个模块的训练难度,但也会造成级联误差,带来性能瓶颈。近期也有工作尝试将离散非自回归架构修改为端到端的方式 [3],然而,即使采用结合了语义知识蒸馏的复杂方案,其性能依然与两阶段模型存在差距,更不要说超越两阶段模型。那么,为什么 OmniVoice 能把单阶段的离散非自回归架构做到超越两阶段的性能呢?核心在于两个非常简单易行的技巧:一是使用全码本随机 mask,二是使用预训练 LLM 作为参数初始化。下面展开说说这两个技巧为什么非常重要。
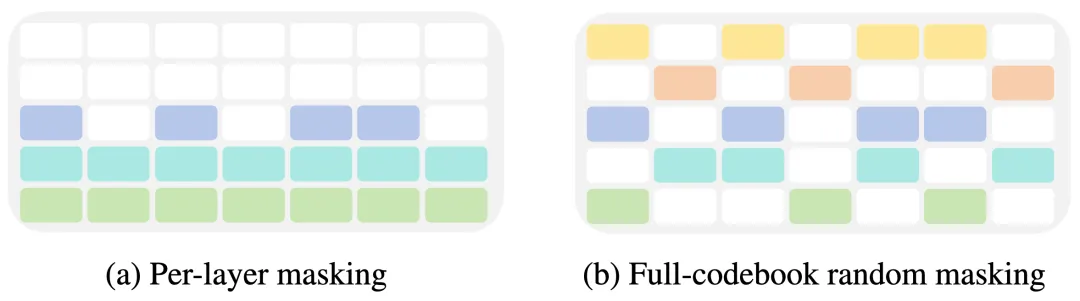
Mask(掩蔽)策略决定了模型能见到什么样的 token 模式并直接影响 loss 的计算,因此,这是一个非常关键的设计点。此前的Soundstorm模型 [4] 和MaskGCT模型 [3] 都采用了一种逐层的mask策略,如图2(a)所示,对每个训练样本随机挑选一层码本,在这一层码本中进行随机 mask,并在被 mask 的 token 上计算 loss,这一层码本之上的所有 token 也会被 mask,但不会参与 loss 计算。这一方案利用了 RVQ 声学 token 的先验,在训练中保持了与推理过程一致的 mask 模式(推理时 RVQ token 一般是逐层推理)。然而,我们可以注意到,在这一方案下,只有一层码本中的被 mask token 参与训练,这会导致训练效率极低。为了解决这个问题,团队采用了如图2(b)所示的全码本随机mask方案,并且对所有被 mask 的 token 都计算 loss,在这一方案下,参与 loss 计算的 token 数是逐层 mask 方案的 C 倍(C 为码本数),大大提高了训练效率。
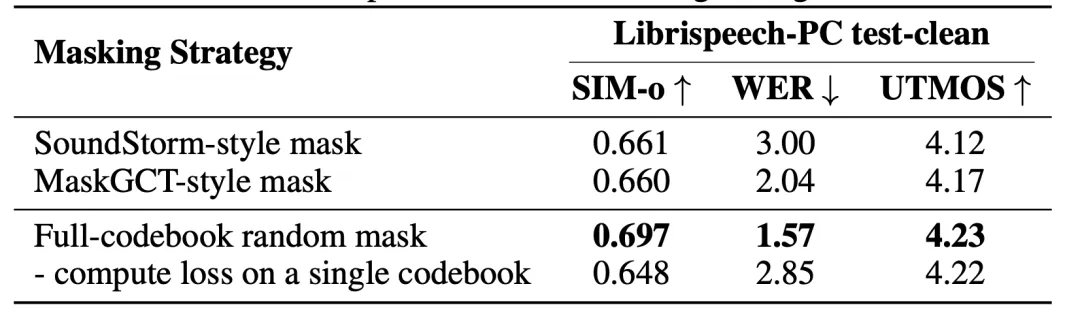
如表2所示,当我们使用 SoundStorm 或 MaskGCT 中的逐层 mask 策略时,模型表现相比全码本随机 mask 显著变差;团队还做了一个额外的消融实验,即使用全码本随机 mask,但仅在其中一个码本上计算 loss,可见性能也会显著变差,这证明了将尽可能多的 token 纳入 loss 计算中的好处。
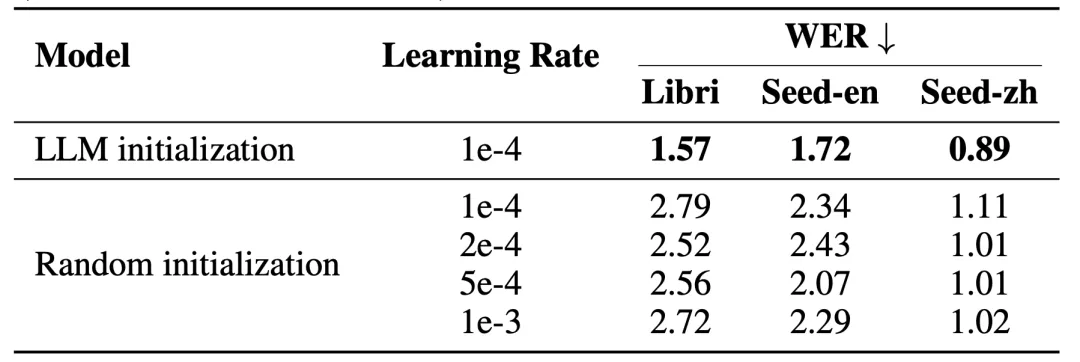
第二个重要策略是使用预训练的 LLM 作为模型的初始化参数。此前,基于离散多码本 token 的 TTS 模型,无论是单阶段还是两阶段,在语音可懂度(体现在 WER 上)方面与现有 SOTA 水平都存在一定差距,LLM 参数初始化就是为了解决这一重要问题。此前,LLM 初始化已经在自回归 TTS 模型中得到了应用 [5],但现有非自回归模型还没有从这一方案中获益。OmniVoice 证明,虽然非自回归 TTS 和预训练的LLM 存在注意力机制上的差异(双向注意力 vs 因果注意力),TTS 模型依然可以受益于 LLM 的预训练参数,更好地理解文本,在可懂度上得到显著提升(如表3所示)。
综上,在这两个方案的加持下,OmniVoice 得以凭借极简架构实现极强性能的目标,有效拓展了非自回归 TTS 的能力边界。且由于这一架构的简洁性,天然更适合进行大规模任务的扩展,为后续的多语言扩展打下了坚实的架构基础。
⏩二、纯开源数据打造 600+ 语种覆盖的 SOTA 多语言 TTS 模型
训练大规模多语言 TTS 模型,核心是构建高质量的多语言数据集。得益于开源社区的共同努力,现有的开源语音数据已经覆盖了数百语种。团队收集了50个开源语音数据集,由于其中很多数据集包含大量噪声,且标注质量参差不齐,团队对噪声比较显著的数据集使用降噪模型进行处理,同时,通过一些基于规则的方法 [6],过滤掉了文本标注质量较差的数据。最终得到了覆盖646个语种的58万小时训练数据。
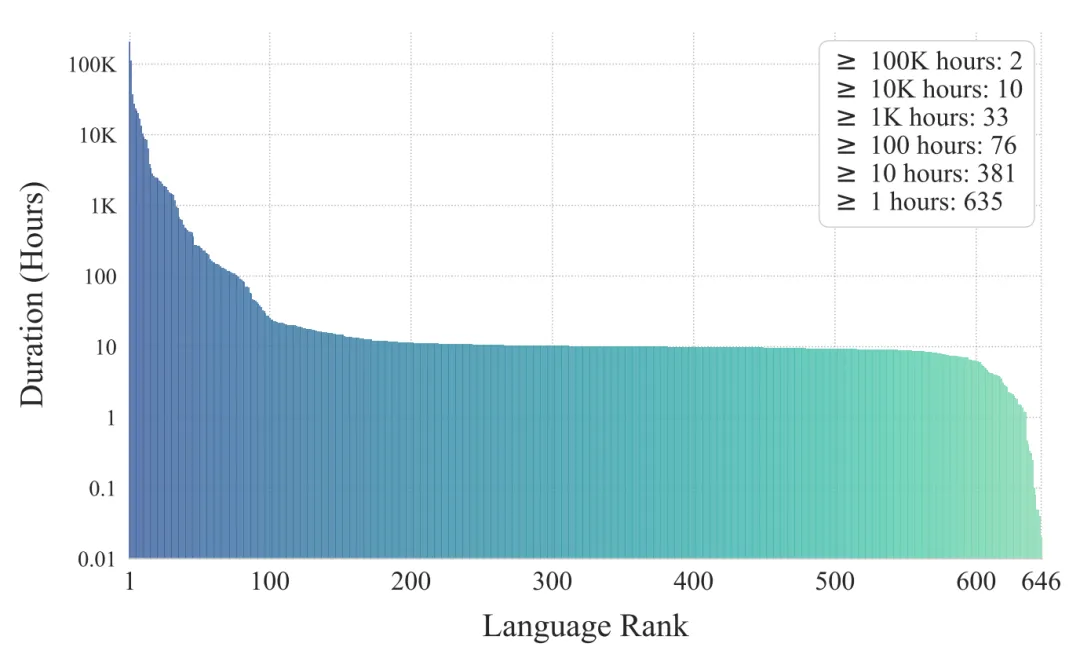
如图3所示,训练集中各语种的数据量存在严重不平衡问题,因此根据各语种的训练数据量,对其进行不同程度的上采样,以保证低资源语种在训练中的曝光度。
此外,多语种语音合成中一个复杂的技术难题,是如何将各种书写体系下的文本送入模型。已采用 LLM 作为主干网络,因此可自然地使用 LLM 的 tokenizer 处理多语言文本,这样既避免了对多语言进行复杂的 G2P(文本转音素)操作,也能让 LLM 更好地继承预训练知识。
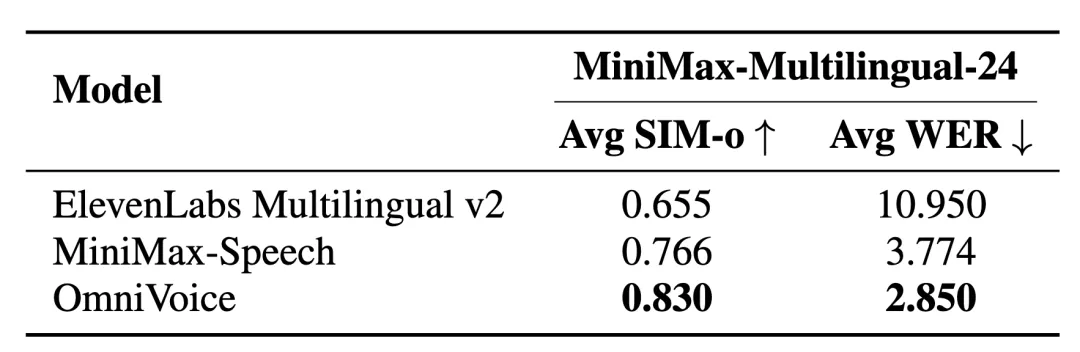
首先在 MiniMax-Multilingual-24(24语种)测试集上对模型进行测试,结果如表4所示,尽管 OmniVoice 仅基于开源数据训练,但其在说话人相似度(SIM-o)和可懂度(WER)这两个重要指标上,均超越了两个商业系统。这体现出 OmniVoice 架构带来的巨大优势。
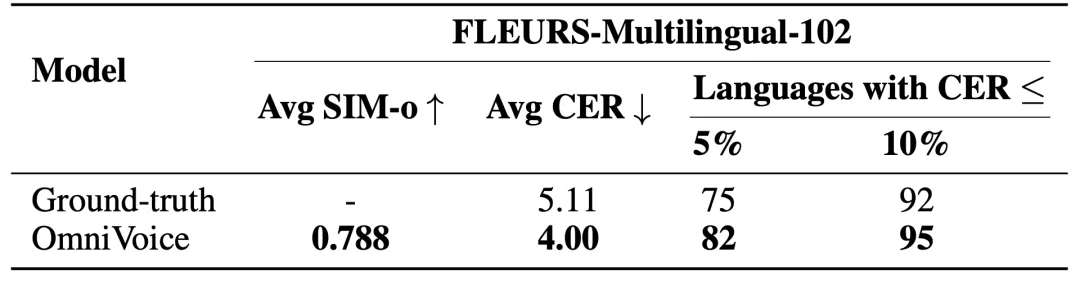
为了进一步测试模型在更多语种上的表现,利用 FLEURS [7] 数据集的验证集和测试集部分数据,构建了一个覆盖102语种的多语言测试集。如表5所示,OmniVoice 的平均字错误率(CER)比真实语音更低,同时维持了很高的说话人相似度。当然,这个结果并不足以证明 OmniVoice 在所有语种上都能生成比真实语音更好的语音,但足以说明 OmniVoice 的能力已经超出了 ASR(语音识别)模型的衡量范围。
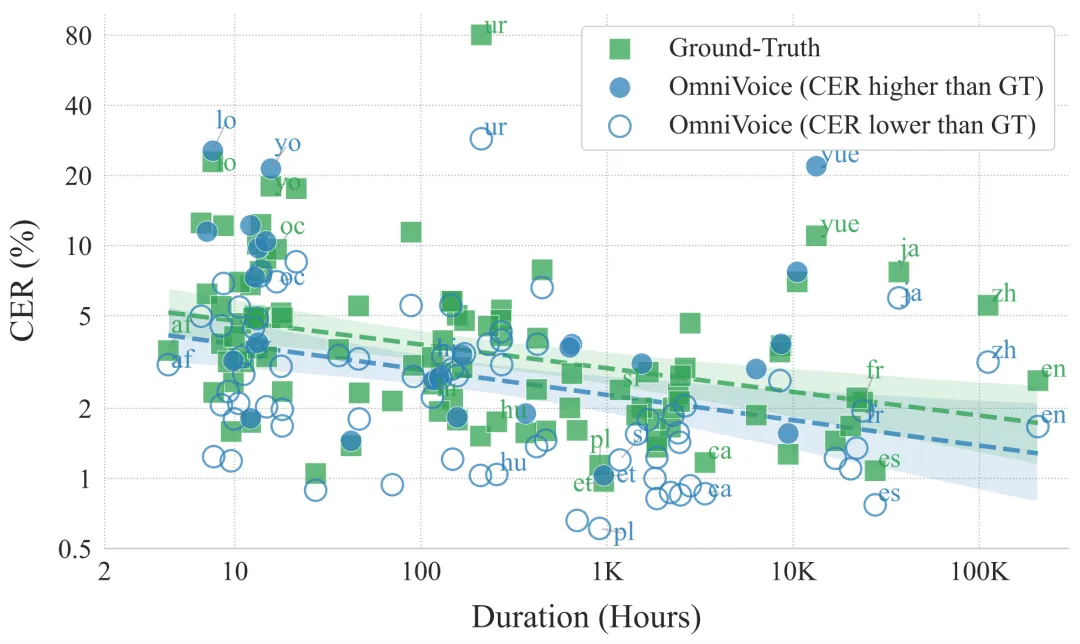
为了进一步分析这102个语种的性能表现,团队以训练数据时长为 X 轴、CER 为 Y 轴,为这102个语种绘制了散点图(如图4所示),可以看出,在大部分语种上,OmniVoice 的 CER 都低于真实语音。尤其令人惊喜的是,从图4左下角可以发现,对于许多训练数据不足10小时的语种,OmniVoice 的 CER 都可低于5%,这一现象体现了 OmniVoice 对低资源语种极强的泛化能力,大大降低了低资源语种的支持门槛。
⏩三、多维度可控:音色设计、参考音频去噪、副语言控制与发音纠正
为了提高 OmniVoice 在实际场景中的可用性,团队进一步为模型增加了多个维度的控制能力。
首先,为模型新增了基于说话人属性的音色设计能力,可通过性别、年龄、音调、方言、口音等控制音色,同时额外支持耳语风格。这一能力的扩展在 OmniVoice 的架构下非常简单,只需在输入序列最前方的指令(instruct)文本中加入对应说话人属性标注即可。
第二,考虑到实际使用场景中,收音设备和录音环境往往并不完美,难以提供音质完美的参考音频。为了解决这个问题,团队在模型训练中加入了一个参考音频去噪任务,对一小部分训练数据,在语音的提示(prompt)部分添加噪声和混响,而待预测部分则保持原状,同时在指令(instruct)部分给模型添加 <|denoise|> 标签,这样模型就能学到 <|denoise|> 标签时执行去噪任务,提取出带噪语音中的说话人音色。这样,即便提供的参考音频声学环境并不理想,模型也能合成较高质量的语音。
第三,还支持在模型中插入笑声、叹气声等副语言符号,让模型输出更灵活、更有表现力。
第四,模型能力再强,有时也会出现读错字的问题,尤其中文多音字和英文专有名词。为了解决这一问题,在训练中采用了拼音/音素与文字混合输入的格式,这样在推理时,就可以通过拼音纠正中文错误发音,通过音素纠正英文错误发音,大幅提升模型的可靠性和可用性。
⏩四、总结
综上,OmniVoice 凭借极简架构和多语言优势为 TTS 领域带来了全新突破,核心优势有三点:
极简的超强架构:OmniVoice 是现有非自回归 TTS 模型中最简单的,且合成语音质量最好,同时还具有训练和推理速度上的巨大优势;
多语言能力顶尖:覆盖646种语种,在中英文上保持优异能力的同时,让低资源小语种也能实现高质量合成,性能超越商用系统;
实用性强:多维度可控,适配多种实际应用场景。
OmniVoice 的代码、模型已全部开源,无论是想体验600+语种的语音克隆,还是开发者想二次开发,都能直接上手!项目相关链接如下👇
论文:https://arxiv.org/abs/2604.00688(了解技术细节) Github:https://github.com/k2-fsa/OmniVoice(含完整训练、推理代码) 语音样本展示:https://zhu-han.github.io/omnivoice(直观感受语音合成效果) Huggingface Demo Space:https://huggingface.co/spaces/k2-fsa/OmniVoice(无需代码一键试用) Huggingface Model:https://huggingface.co/k2-fsa/OmniVoice(模型权重直接调用)
参考文献
[1]Han Zhu, Lingxuan Ye, Wei Kang, Zengwei Yao, Liyong Guo, Fangjun Kuang,Zhifeng Han,Weiji Zhuang, Long Lin, and Daniel Povey,OmniVoice: Towards omnilingual zero-shot text-to-speech with diffusion language models. arXiv preprint arXiv:2604.00688, 2026.
[2] Yuancheng Wang, Haoyue Zhan, Liwei Liu, Ruihong Zeng, Haotian Guo, Jiachen Zheng, Qiang Zhang, Xueyao Zhang, Shunsi Zhang, and Zhizheng Wu. MaskGCT: Zero-shot text-to-speech with masked generative codec transformer. In The Thirteenth International Conference on Learning Representations, 2025.
[3] Gerard I Gállego, Roy Fejgin, Chunghsin Yeh, Xiaoyu Liu, and Gautam Bhattacharya. Single-stage tts with masked audio token modeling and semantic knowledge distillation. In ICASSP 2025-2025 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), pages 1–5. IEEE, 2025.
[4] Zalán Borsos, Matt Sharifi, Damien Vincent, Eugene Kharitonov, Neil Zeghidour, and Marco Tagliasacchi. Soundstorm: Efficient parallel audio generation. arXiv preprint arXiv:2305.09636, 2023.
[5] Zhihao Du, Yuxuan Wang, Qian Chen, Xian Shi, Xiang Lv, Tianyu Zhao, Zhifu Gao, Yexin Yang, Changfeng Gao, Hui Wang, et al. Cosyvoice 2: Scalable streaming speech synthesis with large language models. arXiv preprint arXiv:2412.10117, 2024.
[6] Han Zhu, Wei Kang, Liyong Guo, Zengwei Yao, Fangjun Kuang, Weiji Zhuang, Zhaoqing Li, Zhifeng Han, Dong Zhang, Xin Zhang, et al. Zipvoice-dialog: Non-autoregressive spoken dialogue generation with flow matching. arXiv preprint arXiv:2507.09318, 2025.
[7] Alexis Conneau, Min Ma, Simran Khanuja, Yu Zhang, Vera Axelrod, Siddharth Dalmia, Jason Riesa, Clara Rivera, and Ankur Bapna. Fleurs: Few-shot learning evaluation of universal representations of speech. In 2022 IEEE Spoken Language Technology Workshop (SLT), pages 798–805. IEEE, 2023.
