
 语音小管家
多模态情感分析正经历从静态分类向生成式推理(Generative Reasoning)的深刻范式转变。为了理解复杂的社交互动,系统必须能够综合诸如面部微表情和语音韵律等细粒度信号,以解码潜在的因果逻辑。
近年来,虽然通用多模态大语言模型(如 LLaVA [1])在基础视觉对齐上取得了长足进步,但在细粒度感知方面仍面临显著局限。在处理复杂交互时,模型往往会陷入严重的“单模态主导(Uni-modal Dominance)”问题。这导致模型在面对模态间存在细微、模糊或矛盾线索(例如讽刺场景)时极易产生幻觉。尽管如 Emotion-LLaMA [2] 和 EmoChat [3] 等模型将大语言模型引入情感推理并尝试捕获微表情,且 MOSEAR [4] 开始关注模态冲突中的偏见问题,但由于训练数据构建缺陷和缺乏显式的感知解耦机制,模型在面对真实世界的视听矛盾时依然脆弱。
近期,西北工业大学音频语音与语言处理研究组(ASLP@NPU)被ICME2026录用的最新论文“Integrating Fine-Grained Audio-Visual Evidence for Robust Multimodal Emotion Reasoning”针对上述问题开展了深入研究。论文构建了包含60万片段的大规模情感推理数据集SABER,并提出了一种名为SABER-LLM的鲁棒多模态推理框架。相关代码和数据已开源。现对该论文进行简要的解读和分享。
论文题目:Integrating Fine-Grained Audio-Visual Evidence for Robust Multimodal Emotion Reasoning
作者列表:赵致闲,田文杰,谢磊
论文预印版:https://arxiv.org/pdf/2601.18321
开源模型和数据集:https://github.com/zxzhao0/SABER-LLM
背景动机
尽管多模态大语言模型(MLLMs)在生成式智能领域取得了进展,但其在细粒度情感推理方面的潜力仍远未得到充分挖掘。与分配离散标签的传统方法不同,生成式推理需要综合多模态信号 —从声学韵律到微表情动作,以解读复杂社会互动背后的因果逻辑。然而,现有系统存在细粒度感知不足的问题。如图 1 上半部分所示,当前模型框架通常采用 “碎片化” 范式,独立处理视觉与声学信号以预测静态标签。这种相互割裂的模式易使模型陷入单模态主导困境,即过度依赖某一突出模态,却忽视其他通道中细微却关键的信息。同时,这种碎片化范式也忽略了跨模态语境,导致模型在模态信号相互矛盾时易出现严重误判。例如下面视频样例1和2,检测到 “不耐烦的语气” 却忽略 “面部的笑容”,可能会将 “善意调侃” 误判为真实冲突。这一局限不仅使模型在模态不一致场景中失效,还会降低其在需要细微特征识别任务中的表现(如 “礼貌却冷淡的语气”)。我们将这些局限主要归因于两点:一是缺乏能够教会模型 “情感为何产生” 的细粒度结构化数据,二是缺少强制显式感知的机制,使得模型倾向于依赖统计捷径,而非基于证据进行推理。
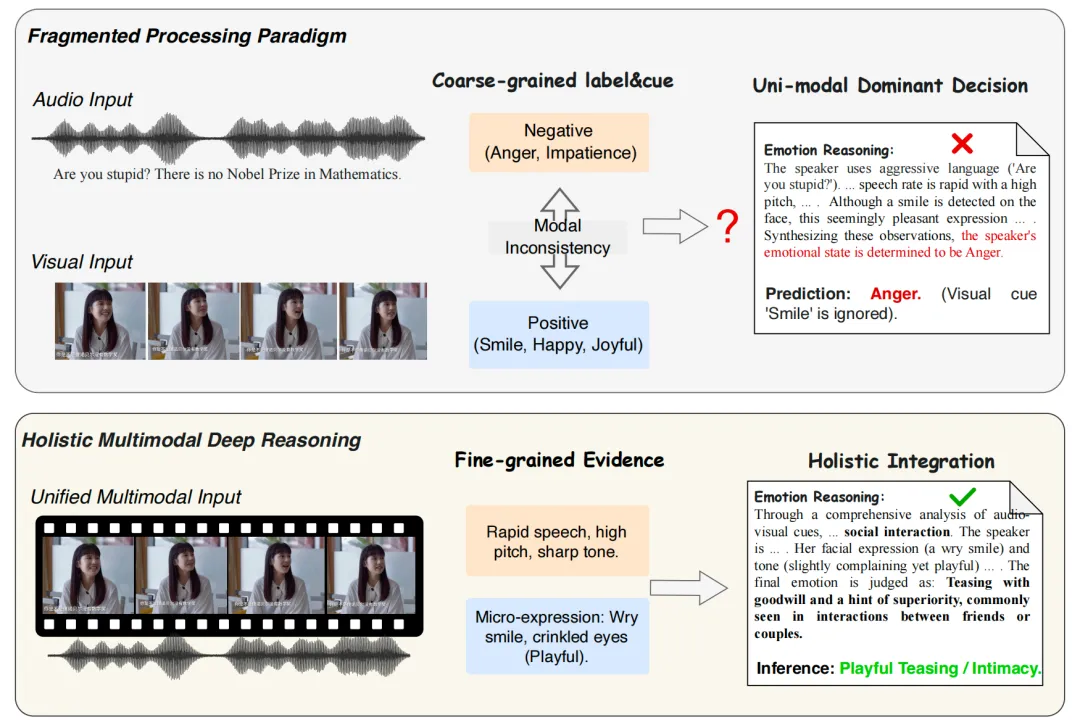
图1 碎片化与整体情感推理对比。上方传统方法陷入“单模态主导”,将掩饰真实意图的微笑误判为愤怒;下方整体推理则成功整合了细粒度证据,正确解码了复杂的“开玩笑/戏弄”社交动态。
SABER 数据集
为了弥合浅层分类与深度推理之间的鸿沟,我们引入了 SABER 数据集(Scene, Audio, Body, Expression, and Reasoning)。
大规模与精细化:整合了多个开源数据集包含约 60 万个视频片段,采用独特的六维细粒度注释模式,涵盖:视频描述(宏观场景)、语音内容、声学特征(韵律/音调)、面部表情(微表情/视线)、肢体语言以及综合因果推理。
严格的质量控制:为了消除幻觉,我们集成了双重验证管道:利用 ASR 词错率(WER)检查过滤听觉幻觉,并利用 LLM 评估视觉描述的一致性。
为了专门诊断模型对模态冲突的鲁棒性,我们还构建了 SABER-Test 测试集(1800个样本),并利用 GPT-4o [5] 辅助将其精准划分为“一致(Consistent)”和“不一致(Inconsistent)”子集。
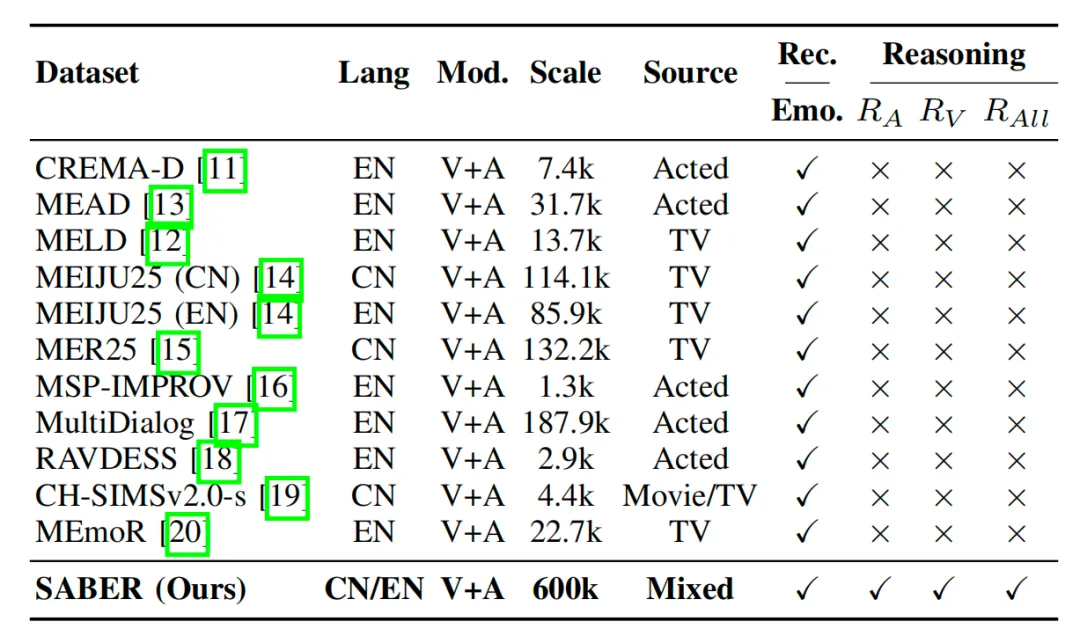
表1 所收集多模态数据集概览。与现有聚焦于识别任务(Rec.)的数据集不同,SABE R 数据集专为细粒度推理任务进行了独特标注。该数据集不仅提供整体模态分析结果(Rₐₗₗ),还分别给出音频模态(Rₐ)与视觉模态(Rᵥ)的独立依据标注。
核心方法:为了应对单模态主导挑战,SABER-LLM 框架(基于 Qwen2.5-Omni [6]架构构建)引入了两个关键的训练阶段,如图2所示。
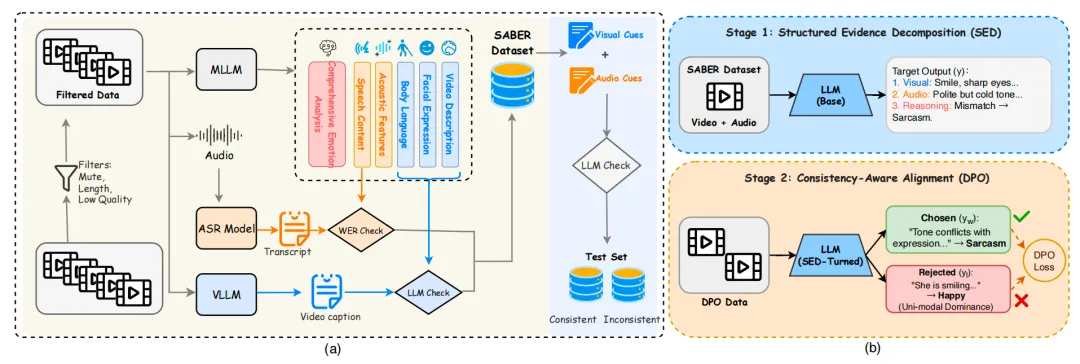
图2 (a) 包含自动化幻觉过滤的 SABER 数据集构建管道;(b) SABER-LLM 的两阶段训练范式:阶段一 (SED) 强制“先感知后推理”,阶段二 (CA-DPO) 在模态冲突场景下对齐人类偏好。
阶段一:结构化证据分解 (Structured Evidence Decomposition, SED)
有别于常规的端到端映射,SED 为模型注入了强烈的归纳偏置。它强制模型在得出最终推理结论之前,必须显式地、独立地提取听觉证据和视觉证据。这种明确的“先感知后推理”机制,有效防止了微弱的情感声学线索被高维语义或视觉特征所淹没。
阶段二:一致性感知偏好对齐 (Consistency-Aware DPO, CA-DPO)
即便经过 SED 微调,模型仍可能在面对矛盾线索时退化为有偏推断。CA-DPO 通过构建包含模态一致与不一致的偏好数据集,明确惩罚那些忽略或覆盖已提取单模态证据的输出序列。这使得推理管道从表面的格式模板,转变为了一条真正可验证的证据链。
实验验证
为了全面评估模型性能,我们在 EmoBench-M [7]、EMER [8] 以及自建的 SABER-Test 测试集上进行了广泛的对比实验。
在全面的 EmoBench-M 测试中,我们的 7B 模型领先众多同量级的开源模型,如下表所示。
表2 SABER-LLM (7B) 在 EmoBench-M 上取得了 59.88 的平均准确率,显著优于 Qwen3-Omni-30B等参数量更大的架构,并在演示情感分析(PEA)等任务上逼近闭源模型 Gemini-2.5-Pro。
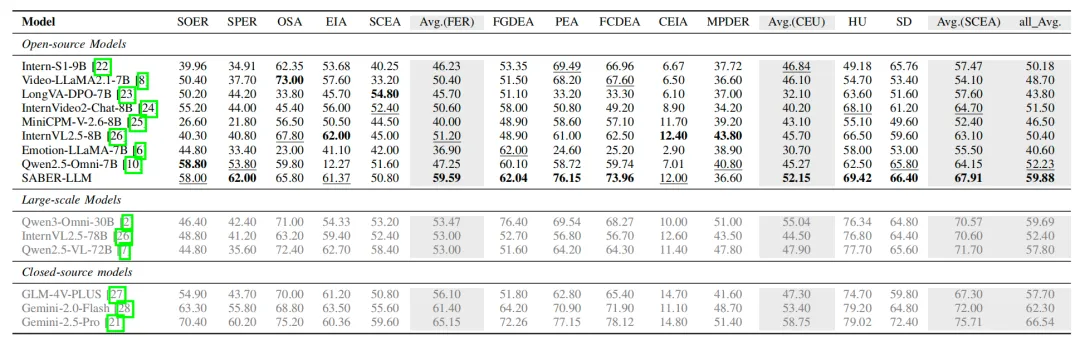
表3 在 SABER 测试集的一致与非一致子集上的性能对比。最优结果以粗体突出显示,次优结果以下划线标注。
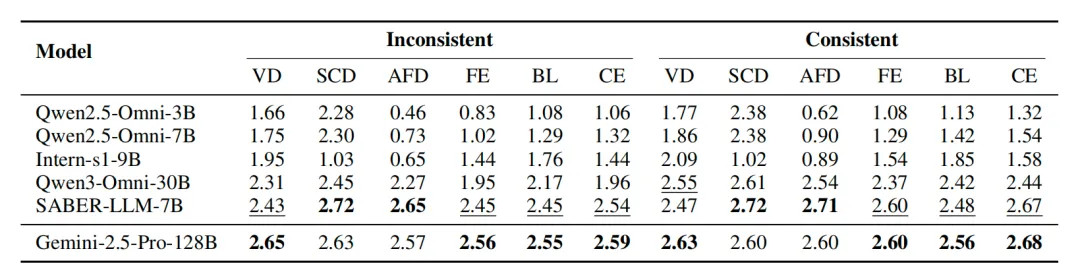
在 SABER-Test 极具挑战性的“不一致(Inconsistent)”子集中,基线模型提取声学特征(AFD)的得分往往出现断崖式下跌,暴露了它们在视觉占优时的脆弱性。而 SABER-LLM 保持了极高的鲁棒性,AFD 得分高达 2.65,证明 SED 策略成功解耦了模态依赖。
案例分析
为了更直观地展示 SABER-LLM 解决跨模态冲突的能力,我们展示一个经典的复杂社交场景的效果,如图3所示。
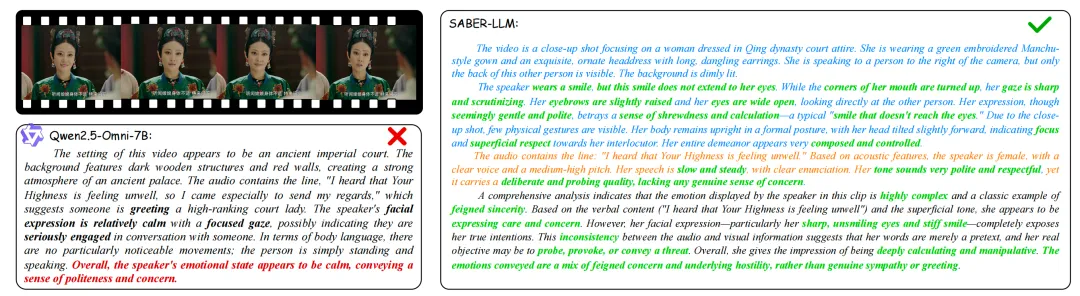
图3 说话人带着微笑表达尊重的言辞,但暗藏试探与敌意。全能基线模型(如 Qwen2.5-Omni)被视觉“微笑”误导,错误预测为“关心”;而 SABER-LLM 成功捕获了“未达眼底的微笑”与“试探性的语气”之间的矛盾,精准推理出底层意图。
在上述案例中,SABER-LLM 没有简单地进行模态融合,而是通过结构化的因果分析,成功避开了单模态的“视觉陷阱”,实现了深度的情感理解。
参考文献
[1] H. Liu, C. Li, Q. Wu, and Y. J. Lee, "Visual instruction tuning," inNeurIPS, vol. 36, pp. 34892–34916, 2023.
[2] Z. Cheng, Z.-Q. Cheng, J.-Y. He, et al., "Emotion-llama: Multimodal emotion recognition and reasoning with instruction tuning," inNeurIPS, 2024.
[3] Q. Xu, L. Pan, S. Yuan, et al., "From subtle hints to grand expressions-mastering fine-grained emotions with dynamic multimodal analysis," inACMMM, 2025, pp. 5499–5508.
[4] Z. Han, B. Zhu, Y. Xu, et al., "Benchmarking and bridging emotion conflicts for multimodal emotion reasoning," inACMMM, 2025.
[5] A. Hurst, A. Lerer, A. P. Goucher, et al., "Gpt-4o system card," arXiv preprint arXiv:2410.21276, 2024.
[6] J. Xu, Z. Guo, J. He, et al., "Qwen2.5-omni technical report," arXiv preprint arXiv:2503.20215, 2025.
[7] He Hu, Yucheng Zhou, Lianzhong You, Hongbo Xu, Qianning Wang, et al. Emobench-m: Benchmarking emotional intelligence for multimodal large language models. arXiv preprint arXiv:2502.04424, 2025.
[8] Zheng Lian, Licai Sun, Mingyu Xu, Haiyang Sun, et al., “Explainable multimodal emotion reasoning,” arXiv preprint arXiv:2306.15401, 2023.
