52KB 的奇迹!NovaSR 开源:16kHz 秒变 48kHz,快出天际的音频超分模型!

就在最近,一个名为NovaSR的开源项目在开源社区里炸开了锅。一款仅有 52 KB 的音频超分辨率模型。 NovaSR可以把电话音质(16kHz)瞬间变成录音室级的 Hi-Fi 音质(48kHz),而且速度快到单张 A100 能跑出 360…
21 0 0

就在最近,一个名为NovaSR的开源项目在开源社区里炸开了锅。一款仅有 52 KB 的音频超分辨率模型。 NovaSR可以把电话音质(16kHz)瞬间变成录音室级的 Hi-Fi 音质(48kHz),而且速度快到单张 A100 能跑出 360…
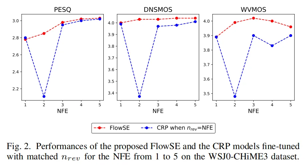
大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…
本文由知乎作者Oliver投稿,采用第一人称视角撰写 语音增强技术已经发展了好多年了,但是目前各说各的好或者是技术保密。那么现在语音增强技术到底发展到一种什么程度了呢?未来的趋向又在什么地方? 2022年入职后,在mentor的指导下我开始…
在语音通信与人机交互场景中,噪声始终是语音质量和识别准确率的最大干扰之一。语音增强(Speech Enhancement, SE)技术旨在从嘈杂的语音中恢复出清晰、自然的干净语音,在语音通话、助听器、语音识别前端等应用中发挥着至关重要的作用…
大象声科(深圳)科技有限公司,简称Elevoc,于2017年在深圳成立,是全球领先的机器听觉人工智能公司之一,致力于提供尖端的智能语音增强和语音交互解决方案,打造更自然的人机交互体验。大象声科云集了一批来自世界顶尖机器听觉科学家和经验丰富的…
恒玄科技主要从事智能音频SoC芯片的研发,设计与销售,为客户提供AIoT场景下具有语音交互能力的边缘智能主控平台芯片,产品广泛应用于智能蓝牙耳机,Type-C耳机,智能音箱等智能终端产品。恒玄科技致力于成为全球最具创新力的芯片设计公司,以前…
语音增强(Speech Enhancement)技术旨在提升语音的可懂度和质量,在实时语音通信、音质修复等诸多场景中具有举足轻重的作用。近来,以语言模型(Language Model)为基础的生成式(Generative)语音增强技术在语音…
语音增强(Speech Enhancement)任务的目标是改善在复杂声学环境中捕获的自然语音信号,滤除噪音,提取出纯净的目标语音,有效提升语音的可听性和可理解性,同时也为下游语音任务提供经过高效降噪处理的、音质清晰的音频结果。 Deep…
最近,西工大音频语音与语言处理研究组(ASLP@NPU)与南洋理工大学(NTU)合作的论文 “GenSE: Generative Speech Enhancement via Language Models using Hierarchic…
大象声科(深圳)科技有限公司,简称Elevoc,于2017年在深圳成立,是全球领先的机器听觉人工智能公司之一,致力于提供尖端的智能语音增强和语音交互解决方案,打造更自然的人机交互体验。大象声科云集了一批来自世界顶尖机器听觉科学家和经验丰富的…