ICML26丨给AI喂“噪声”也能涨分,这项工作让噪声实现正迁移

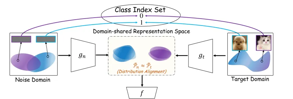
SSNA团队 投稿,量子位 | 公众号 QbitAI 迁移学习里的“源数据”,未必非得是图像、文本或音频。 一组从高斯分布里随机采样出来、没有任何语义的噪声,也能帮助模型在少量标注下学得更好。 这项工作名为半监督噪声自适应(Semi-Sup…
26 0 0

SSNA团队 投稿,量子位 | 公众号 QbitAI 迁移学习里的“源数据”,未必非得是图像、文本或音频。 一组从高斯分布里随机采样出来、没有任何语义的噪声,也能帮助模型在少量标注下学得更好。 这项工作名为半监督噪声自适应(Semi-Sup…
通义千问正式发布第三代图像生成基座模型 Qwen-Image-3.0,重点提升复杂指令理解、信息图生成与文字渲染能力。 核心特点 内容丰实:支持最大4.5k token输入,轻松生成报纸、分镜、试卷等复杂版面。 细节真实:支持 10px 小…
Qwen-Audio-3.0-TTS实时语音合成模型发布。本次发布包含两个版本: Flash:面向实时交互,首包延迟在300ms左右。 Plus:面向高质量生成,在自然度和音色还原度上表现更佳。 本次更新,我们把精力放在了开发者在生产环境中…
GitHub:https://github.com/Eps-Acoustic-Revolution-Lab/EAR-Audio-Preview VS Code Marketplace:https://marketplace.visualst…
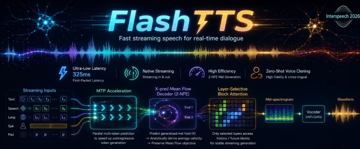
近年来,基于大语言模型(LLM)的文本转语音技术快速发展,基于大语言模型(LLM)的TTS方案已经在自然度、音色相似度和零样本音色克隆(zero-shot voice cloning)等方面取得显著进展。然而,随着语音助手、实时语音对话、虚…
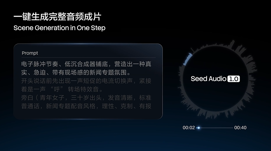
今天,字节跳动发布能同时生成人声、音效和环境声的音频创作模型 Seed Audio 1.0。 其核心能力主要体现在以下方面: 多要素统一编排,支持精细的时间控制:一条 prompt 即可统一编排带有特定情绪的对白、关键音效和环境声,并可按时…
来源丨SV4Good AI Lab Sora、Kling 等文生音视频模型,能画出逼真画面、配上同步声音,但真的懂声学物理吗?吹空瓶子 vs 吹装水瓶子、敲木头 vs 敲金属,模型能生成符合物理规律的声音吗? 本文介绍由香港科技大学(广州)…
近日,语音 AI 初创公司 Rime 宣布完成 2400 万美元 A 轮融资。本轮由知名风投机构 M13 领投,Twilio Ventures、Corazon Capital、Unusual Ventures 和 Cadenza Ventu…
