TF-MossFormer:在单通道语音分离中同时捕捉“局部细节”与“全局依赖”

来源丨阿里语音AI 近年来,单通道语音分离技术犹如一场精彩的接力赛,从 Conv-TasNet 的精巧卷积,DPRNN 的深度循环,到 SepFormer 和 MossFormer 的 Transformer 革命,再到 TF-GridNe…
30 1 0

来源丨阿里语音AI 近年来,单通道语音分离技术犹如一场精彩的接力赛,从 Conv-TasNet 的精巧卷积,DPRNN 的深度循环,到 SepFormer 和 MossFormer 的 Transformer 革命,再到 TF-GridNe…
来源丨新智元 刚刚,Anthropic和OpenAI同时放出了语音模式大升级! Claude这边,从只能跑Haiku升级到Opus 4.8和Sonnet 5全系列,不仅能在对话里调Gmail、日历、Slack,还扩增到11种语言,但没有中文…
工作地址:上海市朱梅路地铁站附近。 岗位一、音频算法工程师:5人 岗位职责: 1. 负责全景声算法(音乐分离、空间音频等)的设计实现、移植调试。 2. 负责无麦K歌、啸叫抑制等算法的设计实现、移植调试。 3. 负责车内外通话(AI降噪、AE…
近年来,端到端口语对话(S2S)与语音合成(TTS)技术正加速从“可懂、可用”向“自然、拟人”发展。尤其在智能座舱、语音助手等实际应用场景中,用户对语音交互的期待已不再局限于内容准确,还希望模型能够展现接近真人的表现力,包括细腻的情绪起伏、…
ACL(Annual Meeting of the Association for Computational Linguistics)是计算语言学与自然语言处理(NLP)领域最具影响力的国际学术会议之一,每年汇聚全球顶尖学者、研究机构与工…
全双工语音对话模型(Spoken Dialogue Model, SDM)已经能够同时进行听、说与被打断的实时交互。但一个更基础的问题始终没有被充分回答: 为全双工 SDM 设计强化学习训练时,应当以何种信号作为奖励? 现有方法大多只覆盖评…
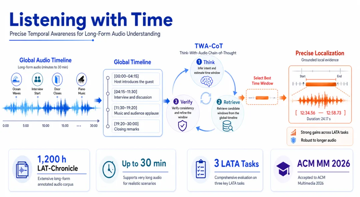
近年来,基于大语言模型(LLM)的音频大语言模型(Large Audio Language Models, LALMs)在音频理解任务上取得了显著进展,在短音频场景中已经展现出优异的性能。然而,当输入扩展到播客、访谈、会议、直播等常见的持续…
