
 语音小管家
WenetSpeech 家族就像是一场前赴后继的饕餮盛宴。前赴后继是指 WeNet 社区的小伙伴们在数据的投入上前赴后继,不断探索新的边界,你方唱罢我登场;而饕餮盛宴,不是一道菜,而是源源不断的菜品,是社区给开发者、公司、研究人员不断的献礼。
在今天这个大语言模型的时代,数据的作用已深入人心,大家在数据上投入最大且最强的人力和资源,不断的 Scale 数据的规模。然而,时间拉回到五年前,中文语音领域最大规模的数据是 AIshell-2,仅仅是 1000 小时的朗读数据集,在绝大部分人的认知里,数据工作低级且 dirty。而这,恰是 WenetSpeech 故事的开始。
WenetSpeech,故事的开始
一开始,该团队就将目标设定在了1 万小时,且必须是多场景多领域的数据。在西工大谢老师、出门问问、希尔贝壳、腾讯天籁实验的支持下,故事开始了!
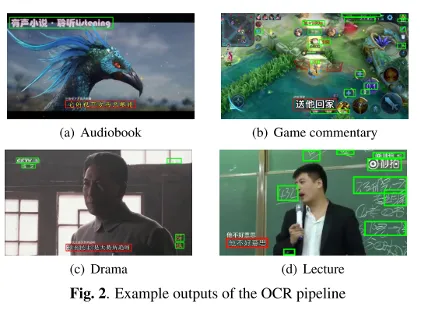
那个时候,还没有好的开源的语音识别系统,闭源的语音识别系统的能力还不够强。那如何获取带有高质量标注的音频?经过长时间的调研和探索,该团队注意到中文的视频中,很多都做了硬字幕的嵌入,并且具有还不错的质量。因此,该团队在 Youtube 上爬取了大量视频,并通过 OCR 识别的方式做了标注。通用的一些 OCR 模型对于字幕的识别效果不好(如一些艺术字体、发光字体等),该团队还自己重新训练了 OCR 模型。为了去除字幕错误、字幕时间点不对、OCR 识别等错误,该团队还精心设计了一个 label error detection 算法,过滤掉有错误的数据。
全球最大多领域中文语音识别数据集 WenetSpeech 正式发布并开放下载
立足长远,立足未来,该团队还精心设计了两个测试集,面向网络数据的多领域测试集 TEST_NET 和面向复杂会议场景的 TEST_MEETING,今天这两个测试集已经成为大部分语音识别文章中都会评测的测试集。
WenetSpeech 就这样出来啦,故事就这样开始了!
在 WenetSpeech 完成之后,一个很自然的想法就是,如何去 Scale? 第一条路是,将 1 万小时 Scale 到 10 万小时,再到 100 万小时。然而,在做 WenetSpeech 的过程中,该团队发现,数据的存储、下载流量、训练所需的资源已非常惊人。一来,那时还没有 huggingface 这些免费的数据托管平台,数据每年的下载流量所费甚巨,数据是免费的,用户每下载一次,都需要几十块的成本。二来,训练也是个问题,10 万小时后,几乎只有少数的玩家可以训练了。三来,普通话的语音识别率的边际收益也在递减。
第二条路是,Scale 到更多的任务和更多的方言。
一番挣扎后,毫无疑问,第二条路更合适。
WenetSpeech4TTS, 为 TTS 而生
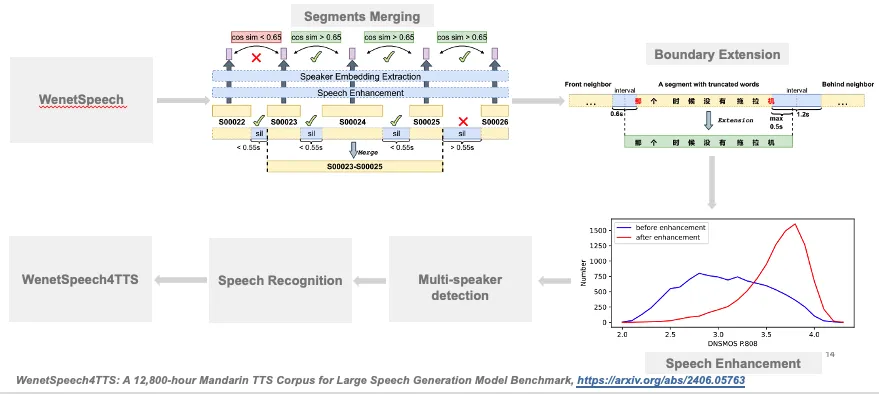
该团队(马林涵、郭大可等)首先针对 TTS 任务,对 WenetSpeech 数据集进行了重新挖掘,也就是 WenetSpeech4TTS。对原始数据集进行了小段的合并、边界的拓展、语音的增强,多说话人的检测、且使用更好的语音识别模型重新进行了标注等的操作。
INTERSPEECH2024 | WenetSpeech4TTS: 12800小时中文大规模语音生成模型训练数据集
WenetSpeech-Yue/Chuan, 方言!方言!
接下来,是方言,首先锚定的是使用人口最多(近 1 亿)的粤语和四川话。在西工大谢老师的指导下,中国电信人工智能研究院、希尔贝壳等单位的通力合作下,该团队(李龙豪、郭钊、戴宇航、张子萸等)发布了 21800 小时的粤语开源数据 WenetSpeech-Yue 和 10000 小时的四川话数据 WenetSpeech-Chuan。因为内容很细,大家可以移步了解细节。
WenetSpeech-Yue: 首个具有多维度标注的大规模粤语语音语料库开源!
WenetSpeech-Chuan:多维标注大规模四川话语音语料库开源
关于未来
饕餮盛宴仍在继续,前赴后继从未停止。我们还在持续探索,持续挖掘。
几天前听了王坚院士的一个《关于年轻人、人工智能与创新》的主题报告,年轻人因科技而聚。我想,年轻人也因开源而聚,愿更多志同道合的年轻人加入我们,群策群力,饕餮永续!
