
 语音小管家
音识别是智能音箱、智能会议等 AIoT 应用的基石 ,在机器人生态中也同样发挥着举足轻重的作用。打造高准确率、高性能的语音识别引擎,才能给语音用户带来良好的体验。
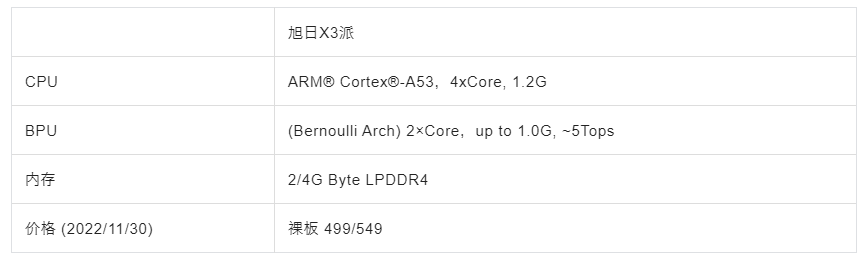
地平线开发者社区在WeNet中开源旭日X3派支持
硬件配置
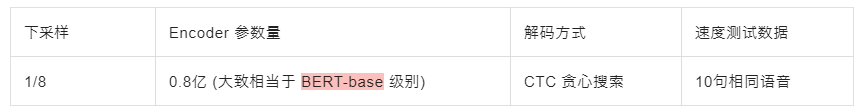
模型配置
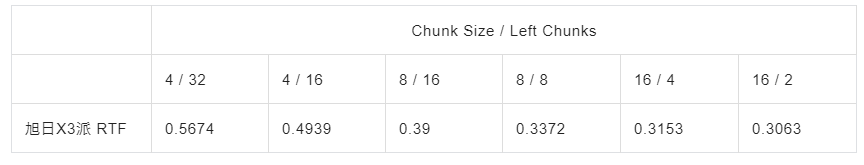
解码速度对比 (单核单线程,量化模型)
上手教程
六千字长文详解可点击 “阅读全文” 进入地平线开发者社区查看
第一步:环境准备
# 0. 安装 WeNet 环境 (10min)
#    0.1 为了方便国内用户,在 gitee 上同步了 WeNet 的镜像仓库以方便 git clone
#    0.2 这里不涉及模型训练,因此直接采用 pip 形式安装 cpu 版 torch 而非 WeNet 官方推荐的 conda install 形式
conda create -n horizonbpu python=3.8
conda activate horizonbpu
git clone https://gitee.com/xcsong-thu/wenet.git
cd wenet/runtime/horizonbpu
pip install -r ../../requirements.txt -i https://mirrors.aliyun.com/pypi/simple
pip install torch==1.13.0 torchaudio==0.13.0 torchvision==0.14.0 onnx onnxruntime -i https://mirrors.aliyun.com/pypi/simple

# 1. 安装 Horizon 模型转换工具包及其依赖项 (1min)
wget https://gitee.com/xcsong-thu/toolchain_pkg/releases/download/resource/wheels.tar.gz
tar -xzf wheels.tar.gz
pip install wheels/* -i https://mirrors.aliyun.com/pypi/simple

# 3. 安装交叉编译工具 (1min) (推荐使用 wsl2, 拥有 sudo 权限)
sudo apt-get install gcc-aarch64-linux-gnu g++-aarch64-linux-gnu
第二步:C++ Demo的交叉编译
# NOTE: 假设在 wenet/runtime/horizonbpu 路径下 (确保下文build文件夹路径是正确的)

# 0. 编译主程序 decoder_main (20min, 涉及从 github 下载 gflag glog, 可能需要翻墙)
#    编译使用 Step-1 中所安装的系统路径中的 aarch64-linux-gnu-gcc 和 aarch64-linux-gnu-g++,通过 whereis aarch64-linux-gnu-g++ 可以查看其安装位置
cmake -B build -DBPU=ON -DONNX=OFF -DTORCH=OFF -DWEBSOCKET=OFF -DGRPC=OFF -DCMAKE_TOOLCHAIN_FILE=toolchains/aarch64-linux-gnu.toolchain.cmake
cmake --build build

# 1. 不需要等交叉编译完成再进行Step-3, C++ Demo 的编译 和 模型转换 互不干扰,可以并行,请直接移步 Step-3
第三步:模型转换
# NOTE: 假设在 wenet/runtime/horizonbpu 路径下 (确保export的相对路径是正确的)

# 0. 配置路径 (1min)
conda activate horizonbpu
export WENET_DIR=$PWD/../../
export PYTHONIOENCODING=UTF-8
export PYTHONPATH=$WENET_DIR:$PYTHONPATH
export PROTOCOL_BUFFERS_PYTHON_IMPLEMENTATION='python'

# 1. 下载torch的浮点模型 (3min)
wget https://ghproxy.com/https://github.com/xingchensong/toolchain_pkg/releases/download/conformer_subsample8_110M/model_subsample8_parameter110M.tar.gz
tar -xzf model_subsample8_parameter110M.tar.gz

# 2. 执行转换,pytorch 模型 -> onnx 模型 -> bin 模型 (~40min)
#    由于模型太大(一亿参数量),转换过程对内存要求很高(至少16G)
#    如果内存不够或者等不急 40min,可以直接从如下链接处下载编译好的 encoder.bin / ctc.bin (以chunksize=8,leftchunk=16为例)
#    https://github.com/xingchensong/toolchain_pkg/releases/tag/model_converted_chunksize8_leftchunk16
python3 $WENET_DIR/tools/onnx2horizonbin.py \
--config ./model_subsample8_parameter110M/train.yaml \
--checkpoint ./model_subsample8_parameter110M/final.pt \
--output_dir ./model_subsample8_parameter110M/sample50_chunk8_leftchunk16 \
--chunk_size 8 \
--num_decoding_left_chunks 16 \
--max_samples 50 \
--dict ./model_subsample8_parameter110M/units.txt \
--cali_datalist ./model_subsample8_parameter110M/calibration_data/data.list
第四步:板上部署
# NOTE: 假设在 wenet/runtime/horizonbpu 路径下 (以确保下文fc_base的路径是正确的)

# 0. 将交叉编译的产物 【主程序decoder_main】 和 【所需的动态库】 上传到板端 (1min)
export BPUIP=xxx.xxx.xxx
export DEMO_PATH_ON_BOARD=/path/to/demo
scp build/bin/decoder_main sunrise@$BPUIP:$DEMO_PATH_ON_BOARD
scp fc_base/easy_dnn-src/dnn/*j3*/*/*/lib/libdnn.so sunrise@$BPUIP:$DEMO_PATH_ON_BOARD
scp fc_base/easy_dnn-src/easy_dnn/*j3*/*/*/lib/libeasy_dnn.so sunrise@$BPUIP:$DEMO_PATH_ON_BOARD
scp fc_base/easy_dnn-src/hlog/*j3*/*/*/lib/libhlog.so sunrise@$BPUIP:$DEMO_PATH_ON_BOARD

# 1. 将模型转换的产物 【encoder.bin】和【ctc.bin】 上传到板端,顺带也传一下示例音频和模型字典 (2min)
scp ./model_subsample8_parameter110M/sample50_chunk8_leftchunk16/hb_makertbin_output_encoder/encoder.bin sunrise@$BPUIP:$DEMO_PATH_ON_BOARD
scp ./model_subsample8_parameter110M/sample50_chunk8_leftchunk16/hb_makertbin_output_ctc/ctc.bin sunrise@$BPUIP:$DEMO_PATH_ON_BOARD
scp ./model_subsample8_parameter110M/test_wav.wav sunrise@$BPUIP:$DEMO_PATH_ON_BOARD
scp ./model_subsample8_parameter110M/units.txt sunrise@$BPUIP:$DEMO_PATH_ON_BOARD

# 2. 登录 x3pi 并测试
ssh sunrise@$BPUIP
######################## 以下命令在 X3PI 中执行###########################
cd /path/to/demo
# 调用 BPU 必须通过 root 权限
sudo LD_LIBRARY_PATH=.:$LD_LIBRARY_PATH \
GLOG_logtostderr=1 GLOG_v=2 \
./decoder_main \
--chunk_size 8 \
--num_left_chunks 16 \
--rescoring_weight 0.0 \
--wav_path ./test_wav.wav \
--bpu_model_dir ./ \
--unit_path ./units.txt 2>&1 | tee log.txt
关于地平线开发者社区
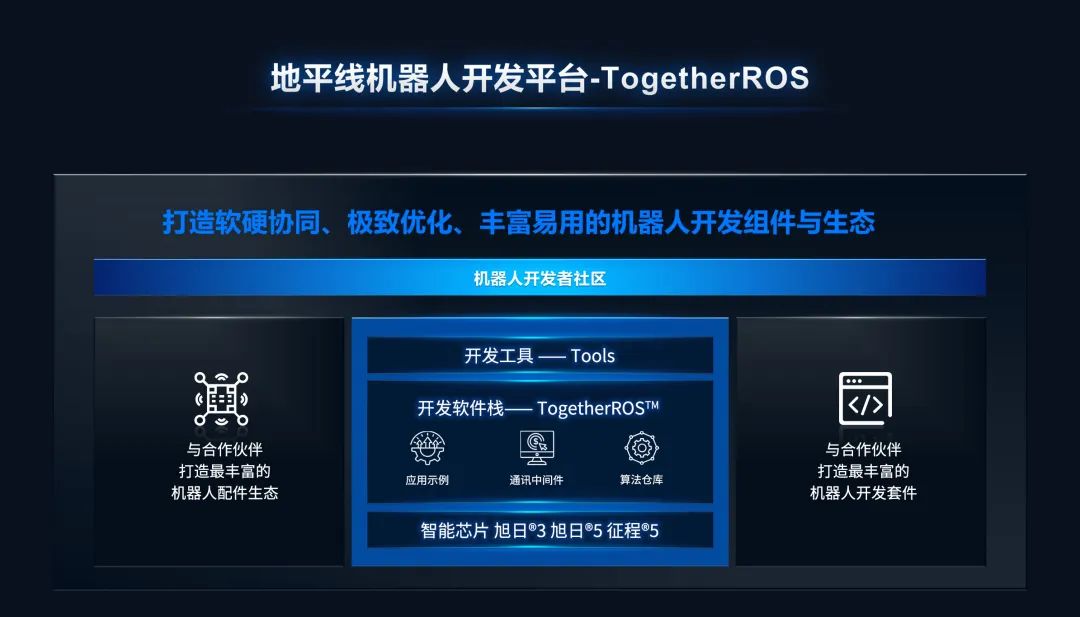
地平线开发者社区致力于连接地平线和开发者,依托地平线软硬件优势,牵引开发者力量,共同构建草木繁荣的机器人生态。目前社区已凝聚大批开发者并提供前沿技术内容和丰富技术活动等一系列开发者服务,聚生态之力,共同打造软硬一体、开放易用的全栈式机器人开发平台,助力生态开发者和商业客户快速打造极具竞争力的智能机器人解决方案。
关于WeNet开源社区
推动基于深度学习的语音技术落地
推动开源语音生态建设 助力国产平台和芯片生态体系
wenet 端到端语音识别工具
wetts 端到端语音合成工具
wekws 端到端唤醒工具
wespeaker 端到端声纹识别工具
WeTextProcessing 新一代文本正规化/反正规化工具
WenetSpeech 一万小时大规模多领域中文语音数据集
Opencpop 首个开源中文歌唱合成数据集
参考链接
地平线官网 https://www.horizon.ai/
wenet官网 https://wenet.org.cn/
地平线开发者社区官网 https://developer.horizon.ai/ 地平线旭日X3派在wenet开源链接https://github.com/wenet-e2e/wenet/pull/1597/files
