周维,58同城AI Lab语音算法部负责人。负责语音识别、语音合成算法研发。58同城AI Lab隶属TEG技术工程平台群,旨在推动AI技术在58同城的落地,打造AI中台能力,以提高前台业务人效、收入和用户体验,部门介绍具体见:58同城AI Lab部门介绍。
58同城语音识别引擎的背景与技术路线
58同城是国内领先的生活服务平台,包含房产、招聘、汽车、本地生活服务等业务,语音是平台上商家、用户、销售、客服之间沟通的主要媒介。近年来,58同城AI Lab一直聚焦在对话式AI(Conversational AI)领域,自2017年9月研发智能客服开始,我们先后打造了智能外呼、语音质检、智能呼入、语音识别、语音合成等产品和能力。对话式AI的核心是智能语音语义技术,包括语音识别、语义理解、语音合成,2021年,我们将这些产品统一升级为"灵犀"智能语音语义平台。"灵犀"平台包含人机对话、对话内容分析两大核心功能,均支持对语音、文本两种媒介的处理。语音识别是"灵犀"平台的底座,需要支持录音文件识别和流式识别服务。录音文件识别服务支持语音内容分析平台(语音分析/质检)中海量语音的转写工作,流式识别服务支持语音对话机器人(外呼/呼入/面试机器人)中的语音交互工作。2020年初,我们基于Kaldi框架开发了自研语音识别引擎,同年6月自研语音识别效果超过了采购的第三方服务,并先后上线了录音文件识别和流式识别服务,从而将第三方服务替换为了自研服务。随着新场景的增多以及业务的不断深入,修复线上badcase、进一步提升语音识别效果成为了我们主要的工作目标,而由于重口音、噪音、背景人声和复杂的业务词汇的影响,线上效果接近了瓶颈,因此我们也持续开展端到端语音识别框架的调研工作。经实验,ESPNet中Transformer+CTC混合解码的结构经过变速增强+多个ckpt融合之后可以达到不错的识别效果。针对ESPNet解码速度较慢的问题,我们实现了动态batchsize推理、降低beamsize、跳帧finetuning、Attention辅助对齐等方法,最终将GPU解码速度提高了60倍,但仍达不到上线的条件,且混合解码的结构不能支持流式,想要大规模部署还需要大量的开发工作。WeNet[1]发布后,我们在自有数据上进行了实验,均取得不错的效果,最终因为WeNet识别效果好、代码简洁轻量和易于部署等特点,选择其作为我们的端到端方案。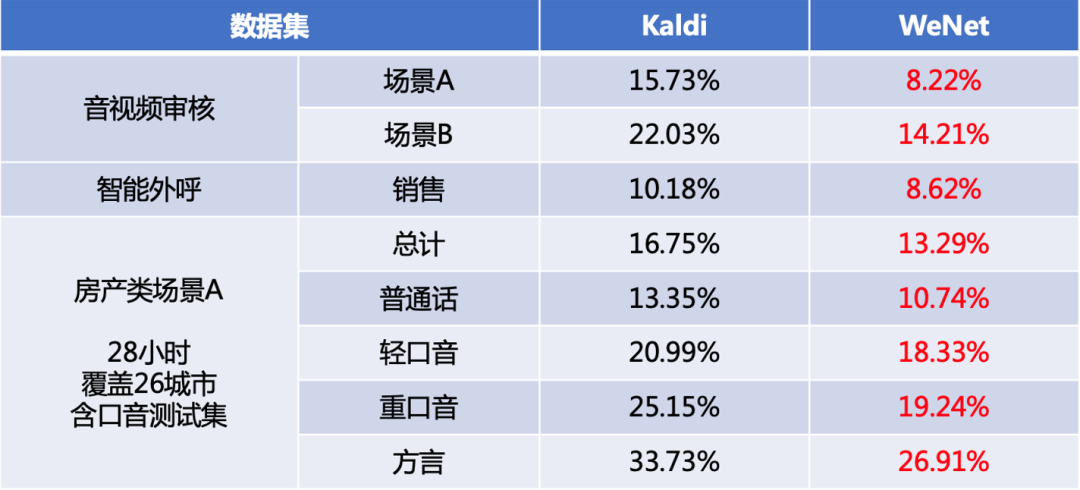
我们基于WeNet分别从识别效果和推理速度上进行优化。识别效果方面,我们采取数据迭代和半监督的方式进行优化;推理速度方面,我们采用了Efficient Conformer结合int8量化的方案,并针对模型压缩展开实验。最终,我们于2022年8月分别在录音文件识别和流式识别场景完成了从Kaldi到WeNet的全量切换。切换后,销售客服质检CER绝对降低4.44%,语音分析场景CER绝对降低5.77%,通用场景语音识别模型字准率达到90%以上。当前录音文件识别引擎处理语音时长达1000万小时/年,流式语音识别引擎支持语音对话量超过5000万次/年。
基于WeNet的语音识别优化工作
半监督训练
在实际场景ASR优化中,增加场景相关的标注数据是最重要的手段,但数据标注的成本高、周期长,且各场景信道跨度较大时数据迁移效果很差(比如从8k电话场景迁移到44k直播/短视频场景),因此对于全新的场景来说冷启动往往比较困难。我们使用的半监督方法参考了NST(Noisy Student Training)[2]的Self-Training的思路,即对线上存在大量的无标签数据打上伪标签,经过一系列筛选后反过来迭代base模型,经过反复迭代就可以提升模型的识别效果。- 训练一个Teacher模型(少量标注数据+其他场景数据)
- 使用 Teacher 模型为未标注的数据打上伪标签
- 再将 Student 作为新的 Teacher 重复之前的过程。
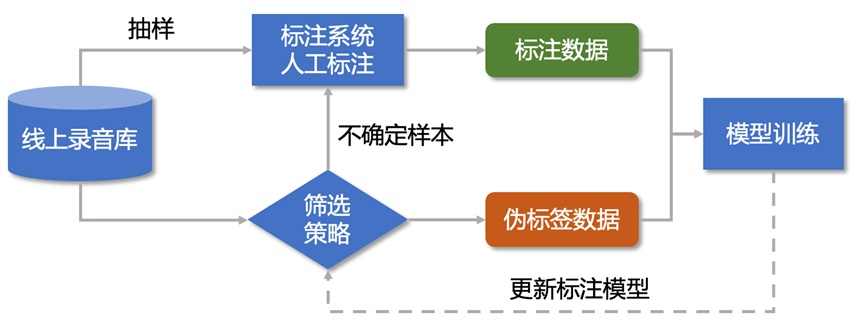
在伪标签筛选时,我们使用下面四种伪标签筛选策略,其中模型打分和编辑距离策略较为有效。当伪标签数据量级不大时,是否进行数据筛选对模型效果影响较小。当数据量级很大时,则需要进行筛选,以降低低质数据量。- Confidence Score:利用ASR模型打分(分值进行归一化)
- Model Disagreement:不同ASR模型预测结果的一致性,编辑距离 or CER
- Words per Second:文本长度/录音时长
- Rare Data/ Low Accurate Data:选取尽量包含特定词或稀有词等样本,适合针对性的优化
我们首先在房产类场景A进行了半监督实验,训练数据如下图所示。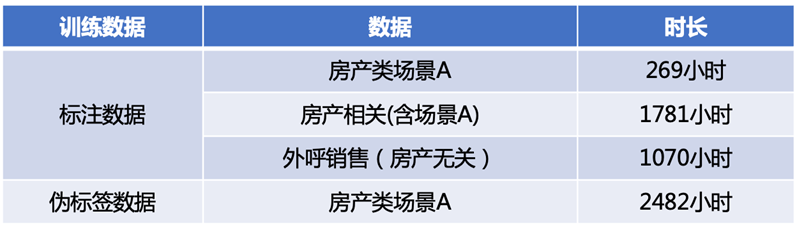
Teacher为在WenetSpeech模型基础上使用房产相关+外呼销售标注数据finetune后的模型,以此对2482小时的场景A的无标签数据打上伪标签。在场景A的测试结果如下图所示,可见在标注数据只有269小时的情况下,使用伪标签数据带来了显著提升。
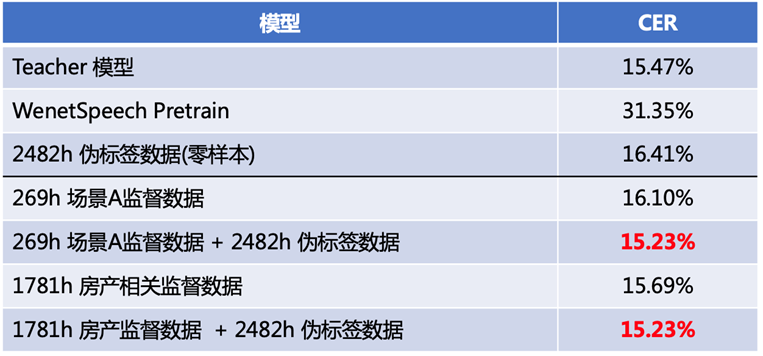
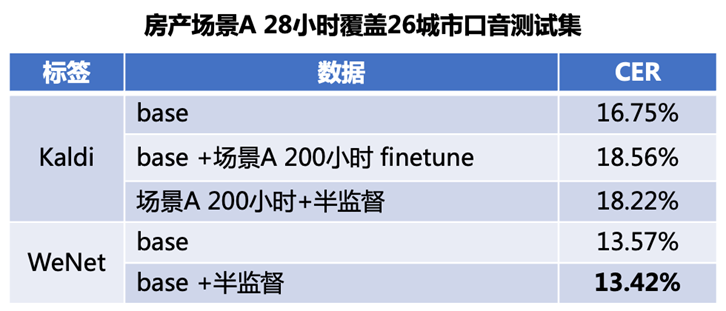
为了进一步验证半监督的效果,我们在另外两个线上测试集上进行了实验。针对房产场景A的26城口音测试集。我们使用WeNet生成的伪标签分别在Kaldi和WeNet模型上进行finetune,发现WeNet模型引入半监督训练后提升效果明显。
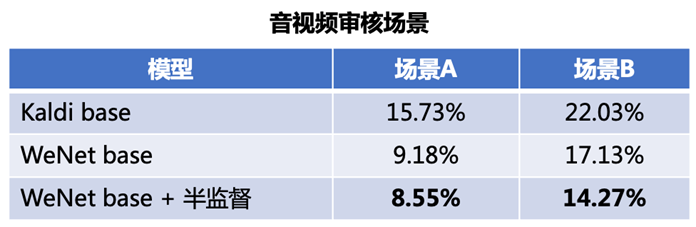
在音视频审核的两个场景中,WeNet base为300小时标注数据Finetune的模型,而在WeNet base的基础上引入1600小时伪标签半监督训练后,识别效果显著提升。
- 伪标签数据越多、Teacher 模型越好,则得到的Student模型效果越好。
- 半监督在新业务冷启动、数据积累较慢的业务场景优化可以起到显著的作用。
Efficient Conformer
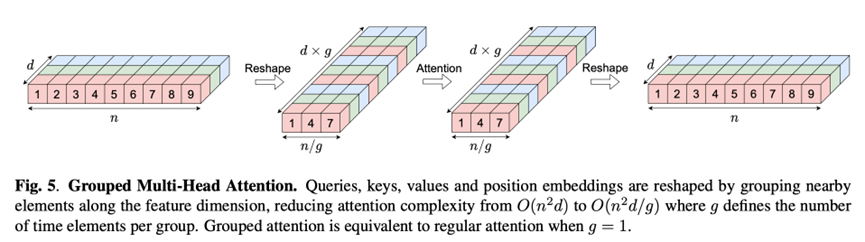
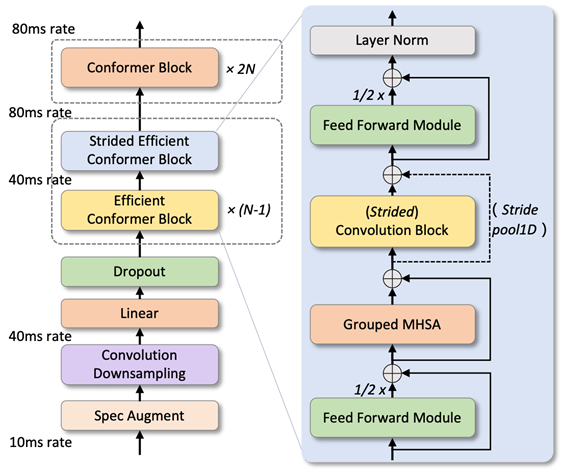
端到端语音识别模型的解码速度是模型能否落地的关键,特别是对于流式识别场景。经测试,WeNet CPU流式解码速度在并发测试下与Kaldi相比仍有约4倍左右的差距,而Encoder推理耗时占总解码时间的90%以上,因此优先考虑从模型的角度优化Encoder的推理耗时。Conformer的计算复杂度与输入音频序列的长度(帧数)相关,因此音频序列长度越长模型推理越慢,而降低序列长度直观的做法是跳帧或直接增加下采样倍数,但这通常会让识别效果损失严重。Efficient Conformer[3]的做法是在Conformer Block中实现下采样,在保证识别效果的前提下降低了计算复杂度。Efficient Conformer整体下采样倍数为1/8,其在Convolution Downsampling结构中实现1/2下采样,在Conformer层级中插入2个 1/2下采样的Downsampling Block。Downsampling Block与原始的Conformer Block相似,区别为增加了Grouped MHSA和Strided Convolution Block。Grouped MHSA分别在Attention矩阵乘法前后进行reshape,使得在Attention计算时序列长度得到压缩。Strided Convolution Block即为在原来Conformer Block基础上,调整Depthwise Convolution卷积步长,同时在残差连接时,对原始信号进行下采样。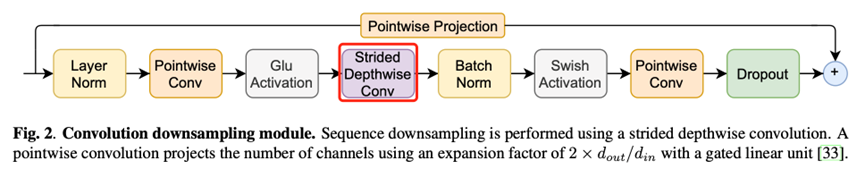
我们在Efficient Conformer的基础上做了调整,保留了原始Conformer的前置1/4下采样,并在模型层级的前1/3处做一次Downsampling Block的操作,最终实现1/8下采样,如下图所示。其中,Grouped MHSA和Strided Convolution Block保留了原始Efficient Conformer的设计。
我们选择外呼流式识别场景对Efficient Conformer进行了测试。在非流式模型中,使用WenetSpeech预训练模型的Conformer效果好于没有预训练初始化的模型,而Efficient Conformer识别效果好于预训练初始化的Conformer。Casual Efficient Conformer在流式模型中也表现最好,且int8量化后CER几乎没有影响。
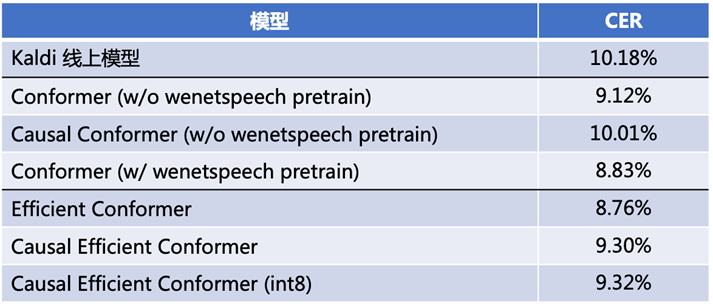
关于下采样带来的效果提升,在Squeezeformer[4]中有相关讨论,即网络特征表示在音频序列帧与帧之间存在冗余,在Squeezeformer中采用Temporal U-Net进行下采样也获得了显著的识别效果提升。接下来是各模型在CPU服务中1并发解码速度测试。在流式模型中Efficent Conformer带来了6.9%的速度提升,int8量化带来44.9%的速度提升。在非流式模型中Efficient Conformer带来13%的速度提升,int8量化带来的提升为 58%。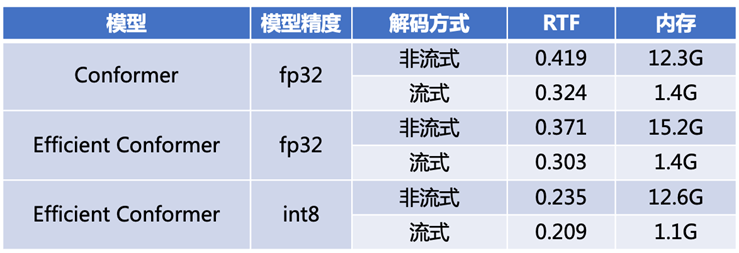
最终结论为,使用Efficient Conformer可以取得相对Conformer更好的识别效果,以及10%左右的推理速度提升。结合int8量化,可以取得50~70%的推理速度提升。最后值得注意的是,在使用了Grouped MHSA和Strided Convolution之后,流式解码时的chunk size需要设置为group size和stride的公倍数,保证在reshape和conv的过程中不会引入0的padding,从而导致识别效果受到影响。模型压缩
模型知识蒸馏方法[5]被广泛应用在模型压缩和迁移学习中,因此我们尝试使用训练好的大模型对压缩后的小模型进行蒸馏,以在保证识别效果的同时降低模型尺寸,从而提升模型推理速度。我们在WeNet的基础上实现了蒸馏的训练过程,如下图所示。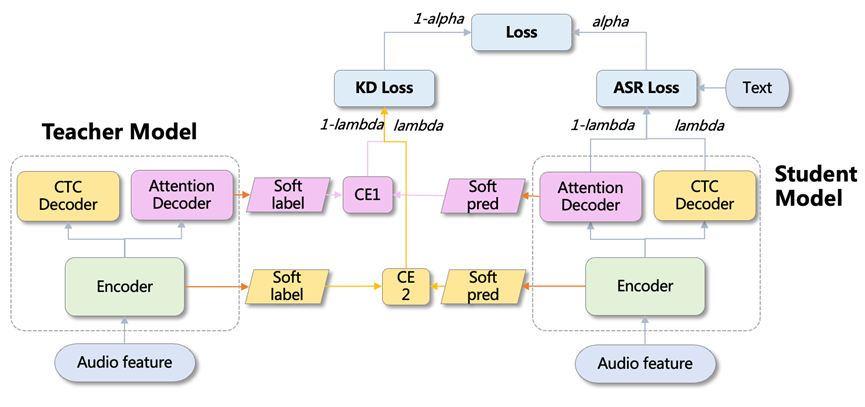
我们选取音视频审核场景的半监督训练Conformer模型作为Teacher 模型。为了确定模型的最佳压缩参数,我们使用Student模型在ASR任务上进行训练,最终确定参数如下:- encoder: 12elayer+8head+15kernels+2048FFUnits+512outputUnits
- decoder: 3dlayer+8head+2048FFUnits
- encoder: 12elayer+4head+7kernels+1024FFUnits+256outputUnits
- decoder: 3dlayer+4head+1024FFUnits
最后,相比直接蒸馏训练,先对Student做ASR任务的finetune后再做蒸馏的方式,模型收敛更加稳定,且最终识别效果更好。最终模型参数量减少为原来的 27.4%,CER绝对升高 3.19%。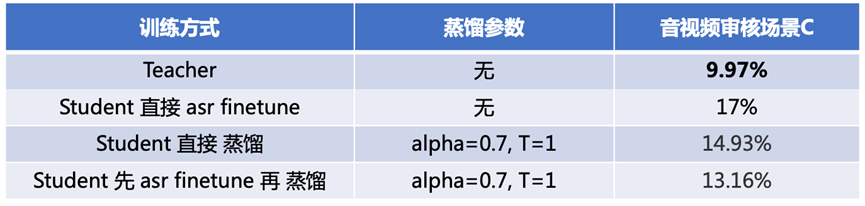
WeNet的部署方案
我们使用基于Libtorch部署的CPU服务支持流式识别场景,基于Triton的GPU服务支持非流式的录音文件识别场景。模型的部署在58同城AI Lab自研的WPAI人工智能平台上,分别构建WeNet的CPU和GPU解码镜像,上传至WPAI平台,即可实现模型的部署和后续迭代。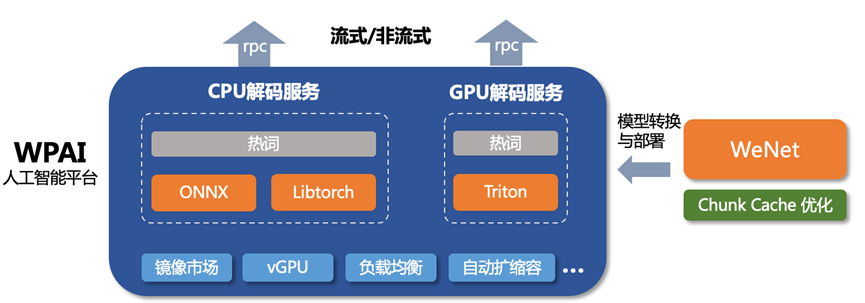
值得注意的是,由于Conformer base的流式识别需要额外的cache来记录“上一个”chunk的每层结果供当前chunk解码使用,而Efficient Conformer模型中使用了下采样,使得每层需要cache的序列长度不同。为此,我们在流式推理过程中记录下每层所需的实际长度,从而实现了Efficient Conformer的流式推理。此外,我们也分别在CPU和GPU解码器基础上实现了细粒度热词,以独立支持各业务之间的badcase修复。最后分别对CPU流式解码和GPU非流式解码进行了性能测试,可见在线上并发测试下WeNet CPU和GPU的解码性能表现很好,其中int8量化的Efficient Conformer在流式识别上的性能超过了Kaldi。- 模型:int8 精度的 Efficient Conformer
- 在服务最后一句话耗时 TP999<300ms 的要求下:
- WeNet CPU解码器能支持36并发,最佳实时率 0.0073
- Kaldi CPU支持16并发,最佳实时率 0.0119
单节点 WeNet CPU解码器(单节点40核)解码能力相较kaldi CPU解码器提升61%- 资源:GPU单卡T4、显存15G、CPU10核、内存20G
- 测试数据1:17824条音频片段,平均时长1.4s,最大17.6s,总时长6.9个小时,并发大于4个时,实时率为 0.009
- 测试数据2:3970条,片段平均长度5.5s,最大长度73s,总时6小时,并发大于4个时,实时率为 0.004
参考资料
[1]WeNet: https://github.com/wenet-e2e/wenet
[2]NST(Noisy Student Training): https://arxiv.org/pdf/2005.09629.pdf
[3]Efficient Conformer: https://arxiv.org/pdf/2109.01163.pdf
[4]Squeezeformer: https://arxiv.org/pdf/2206.00888.pdf[5]知识蒸馏方法: https://arxiv.org/pdf/1503.02531.pdf 
 语音小管家
