
AAAI 2026|KALL-E:基于下一分布预测的自回归语音合成

文本到语音(TTS)合成技术正处在一个由大语言模型(LLM)驱动的范式变革时代。目前,学界主流的“下一令牌预测”范式统一了语音生成的框架,但其依赖的“离散化”基石也带来了信息瓶颈、生成幻觉等固有缺陷。虽然已有研究开始转向连续语音表示,但又面…
44 0 0

文本到语音(TTS)合成技术正处在一个由大语言模型(LLM)驱动的范式变革时代。目前,学界主流的“下一令牌预测”范式统一了语音生成的框架,但其依赖的“离散化”基石也带来了信息瓶颈、生成幻觉等固有缺陷。虽然已有研究开始转向连续语音表示,但又面…


标题:《HPSU: A Benchmark for Human-Level Perception in Real-World Spoken Speech Understanding》 链接:https://arxiv.org/pdf/251…

NeurIPS(Neural Information Processing Systems)是每年十二月举行的机器学习与计算神经科学国际会议。会议汇集了来自学术界和工业界的顶尖研究人员,领域涵盖机器学习、神经网络、认知科学、计算机视觉,统计…


题目:《Advances in Speech Separation: Techniques, Challenges, and Future Trends》 地址:https://arxiv.org/pdf/2508.10830 先从摘要说起…


随着以智能助手为代表的人机语音对话系统和会议转录与纪要等应用的爆发,对话语音识别(Conversational ASR) 技术变得愈发重要。对话语音(Conversational Speech)具有高度的上下文(Context)相关性,而擅…
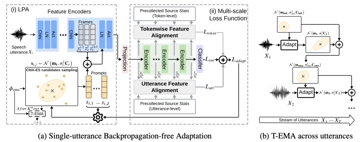
⏩背景:真实场景中的语音模型为何会“失灵”? 当前的大型语音基础模型(Speech Foundation Models, SFMs),如Wav2Vec2、HuBERT,在干净数据上表现极佳,但在真实世界中经常碰到噪声、口音、麦克风差异等“声…

近年来,以思维链(Chain-of-Thought)为代表的扩展推理技术,在文本和视觉领域取得了巨大成功。然而,在音频领域,一个令人困惑的现象始终存在:音频语言模型似乎无法从思维链中受益,甚至表现出“想得越多,错得越多”的“反常缩放”现象。…
