
 语音小管家
⏩背景:真实场景中的语音模型为何会“失灵”?
当前的大型语音基础模型(Speech Foundation Models, SFMs),如Wav2Vec2、HuBERT,在干净数据上表现极佳,但在真实世界中经常碰到噪声、口音、麦克风差异等“声学域偏移”导致准确率下降。
为解决这一问题,“Test-Time Adaptation (TTA)”成为热门方向:模型在推理阶段仅需要无标签数据,即可对环境变化进行实时自适应调整。
⏩E-BATS:首个面向语音基础模型的无反向传播TTA框架
E-BATS(Efficient Backpropagation-Free Test-Time Adaptation for Speech Foundation Models)是首个专为语音模型设计的“完全无反向传播”的测试时自适应方法。
仅通过forward pass即可完成模型适应,大幅降低显存使用,同时保持甚至超越传统TTA的性能。
论文:
代码:https://github.com/JiahengDong/E-BATS
⏩E-BATS的三大核心创新
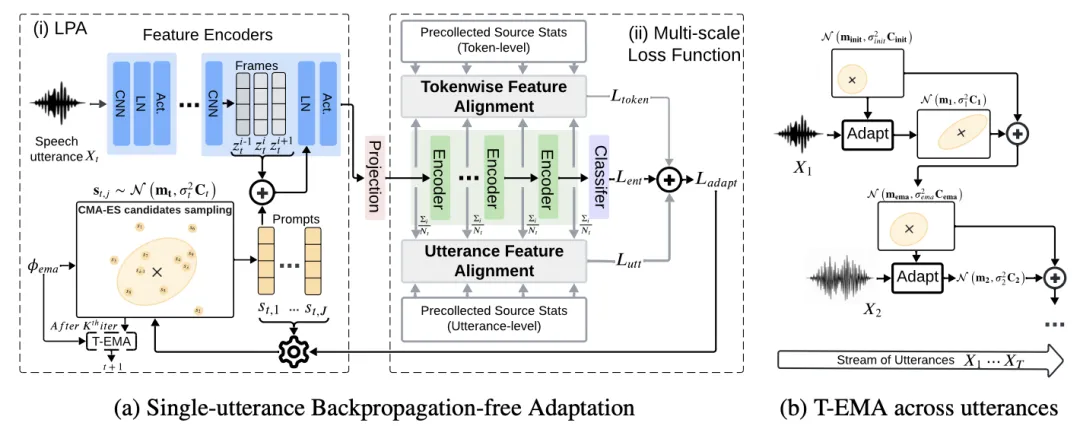
1.轻量Prompt适配(Lightweight Prompt Adaptation)
不改模型参数,只在CNN编码器的隐空间注入一个小prompt vector,直接“平移”噪声条件下的特征,使其更接近干净语音的分布。
2.多尺度(Multi-scale)对齐损失函数
为了确保适配稳定可靠,团队同时对齐三类信息:
全局:整句话的分布中心(utterance-level)
局部:每帧对应token的特征(token-level)
预测置信度:基于熵minimization,过滤无效帧
3.跨语句T-EMA平滑机制
测试时指数滑动平均(Test-time EMA)使prompt的搜索更加稳定,防止“适应一次、忘一次”的灾难性遗忘。
⏩效果:更准、更稳、更省显存
在4个数据集、16种声学条件上进行了系统评测,结果显示:
比所有BP-free方法准确率提升4.1%–13.5%
显存节省2.0×–6.4×(相较BP-based TTA)
在大模型(HuBERT-Large)上依旧保持强势性能
尤其在高噪声(σ=0.02)环境下,E-BATS的提升高达20% WER相对改进。
⏩为什么E-BATS特别适合语音模型?
语音是序列任务,而不是单一图像→需要更细粒度的局部对齐
单句处理(batch=1)导致传统TTA不稳定
模型结构包含CNN + Transformer,与视觉模型完全不同
E-BATS是第一个专门针对这些特性设计的BP-free TTA框架。
⏩应用前景:Edge-devices也能用的自适应语音系统
E-BATS显著减少显存消耗,使测试时自适应首次真正具备“在现实中可部署”的可能性,包括:
噪声下的智能语音助理
移动端ASR
可穿戴设备语音交互
