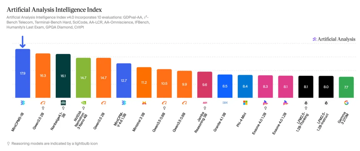
AI 制造 AI:全球首个完全由 AI 编写的生产级训练框架 ForgeTrain 发布并开源

近日,清华大学自然语言处理与社会人文计算实验室与面壁智能、OpenBMB 开源社区正式发布ForgeTrain——全球首个完全由 AI 编写、零人类代码介入的生产级大模型训练框架。 它不是一个实验原型,而是一套可以直接投入生产、创造价值的“…
45 0 0

近日,清华大学自然语言处理与社会人文计算实验室与面壁智能、OpenBMB 开源社区正式发布ForgeTrain——全球首个完全由 AI 编写、零人类代码介入的生产级大模型训练框架。 它不是一个实验原型,而是一套可以直接投入生产、创造价值的“…

论文链接:https://arxiv.org/abs/2605.27258 项目主页:https://amapvoice.github.io/PilotTTS/ GitHub Repo:https://github

上海交通大学 X-LANCE 实验室与小米联合发布的 Dasheng AudioGen,不再独立建模语音、音乐、音效生成任务,而是让 AI 像“声音导演”一样理解真实世界音频中多种声音的复杂关系,并端到端生成自然、协调的混合音频场景。 在线…

来源丨清华大学自然语言处理与社会人文计算实验室 昨日,清华大学自然语言处理与社会人文计算实验室与面壁智能、OpenBMB 开源社区正式发布并开源最新一代端侧文本基座大模型——MiniCPM5-1B。 MiniCPM5-1B 再次刷新模型的智…

近年来,以Suno、Mureka、YuE、ACE-Step 等为代表的音乐生成模型迅速演进,其输入条件已经从单一的文本描述,扩展为文本、歌词与参考音频任意组合的多模态指令。然而,用来判断「单条生成结果到底好不好」的评测手段,却相对滞后:传统…


它听得懂情绪、辨得出身份、甚至能模仿你说话——但你敢信任它吗? “你今天看起来有点累。”当你对手机说出这句话,它不仅能听懂字面意思,还能从你的语速、语调、呼吸节奏中判断——你是真的疲惫,还是在强撑?这不是科幻。这是大型音频语言模型正在实现的…
本期分享国防科技大学近期被IEEE Transactions on Audio, Speech and Language Processing接收的音频表示质量评估方面的工作。 Unifying Variables in Neural Sc…

